🔖 キーワード索引
「微分」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
「differentiation」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「differentiation」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「differentiation の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論 — 微分
🍰 まずはやさしく
微分は瞬間の変化を測る道具です。
グラフの傾きを知るために使います。
スマホのアプリの学習に役立っています。
まずは結論と重要なルールを読みましょう。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- 微分=関数の「瞬間の変化率」を求める数学的操作。 グラフの接線の傾き。
- 公式:$\frac{df}{dx} = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h}$。
- 機械学習の基盤:勾配降下法は損失関数を微分して下る方向に重みを更新。
- 重要ルール:連鎖律(合成関数)、 積の微分、 商の微分。
- 偏微分=多変数関数で 1 つの変数だけ動かす微分。 ニューラルネットの誤差逆伝播の核。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
微分はAIが答えを探すための地図です。
間違いを最小にするために使います。
データの分析で正解に近づく時に使います。
計算のやり方と使い道を学びましょう。
「損失が最小になる重みを探す」 — ニューラルネットも回帰も、 突き詰めれば 微分を計算して降りていく作業。 微分を知らずに ML は語れません。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
本ページでは SSDSE-B-2026 の実データ(2023 年度の総人口 vs 出生数)と合成データの双方を例に、 損失 $L(\beta) = \sum (y_i - \beta x_i)^2$ の勾配 $\nabla L$ を数値微分・SymPy 記号微分・PyTorch 自動微分の 3 通りで求め、 値が整合することを確認する。
「differentiation」は 関数の局所的変化率 (傾き) を求める操作で、 $f'(x) = \lim_{h \to 0} \frac{f(x+h)-f(x)}{h}$ と定義される。 ML では損失関数の勾配 $\nabla L(\theta)$ を計算するための基礎であり、 chain rule (連鎖律) を通じて backpropagation を駆動する。 本ページでは数値微分・記号微分・自動微分 (forward / reverse mode) の 3 系統を扱う。
🎨 直感で掴む
🍰 まずはやさしく
微分は車の速度計のようなものです。
ある瞬間の速さを知るために使います。
坂道の急さを考える時に似ています。
グラフの傾きと最適化について考えましょう。
車の速度計に喩えると:
- 位置 $x(t)$ = 走行距離
- 速度 $\frac{dx}{dt}$ = 位置の微分 = 瞬間の速さ
- 加速度 $\frac{d^2x}{dt^2}$ = 2 階微分
関数のグラフで考えると、 微分はその点での 接線の傾き。 山の頂上では傾き 0(極大)、 谷底でも傾き 0(極小)— だから「微分 = 0 を解いて最適化」できるわけです。
📐 定義・数式
🍰 まずはやさしく
微分は数式で表した計算ルールです。
正確な変化量を出すために使います。
テストで習う関数の計算と同じです。
定義と基本の公式を確認しましょう。
🔬 記号・要素の読み解き
- $f'(x)$
- $x$ における瞬間変化率。 接線の傾き。
- 偏微分 $\partial f / \partial x_i$
- 他の変数を固定し、 $x_i$ だけで微分。
- 勾配 $\nabla f$
- 偏微分を並べたベクトル。 「最も速く増える方向」を指す。
- 連鎖律
- 「外側の微分 × 内側の微分」。 NN の逆伝播はこれを層ごとに適用。
- 極値条件
- 最大・最小では $f'(x) = 0$。 さらに 2 階微分で凸/凹を判定。
🔬 数式を言葉で読み解く(詳細版)
「微分」は 瞬間の変化率 を求める数学の中核操作です。 機械学習の勾配降下法、 物理の運動方程式、 経済の限界費用、 統計の MLE — どれも微分が裏方にいます。 ここでは定義式・公式・データへの当てはめを段階的に解きほぐします。
① 微分の定義(極限)
- $f(x)$
- 微分したい関数。 例:$x^2$, $\sin x$, $e^x$, $\log x$。
- $h$
- $x$ の微小変位。 「ほぼゼロだけれどゼロではない」量。
- $f(x+h) - f(x)$
- 関数値の変化量。 縦の動き。
- $\frac{f(x+h)-f(x)}{h}$
- 平均変化率(差分商)。 区間 $[x, x+h]$ の傾き。
- $\lim_{h \to 0}$
- $h$ を限りなく 0 に近づける。 接線の傾きに収束。
② 基本公式 8 種
| $f(x)$ | $f'(x)$ | 覚え方 |
|---|---|---|
| $c$(定数) | $0$ | 傾きゼロ |
| $x^n$ | $n x^{n-1}$ | 「下ろして 1 引く」 |
| $e^x$ | $e^x$ | 不変。 指数の魔法 |
| $\log x$ | $1/x$ | 逆数 |
| $\sin x$ | $\cos x$ | 位相が 90° 進む |
| $\cos x$ | $-\sin x$ | マイナス付き |
| $f(x)g(x)$ | $f'g + fg'$ | 積の法則 |
| $f(g(x))$ | $f'(g(x)) g'(x)$ | チェーンルール |
③ 偏微分と勾配
④ 勾配降下法
SSDSE-B-2026 で「微分」を体感する
SSDSE-B-2026 の「総人口」を 2012〜2023 年の時系列とみなせば、 各年の変化率(微分の離散版)を計算できます。 例:東京都の総人口は 2012 年 13,234,000 人 → 2023 年 14,086,000 人。 平均年率 $(14086000 - 13234000) / 11 = 77,455$ 人/年。 これが離散微分(前方差分)の値。
🏭 産業界での活用事例(6 件)
| 業界 | 事例 | 微分の役割 | SSDSE-B-2026 との対比 |
|---|---|---|---|
| 機械学習 | ニューラルネットの誤差逆伝播 | 損失関数の勾配で重み更新 | SSDSE-B で線形回帰の学習が体験可 |
| 金融工学 | オプション価格の Black-Scholes 方程式 | 偏微分方程式を解く | 株価ボラティリティ=対数収益率の標準偏差 |
| 物理学 | 運動方程式 $F = m a = m \frac{dv}{dt}$ | 位置→速度→加速度の連鎖微分 | 人口の「速度」=前年差、 「加速度」=差分の差分 |
| 制御工学 | 自動車・ロボットの PID 制御 | 「D」が誤差の微分(変化速度) | 人口減少の「ペース」を制御変数に |
| 経済学 | 限界費用・限界効用 | 「もう 1 単位生産したらいくら増える?」 | 1 人増えたら GDP がいくら増える? |
| 統計学 | 最尤推定 MLE(対数尤度の微分=0) | パラメータ推定の最適化 | SSDSE-B で正規分布の MLE 演習可 |
⚖️ 関連手法との比較表
| 手法 | 定義 | 計算方法 | 用途 | 限界 |
|---|---|---|---|---|
| 記号微分 | 公式に基づく代数的微分 | SymPy, Mathematica | 厳密解、 教育 | 関数が複雑だと爆発 |
| 数値微分 | 差分商 $\frac{f(x+h)-f(x-h)}{2h}$ | NumPy 1 行 | 関数式が無い場合 | 誤差が $h$ に敏感 |
| 自動微分(AD) | 計算グラフを辿る厳密微分 | PyTorch, JAX, TensorFlow | 機械学習(標準) | メモリ消費大 |
| 偏微分 | 1 変数のみ動かす微分 | $\partial f/\partial x_i$ | 多変数最適化 | 全変数の相互作用は別途 |
| 方向微分 | 任意方向 $\mathbf{v}$ への変化率 | $\nabla f \cdot \mathbf{v}$ | 等高線・最急降下 | $\mathbf{v}$ の選び方が肝 |
| 2 階微分 | $f''(x) = \frac{d^2 f}{dx^2}$ | Hessian 行列 | 凸性判定、 ニュートン法 | 計算コスト $O(n^2)$ |
| 離散差分 | $\Delta f(x) = f(x+1) - f(x)$ | pandas diff() | 時系列、 SSDSE-B 解析 | 細かい変動を見落とす |
💥 失敗例から学ぶ
requires_grad=False のテンソルを最適化対象にtensor.requires_grad_(True) で有効化。📝 演習問題(5 問・解答付き)
- 問題:SSDSE-B-2026 の東京都「総人口」を 2012〜2023 で読み込み、 前年差を Pandas で計算せよ。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 Prefecture(都道府県) SSDSE-B-2026(年度) A1101(総人口) 北海道 北海道 2,023 5,092,000 東京都 東京都 2,023 14,086,000 沖縄県 沖縄県 2,023 1,468,000 …(全 47 行)1 2 3 4 5
import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) tokyo = df[df['都道府県']=='東京都'].sort_values('年度') tokyo['前年差'] = tokyo['総人口'].diff() print(tokyo[['年度','総人口','前年差']])
📤 実行例(実測) 年度 総人口 前年差 155 2012 13234000 NaN 154 2013 13307000 73000.0 153 2014 13399000 92000.0 152 2015 13515271 116271.0 151 2016 13646000 130729.0 150 2017 13768000 122000.0 149 2018 13887000 119000.0 148 2019 14007000 120000.0 147 2020 14047594 40594.0 146 2021 14010000 -37594.0 145 2022 14038000 28000.0 144 2023 14086000 48000.0→ 2012→2013 は +70,000 人前後、 コロナで 2020→2021 はマイナスに転じる。 - 問題:$f(x) = x^2 + 3x + 5$ の $x=2$ での微分値を、 (a) 公式で、 (b) 数値微分で計算せよ。
▼ 解答
公式:$f'(x) = 2x + 3$、 $f'(2) = 7$。 数値:$h=10^{-5}$ で $(f(2+h)-f(2-h))/(2h) \approx 7.0000$。 - 問題:PyTorch で $f(x) = x^2$ の $x=3$ での勾配を自動微分で求めよ。
▼ 解答
1
2
3
4
5
import torch x = torch.tensor(3.0, requires_grad=True) y = x**2 y.backward() print(x.grad) # → tensor(6.)
📤 実行例(実測) tensor(6.) - 問題:SSDSE-B-2026 の「総人口」と「出生数」の線形回帰モデル $y = wx + b$ を勾配降下法で学習せよ(手書き)。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 SSDSE-B-2026(年度) A1101(総人口) A4101(出生数) 北海道 2,023 5,092,000 24,430 東京都 2,023 14,086,000 86,348 沖縄県 2,023 1,468,000 12,549 …(全 47 行)1 2 3 4 5 6 7 8 9 10 11 12
import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) d = df[df['年度']==2023] x = d['総人口'].values / 1e7 # スケーリング y = d['出生数'].values / 1e5 w, b = 0.0, 0.0 for _ in range(2000): yp = w*x + b err = yp - y w -= 0.01 * np.mean(err * x) b -= 0.01 * np.mean(err) print(f"w={w:.4f}, b={b:.4f}") # w ≈ 0.47, b ≈ 0.03 付近(さらに反復すると OLS 解 w ≈ 0.61 へ収束)
📤 実行例(実測) w=0.4742, b=0.0320 - 問題:$f(x,y) = x^2 + 2y^2$ の点 $(1, 1)$ での勾配ベクトルを求めよ。
▼ 解答
$\partial f/\partial x = 2x = 2$、 $\partial f/\partial y = 4y = 4$。 $\nabla f(1,1) = (2, 4)^\top$。 最急上昇方向は $(2,4)/\|(2,4)\| = (0.447, 0.894)$。
📖 関連用語辞典(10 語)
- 導関数
- $f'(x)$、 関数 $f$ を $x$ で微分して得られる新しい関数。
- 偏微分
- 多変数関数を 1 変数だけ動かして微分。 $\partial f/\partial x_i$。
- 勾配(gradient)
- 偏微分を並べたベクトル。 関数の最急上昇方向。
- ヘッセ行列(Hessian)
- 2 階偏微分の行列。 凸性判定、 ニュートン法に使用。
- チェーンルール
- 合成関数 $f(g(x))$ の微分は $f'(g(x)) g'(x)$。 NN 逆伝播の基礎。
- 自動微分(AD)
- 計算グラフを辿って厳密微分を機械的に行う技術。 PyTorch / JAX。
- 勾配降下法(GD)
- $\theta \leftarrow \theta - \eta \nabla L$。 最適化の基本アルゴリズム。
- 確率的勾配降下法(SGD)
- ミニバッチでの勾配近似。 大規模学習で標準。
- Adam
- 適応的学習率の最適化。 1 次・2 次モーメントを使用。
- 劣勾配
- 微分不可能点での勾配の一般化。 ReLU や L1 正則化で使う。
🔬 SSDSE-B-2026 で「微分の総合演習」
演習:東京都の人口時系列を微分でしゃぶり尽くす
🎯 やること:東京都の 2012-2023 年の総人口データに対し、 (a) 線形トレンド傾き、 (b) 1 次離散微分、 (c) 2 次離散微分、 (d) 対数微分(成長率)を計算し、 統合的に「東京都の人口動態」を解釈する。
📥 入力:SSDSE-B-2026 の東京都データ(12 行)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) tokyo = df[df['都道府県']=='東京都'].sort_values('年度').reset_index(drop=True) # (a) 線形トレンド傾き p = np.polyfit(tokyo['年度'], tokyo['総人口'], 1) print(f"(a) 線形トレンド傾き: {p[0]:,.0f} 人/年") # (b) 1 次離散微分(前年差) tokyo['前年差'] = tokyo['総人口'].diff() print(f"(b) 平均前年差: {tokyo['前年差'].mean():,.0f} 人/年") # (c) 2 次離散微分(加速度) tokyo['加速度'] = tokyo['前年差'].diff() print(f"(c) 平均加速度: {tokyo['加速度'].mean():,.0f} 人/年²") # (d) 対数微分(年率成長率) tokyo['年率'] = tokyo['総人口'].pct_change() * 100 print(f"(d) 平均年率: {tokyo['年率'].mean():.3f}%/年") print(f"\n最大増加年: {tokyo.loc[tokyo['前年差'].idxmax(), '年度']}") print(f"最大減少年: {tokyo.loc[tokyo['前年差'].idxmin(), '年度']}") |
📤 実行結果:
💬 結果の読み方:(a) と (b) はほぼ同じ値(最小二乗回帰 ≒ 平均離散微分)。 加速度が負=増加ペースは年々鈍化。 年率 0.57% は穏やかな増加。 最大増加は 2016 年(+130,729 人)、 最大減少は 2021 年(コロナ転出の影響)。 微分の各概念が「人口動態の物語」として読める。
📓 「微分」をさらに深掘り — 実データ実践ノート
∂ SSDSE-B-2026 の構造を「微分」視点で再点検
SSDSE-B-2026(独立行政法人統計センター、 CC BY 4.0)は 47 都道府県 × 2012-2023 年 = 564 行 × 112 列の表データです。 「微分」の観点でこのデータを見ると、 以下のような切り口が現れます:
- 2023 年都道府県別人口 TOP 5:東京都 14,086,000 人、 神奈川県 9,229,000 人、 大阪府 8,763,000 人、 愛知県 7,477,000 人、 埼玉県 7,331,000 人
- 2023 年都道府県別出生数 TOP 5:東京都 86,348 人、 神奈川県 53,991 人、 大阪府 55,292 人、 愛知県 48,402 人、 埼玉県 42,108 人
- 合計特殊出生率 TOP 3:沖縄県 1.60、 長崎県 1.49、 宮崎県 1.49(2023 年)
- 全国 2023 年合計:124,353,000 人、 727,269 人出生、 474,741 件婚姻、 183,814 件離婚
- 12 年間の変化:全国総人口は 2012 年 127.6 百万人台から 2023 年 124.4 百万人台へ。 平均年率 -0.23% の緩やかな減少
∂ 「微分」をテーマにした SSDSE-B-2026 分析シナリオ(10 件)
| # | シナリオ | 主要な「微分」要素 |
|---|---|---|
| 1 | 全 47 都道府県の 2023 年人口を読み込み、 上位 5 県を抽出 | 勾配・最適化・接線・変化率 |
| 2 | 2012→2023 の人口変化率を計算、 増加県・減少県をランキング | 勾配・最適化・接線・変化率 |
| 3 | 合計特殊出生率と婚姻率の散布図、 相関係数を計算 | 勾配・最適化・接線・変化率 |
| 4 | 気温(最高・最低)と出生率の関係を分析 | 勾配・最適化・接線・変化率 |
| 5 | 地方ブロック(北海道〜九州)単位の集計と分布比較 | 勾配・最適化・接線・変化率 |
| 6 | 年度別全国合計の時系列で移動平均・トレンド推定 | 勾配・最適化・接線・変化率 |
| 7 | 転入超過率(転入÷総人口)の都道府県マップ可視化 | 勾配・最適化・接線・変化率 |
| 8 | 離婚率と婚姻率の比、 都道府県差の要因探索 | 勾配・最適化・接線・変化率 |
| 9 | k-means で都道府県を 5 群にクラスタリングし特徴抽出 | 勾配・最適化・接線・変化率 |
| 10 | 主成分分析で 112 列を 2 次元に圧縮、 可視化 | 勾配・最適化・接線・変化率 |
∂ SSDSE-B-2026 の主要指標一覧(活用しやすい列)
| 列コード | 列名 | 2023 年範囲 | 「微分」との関わり |
|---|---|---|---|
| A1101 | 総人口 | 537,000(鳥取)〜 14,086,000(東京) | 規模感の基本指標 |
| A4101 | 出生数 | 3,263(鳥取)〜 86,348(東京) | 未来人口の供給源 |
| A4103 | 合計特殊出生率 | 0.99(東京)〜 1.60(沖縄) | 少子化政策の核心指標 |
| A9101 | 婚姻件数 | 1,810(鳥取)〜 71,774(東京) | 家族形成の基盤 |
| A9201 | 離婚件数 | — | 家族解体の指標 |
| B4101 | 年平均気温 | 11.0(北海道)〜 23.8(沖縄) | 気候要因の代表 |
| B4102 | 最高気温(月平均最高値) | 30.9(北海道)〜 35.8(富山) | 夏の極値 |
| B4103 | 最低気温(月平均最低値) | -7.4(北海道)〜 14.9(沖縄) | 冬の極値 |
| E4401 | 高等学校教員数 | — | 教育インフラ規模 |
| E7201 | 専修学校生徒数 | — | 専門教育の規模 |
∂ Python 3 段階分析テンプレート — 「微分」視点で SSDSE-B-2026
段階 1:データロード + 概要把握
🎯 やること:SSDSE-B-2026 を pandas で読み込み、 列数・行数・型を確認。 「微分」の議論に必要なメタデータ(CC BY 4.0、 47 都道府県、 12 年分)を出力。
📥 入力:data/raw/SSDSE-B-2026.csv(CP932 エンコーディング)
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(f"行数: {len(df):,} / 列数: {len(df.columns):,}") print(f"年度範囲: {df['年度'].min()}-{df['年度'].max()}") print(f"都道府県数: {df['都道府県'].nunique()}") print(f"出典: 独立行政法人統計センター. SSDSE-B-2026 (CC BY 4.0)") |
📤 出力:
💬 解説:564 = 47 × 12 で完全一致=欠損レコードなし。 112 列の指標を「微分」の文脈で取捨選択していくのが次段階。
段階 2:「微分」関連列の抽出と統計
🎯 やること:47 都道府県の 2023 年データから、 「微分」の議論に直結する主要指標を抽出し、 統計値を算出。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] key_cols = ['都道府県','総人口','出生数','合計特殊出生率','婚姻件数','離婚件数'] summary = d[key_cols].describe() print(summary.round(2)) |
📤 出力:
💬 解説:平均人口 265 万人、 出生数平均 15,474 人、 合計特殊出生率は 0.99〜1.60 の範囲(平均 1.29)。 「微分」の議論で「集中・格差」を語るときの基準数値群。
段階 3:「微分」テーマの実証分析(散布図・相関)
🎯 やること:47 都道府県の「総人口」と「出生数」の散布、 相関係数で「微分」の論点を数値化。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from scipy.stats import pearsonr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] r, p = pearsonr(d['総人口'], d['出生数']) print(f"総人口 vs 出生数: r = {r:.4f}, p = {p:.2e}") r2, p2 = pearsonr(d['総人口'], d['合計特殊出生率']) print(f"総人口 vs 合計特殊出生率: r = {r2:.4f}, p = {p2:.2e}") |
📤 出力:
💬 解説:(a) 「総人口」と「出生数」は超強い正の相関 r=0.995(人口が多いほど出生数も多い、 ほぼ比例)。 (b) 一方「総人口」と「合計特殊出生率」は中程度の負の相関 r=-0.56(大都市ほど一人当たり出生率は低い)。 「微分」を論じるなら、 (b) の発見「都市集中が出生率低下を伴う」が大きな論点。
∂ 「微分」の議論で出会う 30 のよくある質問への一文回答
| # | 質問 | SSDSE-B-2026 を踏まえた回答 |
|---|---|---|
| 1 | 東京都の総人口は? | 2023 年 14,086,000 人 |
| 2 | 最も人口の多い県は? | 東京都(次いで神奈川県、 大阪府) |
| 3 | 最も人口の少ない県は? | 鳥取県 537,000 人 |
| 4 | 出生数最大は? | 東京都 86,348 人 |
| 5 | 出生数最小は? | 鳥取県 3,263 人 |
| 6 | 合計特殊出生率最大は? | 沖縄県 1.60 |
| 7 | 合計特殊出生率最小は? | 東京都 0.99(1.0 を割る唯一の県) |
| 8 | 全国 2023 年の総人口 | 124,353,000 人(47 県合計) |
| 9 | 全国 2023 年の出生数 | 727,269 人 |
| 10 | 12 年間で増加した県は? | 東京・神奈川・愛知・福岡・沖縄など |
| 11 | 12 年間で最も減少した県は? | 北海道、 秋田、 青森、 高知などの地方圏 |
| 12 | 1 県あたり平均人口 | 2,645,809 人 |
| 13 | 人口の中央値 | 1,549,000 人 |
| 14 | 人口の標準偏差 | 2,797,551 人(分布が広い) |
| 15 | 年平均気温最高は? | 沖縄県 23.8°C |
| 16 | 年平均気温最低は? | 北海道 11.0°C |
| 17 | 東京都の合計特殊出生率の意味 | 女性 1 人あたり生涯出生数 0.99 人 |
| 18 | 少子化の判定基準は? | 人口置換水準 2.07 を下回ると将来減少 |
| 19 | 関東地方の合計人口 | 43,527,000 人(全国の 35.0%) |
| 20 | 近畿地方の合計人口 | 21,990,000 人 |
| 21 | SSDSE-B-2026 のライセンス | CC BY 4.0(出典明記で自由利用可) |
| 22 | SSDSE-B-2026 の出典 | 独立行政法人統計センター |
| 23 | データ取得元 | e-Stat(政府統計の総合窓口) |
| 24 | 「微分」を学ぶときの代表書籍 | 分野標準教科書 + 公的統計入門書 |
| 25 | SSDSE-B と SSDSE-A の違い | B は都道府県別、 A は市区町村別 |
| 26 | 列数 110 は何を含む? | 人口・出生・気候・経済・教育・住宅など多分野 |
| 27 | 分析の出発点 | describe()、 head()、 isnull().sum() |
| 28 | 欠損値はある? | 列によってあり(要確認) |
| 29 | SSDSE-B 全体のサイズ | 約 360 KB(CSV ファイル) |
| 30 | 毎年更新される? | 毎年最新版が公表(SSDSE-B-2025, 2024, 2023, ...) |
∂ 「微分」を学ぶ次の一歩:関連用語マップ
「微分」を起点に、 関連する用語を体系的に学ぶための地図:
- 前提知識:Python 基礎、 pandas、 数学(高校レベル)、 統計入門
- 並列概念:同じ分野の兄弟用語、 同レベルの選択肢
- 応用・発展:「微分」を踏まえた次のステップ
- ツール・ライブラリ:scikit-learn、 PyTorch、 SQLAlchemy、 SQLite など
🌟 SSDSE-B-2026 ハンズオン詳細:「微分」で読み解く 12 年間の変動
年度別ハイライト
| 年 | 全国総人口 | 東京都人口 | 出来事 |
|---|---|---|---|
| 2012 | 約 127.6M | 13,234,000 | — |
| 2013 | 約 127.4M | 13,307,000 | 2020 五輪招致決定 |
| 2014 | 約 127.2M | 13,399,000 | 消費税 8% へ |
| 2015 | 約 127.1M | 13,515,271 | マイナンバー制度開始 |
| 2016 | 約 127.0M | 13,646,000 | — |
| 2017 | 約 126.9M | 13,768,000 | — |
| 2018 | 約 126.7M | 13,887,000 | — |
| 2019 | 約 126.6M | 14,007,000 | 消費税 10% へ |
| 2020 | 約 126.1M | 14,047,594 | COVID-19 パンデミック、 五輪延期 |
| 2021 | 約 125.5M | 14,010,000 | 東京転出超過、 五輪開催 |
| 2022 | 約 124.9M | 14,038,000 | — |
| 2023 | 約 124.4M | 14,086,000 | コロナ規制緩和、 訪日復活 |
「微分」の 12 年動向 — 数値で読む
SSDSE-B-2026 の 12 年スパンで、 「微分」に関連する主要指標がどう変動したかを数値で把握することは、 ジャストインタイム型データサイエンス教育の核心です。 上の表からは、 (a) 全国総人口は緩やかに減少傾向(2012 → 2023 で -3.2M)、 (b) 東京都は依然として増加(13.2M → 14.1M)、 (c) コロナ期 2020-2021 に転出超過の局面が一度生じた、 などが読み取れます。
12 年スパンでの「微分」関連指標の年率変化
| 指標 | 2012 値 | 2023 値 | 年率 |
|---|---|---|---|
| 全国総人口 | 約 127,589,000 | 124,353,000 | -0.23%/年 |
| 東京都人口 | 13,234,000 | 14,086,000 | +0.57%/年 |
| 全国出生数 | 約 1,037,165 | 727,269 | -3.2%/年 |
| 全国合計特殊出生率 | 1.46 | 1.29 | -1.1%/年 |
| 全国婚姻件数 | 約 668,870 | 474,741 | -3.1%/年 |
∂ 「微分」を学ぶ統合まとめ
SSDSE-B-2026(CC BY 4.0)は、 (1) 47 都道府県という全数調査、 (2) 12 年の縦断データ、 (3) 112 列の多次元指標、 という 3 拍子揃った教育用素材です。 「微分」の議論を進めるとき、 抽象的な定義だけでなく、 こうした実データへの適用を通じて初めて「分かる」「使える」「説明できる」状態になります。 ぜひ pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) の 1 行から始めてください。
🧮 実値で計算してみる
$f(x) = x^2$ を微分すると $f'(x) = 2x$。 これを使った勾配降下:
| step | x | f(x) | f'(x) |
|---|---|---|---|
| 0 | 5.0 | 25.0 | 10.0 |
| 1 | 3.0 | 9.0 | 6.0 |
| 2 | 1.8 | 3.24 | 3.6 |
学習率 0.2 で x ← x − 0.2 · 2x を繰り返すと、 x は 0(最小値)に近づきます。
🧮 数式に値を入れて手で計算する: 数値微分で f'(x)
f(x) = x³ - 2x² + 5 の数値微分を中心差分で計算し、 解析解と比較する。
Step 1: 解析解
Step 2: 中心差分 (h=0.01)
🐍 Python で再現
1 2 3 4 5 6 7 | def f(x): return x**3 - 2*x**2 + 5 h = 0.01 x = 2 num = (f(x+h) - f(x-h)) / (2*h) ana = 3*x**2 - 4*x print(f"数値微分: {num:.4f}") print(f"解析解: {ana}") |
📤 実行結果
💬 手計算 (Step 2) 4.000 と Python 出力が完全一致。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 | import sympy as sp x = sp.symbols('x') f = x**3 - 3*x + 1 df = sp.diff(f, x) # 導関数 print('f\'(x) =', df) # 数値微分 import numpy as np def num_diff(f, x, h=1e-6): return (f(x+h)-f(x-h))/(2*h) print(num_diff(lambda x: x**3-3*x+1, 2.0)) |
補足:ライブラリのバージョンや前処理状態によって出力は変わります。 自分の環境で動かすときは pip list でバージョンを確認し、 入力 CSV のパス・列名を実態に合わせてください。
🐍 Python 完全コード(4 要素ナレーション付き)
コード 1:SSDSE-B-2026 で「離散微分」を可視化
🎯 このコードでやること:東京都の総人口(2012-2023)を pandas で読み込み、 前年差(離散微分)と前年差の差(2 階離散微分=加速度)を計算する。
📥 入力データ:
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) tokyo = df[df['都道府県']=='東京都'].sort_values('年度').reset_index(drop=True) tokyo['前年差'] = tokyo['総人口'].diff() tokyo['加速度'] = tokyo['前年差'].diff() print(tokyo[['年度','総人口','前年差','加速度']].to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:「前年差」は1 次離散微分 ≒ 速度。 「加速度」は2 次離散微分。 コロナ期に前年差がマイナスに(人口減少)、 その後加速度がプラスに転じて回復。 SSDSE-B-2026 で diff() を 2 回かけるだけで物理の運動方程式が再現できる。
コード 2:PyTorch 自動微分で「線形回帰」を学習
🎯 このコードでやること:47 都道府県の 2023 年データで「総人口 → 出生数」を線形回帰、 PyTorch の自動微分(autograd)で勾配を計算し、 SGD でパラメータ更新。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd, torch df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] x = torch.tensor(d['総人口'].values / 1e7, dtype=torch.float32) y = torch.tensor(d['出生数'].values / 1e4, dtype=torch.float32) w = torch.tensor(0.0, requires_grad=True) b = torch.tensor(0.0, requires_grad=True) opt = torch.optim.SGD([w, b], lr=0.01) for ep in range(2000): opt.zero_grad() loss = ((w*x + b) - y).pow(2).mean() loss.backward() opt.step() print(f"w={w.item():.4f}, b={b.item():.4f}, loss={loss.item():.4f}") |
📤 実行結果:
💬 結果の読み方:$w \approx 5.78$(2000 エポック時点。 さらに回すと OLS 解 $\approx 6.10$ へ収束)は「総人口(1000 万人単位)が 1 増えると出生数(万人単位)が約 6 増える」つまり 出生率 約 6‰。 PyTorch の自動微分が背後で chain rule を実行し、 1 行 loss.backward() で勾配計算完了。 手動で偏微分を書かずに大規模モデルを学習できる。
コード 3:SymPy で記号微分
🎯 このコードでやること:複雑な関数 $f(x) = e^x \sin(x^2)$ を SymPy で記号的に微分し、 数値評価する。
📥 入力データ:関数式 $f(x) = e^x \sin(x^2)$。
1 2 3 4 5 6 7 8 9 | import sympy x = sympy.Symbol('x') f = sympy.exp(x) * sympy.sin(x**2) fp = sympy.diff(f, x) print("f(x) =", f) print("f'(x) =", sympy.simplify(fp)) print("f'(1) =", float(fp.subs(x, 1))) |
📤 実行結果:
💬 結果の読み方:チェーンルールと積の法則が同時に適用され、 「$\sin(x^2)$ 部分」と「$2x \cos(x^2)$ 部分」が出現。 $x=1$ で値 5.23。 SymPy は教育・厳密解確認に最適、 大規模学習には自動微分(PyTorch / JAX)が現実的。
❓ FAQ 20 問
with torch.no_grad(): ブロック内では勾配計算オフ。 推論時に必須。📖 微分の包括ガイド(追補編)
📐 微分の幾何学的・物理的解釈
幾何学的:関数 $y = f(x)$ のグラフ上の点 $(x_0, f(x_0))$ における接線の傾きが $f'(x_0)$。 接線の方程式は $y - f(x_0) = f'(x_0)(x - x_0)$。
物理的:位置 $x(t)$ の時間微分が速度 $v = dx/dt$、 速度の時間微分が加速度 $a = dv/dt = d^2 x/dt^2$。 ニュートンの運動方程式 $F = ma = m \ddot{x}$。
経済学的:費用関数 $C(q)$ の微分が限界費用 $MC = dC/dq$(生産 1 単位追加のコスト)。 効用関数 $U(x)$ の微分が限界効用 $MU = dU/dx$。
統計学的:尤度関数 $L(\theta)$ の対数微分 = 0 が最尤推定 MLE の条件。 確率分布の累積分布 $F(x)$ の微分が確率密度 $f(x)$。
🔬 微分の応用:SSDSE-B-2026 で見る
| 応用 | 数学的形式 | SSDSE-B-2026 での具体例 |
|---|---|---|
| 変化率の計算 | $\Delta y / \Delta x$ | 東京都の人口前年差 |
| トレンド推定 | 線形回帰 $\hat\beta = (X^TX)^{-1}X^Ty$ | 2012-2023 の人口トレンド傾き |
| 最適化 | $\nabla L = 0$ | 都道府県別人口モデルのパラメータ推定 |
| 感度分析 | 偏微分 $\partial y / \partial x_i$ | 各指標の人口への影響度 |
| 転換点検出 | $f'(x) = 0$, $f''(x) \ne 0$ | 人口減少が加速する転換年 |
| 確率密度推定 | カーネル微分 | 47 都道府県人口分布の密度 |
⚙️ 自動微分(Automatic Differentiation)の 2 モード
Forward Mode
入力から出力へ向けて、 各変数に対応する「双対数(dual number)」を伝搬。 例:$f(x) = x^2 + 3x$ で $x = 2$、 双対数 $(x, \dot{x}) = (2, 1)$ を入れると、 $f(x) = (4 + 6, 2 \cdot 2 + 3) = (10, 7)$。 計算量:入力次元 $n$ に比例。 入力が少ない時に有利。
Reverse Mode(逆伝播)
計算グラフを構築 → 出力側から勾配を伝搬。 ディープラーニングの誤差逆伝播。 計算量:出力次元 $m$ に比例。 スカラ損失 $m=1$ で巨大パラメータ $n$ を最適化するのに最適。
📊 数値微分 vs 自動微分 vs 記号微分の精度比較
| 方法 | 誤差 | 速度 | 用途 |
|---|---|---|---|
| 記号微分(SymPy) | 0(厳密) | 遅い | 教育、 厳密解確認 |
| 自動微分(PyTorch/JAX) | 機械精度($10^{-15}$) | 速い | ニューラルネット |
| 中心差分 $\frac{f(x+h)-f(x-h)}{2h}$ | $O(h^2)$、 $h=10^{-5}$ で $10^{-10}$ | 速い | 関数式不明時 |
| 前進差分 $\frac{f(x+h)-f(x)}{h}$ | $O(h)$、 $h=10^{-5}$ で $10^{-5}$ | 最速 | 粗い見積もり |
| 複素差分 $\frac{\text{Im}\,f(x+ih)}{h}$ | 機械精度 | 速い | $f$ が解析関数の時 |
🎯 勾配降下法の系譜
| 手法 | 更新式 | 特徴 |
|---|---|---|
| GD(バニラ) | $\theta - \eta \nabla L$ | 全データ使用、 凸関数で大域最小到達 |
| SGD | $\theta - \eta \nabla L_i$(1 サンプル) | 確率的、 大規模学習で標準 |
| Mini-batch SGD | $\theta - \eta \nabla L_{\text{batch}}$ | バッチ単位、 並列化容易 |
| Momentum | $v \leftarrow \mu v + \eta \nabla L; \theta \leftarrow \theta - v$ | 慣性で局所解脱出 |
| Nesterov Accelerated | 事前見込みで加速 | 収束高速 |
| AdaGrad | $\eta / \sqrt{\sum g^2}$ で学習率減衰 | 疎なデータに有効 |
| RMSProp | 指数平均で勾配の 2 乗 | 非定常目的に強い |
| Adam | Momentum + RMSProp | ディープラーニング標準 |
| AdamW | Adam + 重み減衰 | Transformer 標準 |
| LARS / LAMB | レイヤーごと学習率 | 大規模バッチ学習 |
| Newton 法 | $\theta - H^{-1} g$(H:Hessian) | 2 次収束、 計算コスト高 |
| L-BFGS | 準ニュートン | 中規模問題で高速 |
🌟 SSDSE-B-2026 で勾配降下法を体感する
47 都道府県 × 2023 年データで「総人口 → 出生数」の線形回帰モデル $y = wx + b$ を、 GD(バニラ)、 SGD、 Adam でそれぞれ学習。 収束の違いを比較:
- GD:47 サンプル全部使用、 各エポックで決定的更新、 十分なエポック数で $w \approx 6.10, b \approx 0$ へ収束
- SGD:1 サンプルずつ、 ノイズ大きいが脱出力高い、 同じ解に到達
- Adam:適応的学習率、 ハイパーパラメータに頑健、 早く収束
🧠 ニューラルネットの逆伝播(Backpropagation)
合成関数のチェーンルールを計算グラフ上で系統的に適用する技術。 1986 年 Rumelhart, Hinton, Williams が公表(実は 1970 年代から複数発見)。 現代の全ディープラーニングフレームワークの基盤。
チェーンルールの具体例
3 層 NN:$z_1 = W_1 x$, $a_1 = \sigma(z_1)$, $z_2 = W_2 a_1$, $\hat{y} = a_2 = \sigma(z_2)$, $L = (y - \hat{y})^2$。 $W_1$ の勾配:
$$\frac{\partial L}{\partial W_1} = \frac{\partial L}{\partial a_2} \cdot \frac{\partial a_2}{\partial z_2} \cdot \frac{\partial z_2}{\partial a_1} \cdot \frac{\partial a_1}{\partial z_1} \cdot \frac{\partial z_1}{\partial W_1}$$
各項は出力から順に計算(reverse mode)。 計算量 $O$(順伝播 + 数倍)で全パラメータの勾配が得られる。
📈 微分を使う統計的手法
- 最尤推定(MLE):対数尤度の微分 = 0 → パラメータ推定
- EM アルゴリズム:E ステップで期待値、 M ステップで微分=0 で最適化
- 変分推論:ELBO の最大化(KL ダイバージェンスの微分)
- ベイズ MAP:事後分布の対数微分 = 0
- ニュートン・ラフソン法:ロジスティック回帰の係数推定
- Fisher Scoring:MLE 加速
🎨 SSDSE-B-2026 における「微分の目」で見る統計
SSDSE-B-2026 を時系列データとして見ると、 多くの「微分」概念が自然に登場:
- 人口の前年差:1 次離散微分 = 速度
- 前年差の前年差:2 次離散微分 = 加速度
- 移動平均後の微分:ノイズ除去後のトレンド
- 変曲点検出:2 次微分の符号変化 = 増減傾向の転換点
- ピーク・谷の検出:1 次微分 = 0 の年
- 成長率:対数微分 = $\frac{d}{dt}\log y = \frac{1}{y}\frac{dy}{dt}$
⚠️ よくある落とし穴
数値微分で頻出する失敗は、 (1) 刻み幅 h が大きいと打ち切り誤差、 小さいと丸め誤差、 (2) 前進差分・後退差分・中心差分で精度が違う (中心差分は O(h²))、 (3) 自動微分 (PyTorch/JAX) と数値微分の使い分けを誤る、 の 3 パターンです。 中心差分を初期設定にし、 機械学習の勾配計算は autograd に任せるのが基本です。
h が大きいと打ち切り誤差、 小さいと丸め誤差。 中心差分が安定。detach() や retain_graph を誤ると勾配が流れない/重複。※ 上記は文献調査・現場経験で報告される頻度の高い注意点。 ドメインや手法のバージョンによって追加の落とし穴がある場合があります。
📚 関連グループ教材
「微分」は単独で完結する概念ではなく、 より大きな分野の一部です。 上位カテゴリの教材を読むことで、 この用語の 位置づけ が立体的に見えてきます:
- 📚 機械学習の基礎 — このカテゴリの体系的解説
📚 参考文献・出典
- 高木貞治(1961)『解析概論』岩波書店。 微分の古典的入門。
- Apostol, T. (1967). Calculus, Vol I. Wiley.
- Goodfellow, I., Bengio, Y., Courville, A. (2016). Deep Learning. MIT Press. 6章=逆伝播。
- Baydin, A. et al. (2018). Automatic differentiation in machine learning: a survey. JMLR.
- 独立行政法人統計センター. SSDSE-B-2026 (CC BY 4.0). https://www.nstac.go.jp/use/literacy/ssdse/
- NumPy / SciPy / SymPy 公式ドキュメント。
- PyTorch Autograd Tutorial. https://pytorch.org/docs/stable/autograd.html
🌟 拡張ハンドブック
📜 微分の歴史
微分は Isaac Newton(1666)と Gottfried Leibniz(1684)がほぼ同時に独立発明(優先権論争で有名)。 Newton は「流率法(method of fluxions)」、 Leibniz は dy/dx 記法を導入。 現代の標準記法は Leibniz 由来。 19 世紀に Cauchy・Weierstrass が極限を厳密化し、 解析学として確立。 20 世紀後半、 計算機の登場で 自動微分(Wengert 1964)が誕生、 21 世紀のディープラーニング革命の数学的基盤に。
📐 微分公式 完全一覧(基本 + 派生)
| $f(x)$ | $f'(x)$ |
|---|---|
| $x^n$ | $nx^{n-1}$ |
| $\sqrt{x} = x^{1/2}$ | $\frac{1}{2\sqrt{x}}$ |
| $\frac{1}{x} = x^{-1}$ | $-x^{-2}$ |
| $e^x$ | $e^x$ |
| $a^x$ | $a^x \ln a$ |
| $\ln x$ | $1/x$ |
| $\log_a x$ | $\frac{1}{x \ln a}$ |
| $\sin x$ | $\cos x$ |
| $\cos x$ | $-\sin x$ |
| $\tan x$ | $\sec^2 x$ |
| $\arctan x$ | $\frac{1}{1+x^2}$ |
| $\sigma(x) = \frac{1}{1+e^{-x}}$ | $\sigma(x)(1-\sigma(x))$ |
| $\tanh x$ | $1 - \tanh^2 x$ |
| $\text{ReLU}(x)$ | $\mathbb{1}[x>0]$ |
| $\text{softmax}(x)_i$ | $\text{softmax}(x)_i (\delta_{ij} - \text{softmax}(x)_j)$ |
⚙️ 自動微分の 2 モード
Forward mode:入力側から計算。 入力次元 $n$ < 出力次元 $m$ の場合に有利($O(n)$ 回)。 Reverse mode(逆伝播):出力側から計算。 $n > m$ の場合に有利($O(m)$ 回)。 ディープラーニングでは $n$(パラメータ)が巨大、 $m=1$(スカラ損失)なので reverse mode が圧倒的に効率的。
💼 微分の実務適用パターン
- 勾配降下法:機械学習モデルの学習
- Newton-Raphson 法:方程式の数値解、 ロジスティック回帰の収束加速
- 感度分析:入力の微小変化が出力に与える影響
- BPTT(Backprop Through Time):RNN の逆伝播
- Adjoint method:物理シミュレーションの最適化
- Implicit differentiation:陰関数の微分
📚 50 連発レシピ集(微分 × Python)
SSDSE-B-2026 を題材に、 微分・勾配計算を NumPy / SciPy / SymPy / PyTorch で実演する 50 ミニコード。
import sympy; x=sympy.Symbol('x'); sympy.diff(x**2, x)→2*xsympy.diff(sympy.sin(x), x)→cos(x)sympy.diff(sympy.exp(x), x)→exp(x)sympy.diff(sympy.log(x), x)→1/xsympy.diff(x**3 + 2*x**2 + x, x)→3*x**2 + 4*x + 1sympy.diff(x**2, x, 2)→2(2 階微分)import numpy as np; np.gradient([1,4,9,16,25])→[3,4,6,8,9]数値微分np.gradient([1,4,9,16,25], 0.5)— 刻み幅 0.5def num_diff(f, x, h=1e-5): return (f(x+h)-f(x-h))/(2*h)中心差分num_diff(lambda x: x**2, 3.0)→ 約 6.0import pandas as pd; df=pd.read_csv('data/raw/SSDSE-B-2026.csv',encoding='cp932',skiprows=[1])tokyo = df[df['都道府県']=='東京都'].sort_values('年度')tokyo['総人口'].diff()— 前年差(離散微分)tokyo['総人口'].pct_change()— 増減率tokyo['総人口'].diff().diff()— 2 階差分import torch; x=torch.tensor(2.0,requires_grad=True); y=x**3; y.backward(); print(x.grad)→ 12.0x=torch.tensor([1.,2.,3.],requires_grad=True); y=(x**2).sum(); y.backward(); x.grad→ [2,4,6]import jax.numpy as jnp; from jax import grad; f=lambda x: x**3; grad(f)(2.0)→ 12.0from scipy.misc import derivative; derivative(lambda x: x**2, 3, dx=1e-5)→ ~6.0sympy.diff(sympy.tan(x), x)→tan(x)**2 + 1sympy.diff(1/x, x)→-1/x**2sympy.diff(sympy.sqrt(x), x)→1/(2*sqrt(x))sigmoid = lambda x: 1/(1+sympy.exp(-x)); sympy.diff(sigmoid(x), x)— σ'relu_grad = lambda x: 1 if x>0 else 0tokyo['総人口'].rolling(3).mean().diff()— 平滑化後の微分np.polyfit(tokyo['年度'], tokyo['総人口'], 1)— 線形トレンドの傾き = 微分の平均x,y = sympy.symbols('x y'); f = x**2 + y**2; [sympy.diff(f,v) for v in (x,y)]→ 勾配sympy.hessian(x**2 + y**2, (x,y))→ ヘッセ行列from scipy.optimize import minimize; minimize(lambda x: (x[0]-3)**2, [0])— 勾配を内部で利用from scipy.optimize import minimize; minimize(lambda x: (x[0]-3)**2, [0], jac=lambda x: [2*(x[0]-3)])— 勾配明示x=torch.linspace(0,1,100); x.requires_grad_(True); y=torch.sin(x).sum(); y.backward(); x.gradprint(df[df.年度==2023]['総人口'].sum())— 全国合計 約 1.24 億人df.groupby('都道府県')['総人口'].apply(lambda s: s.diff().mean())— 県別平均年率print(f"東京の平均年率: {tokyo['総人口'].diff().mean():.0f} 人/年")→ 約 +75,000 人/年def gd(f, fp, x0, eta=0.1, n=100):— 勾配降下法ジェネリックgd(lambda x: x**2, lambda x: 2*x, x0=5.0)— 最小値 0 に収束import torch; opt=torch.optim.SGD([x],lr=0.1); opt.step()opt=torch.optim.Adam([x],lr=0.01)— Adam 最適化print('チェーンルール: f(g(x))の微分 = f\'(g(x)) g\'(x)')sympy.diff(sympy.sin(x**2), x)— 合成関数の微分from sklearn.linear_model import SGDRegressor; m=SGDRegressor(); m.fit([[1],[2]],[1,2])tokyo['加速度'] = tokyo['総人口'].diff().diff()tokyo[['年度','総人口','加速度']].tail()print('Newton 法: x_{n+1} = x_n - f(x_n)/f\'(x_n)')def newton(f, fp, x0, n=20): [x:=x0-f(x0)/fp(x0) for _ in range(n)]print(f"全国平均 2023: {df[df.年度==2023]['総人口'].mean():,.0f} 人")→ 約 2,646,000 人print('微分可能 vs 不可能:絶対値関数は x=0 で不可能')print('凸関数:2 階微分 ≥ 0、 局所最小 = 大域最小')print('鞍点:勾配 0 だが極小極大ではない、 大規模 NN で頻出')print('🎓 微分の本質:「ゼロに極限を取る差分商」')
📚 微分関連 50 連発レシピ集(拡張版)
from sympy import symbols, diff, Symbol; x = symbols('x')diff(x**5, x)→5*x**4diff(x**5, x, 2)→20*x**3(2 階)diff(x**5, x, 3)→60*x**2(3 階)diff(x**5 - 4*x**2 + 7, x)→5*x**4 - 8*xdiff(1/(x**2 + 1), x)— 商の微分diff(x**x, x)→x**x*(log(x) + 1)diff(sympy.sin(sympy.cos(x)), x)— 多重チェーンルールdiff(sympy.exp(-x**2/2), x)— ガウス関数diff(sympy.log(1 + sympy.exp(x)), x)— softplus 関数import pandas as pd; df=pd.read_csv('data/raw/SSDSE-B-2026.csv',encoding='cp932',skiprows=[1])tokyo = df[df.都道府県=='東京都'].sort_values('年度')print(tokyo[['年度','総人口']])tokyo['人口差'] = tokyo['総人口'].diff()— 1 次離散微分tokyo['加速度'] = tokyo['人口差'].diff()— 2 次離散微分tokyo['年率'] = tokyo['総人口'].pct_change() * 100print(f"東京都の 2012-2023 年平均年率: {tokyo['年率'].mean():.3f}%")import numpy as np; np.gradient(tokyo['総人口'].values)np.gradient(tokyo['総人口'].values, tokyo['年度'].values)— 年度ステップ込みp = np.polyfit(tokyo['年度'], tokyo['総人口'], 1); print(f"トレンド傾き: {p[0]:,.0f} 人/年")# → 約 +75,000 人/年import torch; x = torch.tensor(2.0, requires_grad=True)y = x**4; y.backward(); print(x.grad)→ 32.0x = torch.tensor([1.,2.,3.], requires_grad=True); y = (x**2).sum(); y.backward(); print(x.grad)def grad_check(f, fp, x, h=1e-5): return abs(fp(x) - (f(x+h)-f(x-h))/(2*h))grad_check(lambda x: x**3, lambda x: 3*x**2, 2.0)→ 約 0from jax import grad, jit; f = jit(lambda x: x**4 + 3*x**2)gf = jit(grad(f)); print(gf(2.0))from scipy.optimize import minimize; r = minimize(lambda x: (x[0]-3)**2 + (x[1]-2)**2, [0,0]); print(r.x)r = minimize(lambda x: x[0]**2, [5.0], jac=lambda x: [2*x[0]]); print(r.x)tokyo[['年度','総人口','人口差','加速度']].dropna().tail()print('2020 前後にコロナで人口減、 2022 から回復')osaka = df[df.都道府県=='大阪府'].sort_values('年度')osaka['人口差'] = osaka['総人口'].diff()print(f"大阪府 2023 年人口: {osaka['総人口'].iloc[-1]:,}")→ 8,763,000okinawa = df[df.都道府県=='沖縄県'].sort_values('年度')okinawa['年率'] = okinawa['総人口'].pct_change() * 100print(f"沖縄県平均年率: {okinawa['年率'].mean():.3f}%")# 沖縄は増加県の代表nationwide = df.groupby('年度')['総人口'].sum()print(nationwide.diff())— 全国年差print(f"全国 2023: {nationwide.loc[2023]:,}")→ 124,353,000print(f"全国 2012: {nationwide.loc[2012]:,}")opt = torch.optim.SGD([torch.tensor(0.0, requires_grad=True)], lr=0.1)opt = torch.optim.Adam([torch.tensor(0.0, requires_grad=True)], lr=0.01)for _ in range(100): opt.zero_grad(); l = (x-3)**2; l.backward(); opt.step()import torch.nn as nn; m = nn.Linear(1, 1)print(m.weight, m.bias)print('🎓 微分は機械学習の心臓 — SSDSE-B-2026 でも体感可')print('Next: 偏微分、 勾配、 ヘッセ、 最適化アルゴリズム')
📚 微分 × SSDSE-B-2026 完全ハンドブック
📐 微分の 7 つの定義方法
- 極限定義:$f'(x) = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h}$
- 線形近似:$f(x+h) = f(x) + h f'(x) + o(h)$
- 幾何学的:接線の傾き
- 双対数:$f(x + \varepsilon) = f(x) + \varepsilon f'(x)$($\varepsilon^2 = 0$)
- 形式的微分:多項式 $\sum a_i x^i \mapsto \sum i a_i x^{i-1}$
- 分布的微分:Schwartz 超関数の意味で(不連続関数でも定義)
- 圏論的:tangent functor、 「無限小変化の射」
📊 微分公式 30 種完全表
| f(x) | f'(x) | 用途 |
|---|---|---|
| $c$ | $0$ | 定数 |
| $x^n$ | $n x^{n-1}$ | 多項式 |
| $\sqrt{x}$ | $\frac{1}{2\sqrt{x}}$ | 2 乗根 |
| $1/x$ | $-1/x^2$ | 逆数 |
| $e^x$ | $e^x$ | 指数 |
| $a^x$ | $a^x \ln a$ | 一般指数 |
| $\ln x$ | $1/x$ | 自然対数 |
| $\log_a x$ | $1/(x \ln a)$ | 一般対数 |
| $\sin x$ | $\cos x$ | 正弦 |
| $\cos x$ | $-\sin x$ | 余弦 |
| $\tan x$ | $\sec^2 x$ | 正接 |
| $\cot x$ | $-\csc^2 x$ | 余接 |
| $\sec x$ | $\sec x \tan x$ | 正割 |
| $\csc x$ | $-\csc x \cot x$ | 余割 |
| $\arcsin x$ | $1/\sqrt{1-x^2}$ | 逆正弦 |
| $\arccos x$ | $-1/\sqrt{1-x^2}$ | 逆余弦 |
| $\arctan x$ | $1/(1+x^2)$ | 逆正接 |
| $\sinh x$ | $\cosh x$ | 双曲線正弦 |
| $\cosh x$ | $\sinh x$ | 双曲線余弦 |
| $\tanh x$ | $1 - \tanh^2 x$ | 双曲線正接 |
| $\sigma(x) = 1/(1+e^{-x})$ | $\sigma(x)(1-\sigma(x))$ | シグモイド |
| $\text{ReLU}(x)$ | $\mathbb{1}[x > 0]$ | NN 活性化 |
| $\text{GELU}(x)$ | 複雑(近似可) | Transformer |
| $\text{softplus}(x) = \log(1+e^x)$ | $\sigma(x)$ | NN |
| $x \log x$ | $\log x + 1$ | エントロピー |
| $(uv)$ | $u'v + uv'$ | 積の法則 |
| $(u/v)$ | $(u'v - uv')/v^2$ | 商の法則 |
| $(u^v)$ | $u^v(v' \ln u + v u'/u)$ | 一般冪 |
| $f(g(x))$ | $f'(g(x)) g'(x)$ | チェーンルール |
| $f^{-1}(x)$ | $1/f'(f^{-1}(x))$ | 逆関数 |
🎯 微分計算の 10 大応用
- 勾配降下法:$\theta \leftarrow \theta - \eta \nabla L(\theta)$(機械学習の最適化)
- ニュートン法:$x_{n+1} = x_n - f(x_n)/f'(x_n)$(方程式の数値解)
- テイラー展開:$f(x) = \sum_{n=0}^\infty \frac{f^{(n)}(a)}{n!}(x-a)^n$
- 誤差伝播:$\sigma_y = |f'(x)| \sigma_x$(測定誤差の伝播)
- 変化点検出:$f'(x_0) = 0$ かつ符号変化
- 感度分析:$\partial y/\partial x_i$(入力 $x_i$ の影響度)
- 最尤推定:$\partial \log L / \partial \theta = 0$
- EM アルゴリズム:E ステップ + M ステップで対数尤度の停留点へ
- 制御工学:PID 制御の D(微分)成分で誤差変化を抑制
- 物理シミュレーション:運動方程式 $F = m \ddot{x}$ の数値積分
🧮 SSDSE-B-2026 で「微分」を完全実演
実演 1:47 都道府県の人口変化率を全部計算
🎯 やること:47 都道府県 × 12 年 = 564 行から、 各県の 2012→2023 年率変化を一括計算し、 増加県・減少県をランキング表示。
📥 入力:SSDSE-B-2026.csv 全件。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 各県の 2012 と 2023 の人口を取得 pivot = df.pivot_table(index='都道府県', columns='年度', values='総人口') pivot['年率%'] = ((pivot[2023] / pivot[2012]) ** (1/11) - 1) * 100 result = pivot[[2012, 2023, '年率%']].sort_values('年率%', ascending=False) print("=== 増加 TOP 5 ===") print(result.head().round(3)) print("\n=== 減少 TOP 5 ===") print(result.tail().round(3)) |
📤 出力:
💬 解説:年率変化(離散微分の年率版)でランキング。 東京・沖縄が増加 TOP、 秋田・青森・高知が減少 TOP。 これは離散微分 $\Delta y / y \approx d(\log y)/dt$(対数微分)と数学的に同等。 47 県の「人口微分」が 1 つの表で見渡せる。
実演 2:勾配降下法で「人口 → 出生数」線形モデル学習
🎯 やること:47 都道府県の 2023 年データで $y = wx + b$ を勾配降下法で学習。 自動微分なし(手書き)と PyTorch 自動微分の両方で確認。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] x = d['総人口'].values / 1e7 # 1000 万人単位 y = d['出生数'].values / 1e4 # 1 万人単位 # 手書き勾配降下 w, b = 0.0, 0.0 eta = 0.01 for ep in range(5000): yhat = w*x + b grad_w = np.mean((yhat - y) * x) * 2 grad_b = np.mean(yhat - y) * 2 w -= eta * grad_w b -= eta * grad_b print(f"手書き GD: w = {w:.4f}, b = {b:.4f}") print(f"x=1.4086(東京)での予測: {w*1.4086+b:.2f} 万人(実 8.6 万人)") |
📤 出力:
💬 解説:勾配降下法で線形モデルを学習、 東京都の予測値 8.53 万人が実値 8.6 万人とほぼ一致。 微分(勾配)は MSE 損失 $L = \frac{1}{n}\sum (wx_i + b - y_i)^2$ を $w$ と $b$ で偏微分すると、 $\partial L/\partial w = \frac{2}{n}\sum (\hat{y}-y)x$、 $\partial L/\partial b = \frac{2}{n}\sum(\hat{y}-y)$ となる。 この式を手書きでコード化すれば学習可能。
📐 多変数解析と SSDSE-B-2026
SSDSE-B-2026 の 112 列を $f: \mathbb{R}^{110} \to \mathbb{R}$ の関数と見立てて、 「出生数を予測する」モデルを考えると、 入力 $x = (x_1, x_2, \ldots, x_{110})$ に対する偏微分 $\partial f/\partial x_i$ が、 各指標の「出生数への影響度」を表す。 機械学習モデル(線形回帰、 NN)の係数解釈はまさにこの偏微分。
🎨 微分の可視化:接線と微分グラフ
関数 $f(x)$ のグラフと、 各点の接線の傾き(微分値)を並べて描くと、 「グラフが上がっているところで微分が正、 下がっているところで負」が一目瞭然。 SSDSE-B-2026 の東京都人口の時系列も同様で、 微分グラフを見れば「いつから増加が加速したか」「いつ転換点だったか」が分かる。
🧬 微分の最新応用:Neural ODE
2018 年に提唱された Neural ODE は、 ニューラルネットの離散層を「微分方程式の解」として連続化。 $\frac{dh}{dt} = f(h, t, \theta)$ を ODE ソルバで解くことで、 任意の深さの NN を表現。 自動微分とアダプティブステップで学習。 SSDSE-B-2026 のような時系列にも応用可能。
🎓 微分学習のロードマップ
- 高校数学:1 変数微分、 公式 8 種、 接線の方程式
- 大学微積分:偏微分、 勾配、 ヘッセ行列、 テイラー展開
- 解析学:極限の厳密化、 微分可能性、 リプシッツ連続
- 数値解析:差分商、 自動微分、 数値最適化
- 機械学習:勾配降下、 逆伝播、 Adam、 二次手法
- 応用:物理シミュ、 金融工学、 制御工学
- 研究:Neural ODE、 微分可能プログラミング、 確率微分方程式
📓 「微分」マスターガイド付録 — SSDSE-B-2026 教材化の完全シナリオ
∂ 序:なぜ SSDSE-B-2026 で「微分」を学ぶのか
「微分」は単独の用語として覚えるものではなく、 実際のデータに当てはめて初めて意味を持つ概念です。 SSDSE-B-2026(独立行政法人統計センター、 CC BY 4.0、 564 行 × 112 列)は、 (1) 全数調査、 (2) 12 年スパン、 (3) 都道府県という親しみやすい単位、 という 3 拍子揃った教材適性データセットです。 ジャストインタイム型データサイエンス教育の核は「具体例から逆引きで理論に到達する」こと。 ここでは「微分」を題材に、 SSDSE-B-2026 でハンズオン形式の学習シナリオを 6 段階で展開します。
∂ 段階 1:データに触れる — 最初の 5 分
まずは余計なことを考えず、 SSDSE-B-2026 を読み込んで head()、 describe()、 info() を実行する。 「564 行 × 112 列、 全データが集計値で個人情報なし、 CC BY 4.0」と頭に入れる。 「微分」の議論は、 このデータ実体への触感の上に積み上げる。
∂ 段階 2:47 都道府県の数値感覚を身につける
2023 年の主要数値を「数字でなく物語」として記憶する:
- 東京都 14,086,000 人:全国の約 11%、 桁外れの 1 位
- 神奈川県 9,229,000 人:2 位、 ほぼ東京の 65%
- 大阪府 8,763,000 人:3 位、 関西の中心
- 愛知県 7,477,000 人:4 位、 中部の中心
- 埼玉県 7,331,000 人:5 位、 千葉と並ぶ首都圏ベッドタウン
- 千葉県 6,257,000 人:6 位
- 兵庫県 5,370,000 人:7 位、 関西第 2
- 福岡県 5,103,000 人:8 位、 九州の中心
- 北海道 5,092,000 人:9 位、 唯一の道
- 静岡県 3,555,000 人:10 位、 ここで桁が変わる
- ...(中略)...
- 沖縄県 1,468,000 人:合計特殊出生率 1.60 で全国 1 位
- 島根県 651,000 人:46 位
- 鳥取県 537,000 人:47 位、 最小
東京が最大 14M、 鳥取が最小 0.54M、 ほぼ 26 倍の格差。 これが「微分」の議論で意識すべき基本構造。
∂ 段階 3:「微分」の視点で問いを立てる
- 「微分」を SSDSE-B-2026 に適用したとき、 何が見えるか?
- どの列を使い、 どんな計算をすればよいか?
- 結果の数値はどう解釈すればよいか?
- 誤った解釈(落とし穴)は何か?
- 他のデータセット(SSDSE-A、 e-Stat、 RESAS)と組み合わせると何が分かるか?
∂ 段階 4:Python での実装と検証
テンプレート A:基本ロード
🎯 やること:SSDSE-B-2026 を pandas で読み込み、 出典情報を付与した DataFrame を返す関数を定義。
📥 入力:CSV パス。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd def load_ssdse(year=None): """SSDSE-B-2026 を読み込み(任意年指定)""" df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df.attrs['source'] = 'SSDSE-B-2026' df.attrs['license'] = 'CC BY 4.0' if year is not None: df = df[df['年度'] == year].copy() return df # 2023 年のみ取得 d2023 = load_ssdse(year=2023) print(f"2023 年データ: {len(d2023)} 県 × {len(d2023.columns)} 列") print(f"出典: {d2023.attrs['source']} ({d2023.attrs['license']})") |
📤 出力:
💬 解説:この 5 行で「ライセンス遵守なデータ取得関数」が完成。 以降のすべての分析はこの関数からスタート。
テンプレート B:上位ランキング抽出
🎯 やること:任意の列で TOP N を抽出する汎用関数。
1 2 3 4 5 6 7 8 9 10 11 | def top_n(df, col, n=5): """任意列の TOP N を返す(出典付き)""" return df.nlargest(n, col)[['都道府県', col]] d = load_ssdse(year=2023) print("=== 総人口 TOP 5 ===") print(top_n(d, '総人口').to_string(index=False)) print("\n=== 出生数 TOP 5 ===") print(top_n(d, '出生数').to_string(index=False)) print("\n=== 合計特殊出生率 TOP 5 ===") print(top_n(d, '合計特殊出生率').to_string(index=False)) |
📤 出力:
💬 解説:「総人口 TOP」と「合計特殊出生率 TOP」が完全に違う。 出生率は地方圏が上位(沖縄、 宮崎、 鳥取、 島根、 長崎)。 東京は出生数では TOP 1 だが、 出生率では 47 位(0.99)。 「規模」と「率」を混同しない目を養うのが大事。
テンプレート C:時系列推移
🎯 やること:特定都道府県の総人口 12 年推移を取得。
1 2 3 4 5 6 7 8 9 10 | def time_series(df_all, prefecture, col='総人口'): """指定都道府県の時系列""" return df_all[df_all['都道府県']==prefecture][['年度', col]].sort_values('年度') df_all = load_ssdse() # 全 564 行 tokyo = time_series(df_all, '東京都') print("=== 東京都の総人口推移 ===") print(tokyo.to_string(index=False)) print(f"\n2012-2023 変化: {(tokyo['総人口'].iloc[-1] - tokyo['総人口'].iloc[0]):+,} 人") print(f"年率: {((tokyo['総人口'].iloc[-1]/tokyo['総人口'].iloc[0])**(1/11) - 1)*100:+.3f}%") |
📤 出力:
💬 解説:東京都は 12 年間で +85 万人増加(年率 +0.57%)。 2021 年だけコロナで約 -38,000 人と一時減、 翌 2022 年から再増加。 「微分」を「東京一極集中」の議論で使うとき、 こうした実数を踏まえるのが説得力の源。
∂ 段階 5:「微分」を多角的に検証
- 記述統計:平均・中央値・分散・四分位数で全体像
- 視覚化:箱ひげ図、 散布図、 時系列折れ線、 地図ヒートマップ
- 仮説検定:t 検定、 カイ二乗、 相関係数 + p 値
- モデリング:線形回帰、 ロジスティック、 ランダムフォレスト
- クラスタリング:k-means で類似県をグループ化
- 次元削減:PCA / t-SNE / UMAP で 112 列を 2 次元に圧縮
∂ 段階 6:他者へ説明・教える
「微分」を SSDSE-B-2026 で学んだ後の最終ステップは、 他者に説明できるレベルに到達すること。 おすすめの実践:
- SSDSE-B-2026 を題材にした 5 分プレゼン資料を作成
- Jupyter Notebook で再現可能な分析レポートを公開(GitHub)
- 勉強会・LT で「東京と鳥取の数値差は 26 倍」のような具体的事実から話を始める
- Q&A セッションで他者の質問に答えながら理解を深める
- ブログ記事に「SSDSE-B-2026 を CC BY 4.0 で再配布」と明記して公開
∂ 「微分」関連の用語ネットワーク(30 語)
| カテゴリ | 用語例 |
|---|---|
| 前提知識 | Python 基礎、 pandas、 NumPy、 数学(高校〜大学初級) |
| 並列概念 | 同分野の兄弟用語(系統別 6 件) |
| 応用ツール | Jupyter、 VSCode、 Git、 GitHub、 Streamlit |
| 関連分析手法 | 記述統計、 推測統計、 回帰、 分類、 クラスタリング |
| 関連データ | SSDSE-A、 SSDSE-C、 e-Stat、 RESAS、 World Bank |
| 発展領域 | 因果推論、 ベイズ統計、 機械学習、 深層学習 |
∂ まとめ:SSDSE-B-2026 で「微分」を学ぶ 5 つの利点
- 実データ:合成データではない、 実際の 47 都道府県統計
- 適切な規模:564 行 × 112 列、 教材・学習に最適
- 無料・自由:CC BY 4.0、 出典明記で誰でも使える
- 多角的:人口・気候・経済・教育・住宅と多分野
- 時系列:12 年スパン、 トレンド・転換点の検出が可能
∂ 「微分」最終チェックリスト
- □ 「微分」を自分の言葉で 30 字で説明できる
- □ SSDSE-B-2026 で具体例を 3 つ挙げられる
- □ Python での実装を 10 行以内で書ける
- □ 結果の解釈と限界を述べられる
- □ 関連用語 5 つと違いを説明できる
- □ 出典明記の正しい書式を知っている
- □ よくある誤解・落とし穴を 3 つ挙げられる
- □ 他者に教えるなら 10 分でプレゼンできる
📑 「微分」の徹底応用集 — SSDSE-B-2026 で深掘りする 100 のミニ実験
∂ 47 都道府県データに「微分」を適用:実験 1〜100
以下の 100 のミニ実験はすべて、 SSDSE-B-2026 を pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) で読み込んだ df を前提とします。 全実験は 1〜3 行で動作確認可能、 「微分」の理解を実装で深めるための練習帳です。
- 2023 年データのみ抽出:
d = df[df.年度==2023] - 全国総人口 2023:
d['総人口'].sum()→ 124,353,000 - 平均人口:
d['総人口'].mean()→ 2,645,808.5 - 中央値:
d['総人口'].median()→ 1,549,000 - 標準偏差:
d['総人口'].std()→ 2,797,551 - 最大:
d['総人口'].max()→ 14,086,000(東京都) - 最小:
d['総人口'].min()→ 537,000(鳥取県) - 最大÷最小:
14086000/537000→ 26.23 倍格差 - 第 1 四分位:
d['総人口'].quantile(0.25)→ 1,034,000 - 第 3 四分位:
d['総人口'].quantile(0.75)→ 2,636,500 - IQR:
約 1,603千人 - 歪度:
d['総人口'].skew()→ 約 2.3(強い右歪み) - 尖度:
d['総人口'].kurt()→ 約 10(重い裾) - 東京の人口:
d[d.都道府県=='東京都'].総人口.iloc[0]→ 14086000 - 神奈川:9229000
- 大阪:8763000
- 愛知:7477000
- 埼玉:7331000
- 千葉:6257000
- 兵庫:5370000
- 福岡:5103000
- 北海道:5092000
- 静岡:3555000
- 茨城:2825000
- 広島:2738000
- 京都:2535000
- 宮城:2264000
- 新潟:2126000
- 長野:2004000
- 岐阜:1931000
- 群馬:1902000
- 栃木:1897000
- 岡山:1847000
- 福島:1767000
- 三重:1727000
- 熊本:1709000
- 鹿児島:1549000
- 沖縄:1468000
- 滋賀:1407000
- 山口:1298000
- 愛媛:1291000
- 奈良:1296000
- 長崎:1267000
- 青森:1184000
- 岩手:1163000
- 大分:1096000
- 石川:1109000
- 宮崎:1042000
- 山形:1026000
- 富山:1007000
- 香川:926000
- 秋田:914000
- 和歌山:892000
- 山梨:796000
- 佐賀:795000
- 福井:744000
- 徳島:695000
- 高知:666000
- 島根:650000
- 鳥取:537000
- 出生数全国合計:
d['出生数'].sum()→ 727,269 - 東京都の出生数:86,348
- 合計特殊出生率 TOP は沖縄県の 1.60
- 合計特殊出生率 LAST は東京都の 0.99(唯一 1.0 未満)
- 東京都の婚姻件数:71,774 件
- 東京都の離婚件数:20,016 件
- 離婚率(東京都、 離婚÷婚姻):
20016/71774→ 27.9% - 東京都の年平均気温:17.6°C
- 沖縄県の年平均気温:最高クラス 23°C 台
- 北海道の年平均気温:11.0°C(最低)
- 2012-2023 全国総人口の変化:減少傾向
- 東京都 2012:13,234,000 人
- 東京都 2023:14,086,000 人
- 東京都 12 年増加:+852,000 人
- 東京都年率:+0.57%
- 東京都の前年差 2020→2021:-37,594 人(コロナ)
- 大阪府 2012:8,861,000 → 2023:8,763,000、 -98,000 人(減少)
- 沖縄県 2012:1,411,000 → 2023:1,468,000、 +57,000 人(増加)
- 鳥取県 2012:583,000 → 2023:537,000、 -46,000 人
- 秋田県 2012:1,063,000 → 2023:914,000、 -149,000 人(最大減少率)
- 北海道 2012 → 2023:-370,000 人台
- 関東 7 都県合計 2023:43,527,000 人
- 近畿 7 府県合計 2023:21,990,000 人
- 中部 9 県合計 2023:20,749,000 人
- 九州沖縄 8 県合計 2023:14,029,000 人
- 東北 6 県合計 2023:8,318,000 人
- 中国 5 県合計 2023:7,070,000 人
- 四国 4 県合計 2023:3,578,000 人
- 北海道 1 道:5,092,000 人
- 関東のシェア:43.5M / 124.4M = 35.0%
- 東京都のシェア:14.1M / 126.4M = 11.1%
- 1 都 3 県(東京・神奈川・千葉・埼玉)シェア:30%
- 大阪府の出生率:1.19
- 愛知県の出生率:1.29
- 福岡県の出生率:1.26
- 合計特殊出生率全国(2023):約 1.20
- 人口置換水準 2.07 を満たす県:ゼロ
- 少子化が最も進行:東京都(0.99)
- 「微分」関連の数値感:1 都道府県 ≒ 100 万〜1500 万人
- 「微分」を語る基礎データ:47 県 × 12 年 × 112 列
- 「微分」を CC BY 4.0 で誰でも自由に教材化可能
- 「微分」x SSDSE-B-2026:ジャストインタイム型教育の理想素材
- 🎓 「微分」は SSDSE-B-2026 で「触って学ぶ」のが最短ルート
∂ 「微分」を題材にした実践ノートブック構成例
- Cell 1:Import + データロード + 出典明記
- Cell 2:基本統計(describe)
- Cell 3:欠損値確認
- Cell 4:「微分」関連列の抽出
- Cell 5:可視化(matplotlib / seaborn)
- Cell 6:仮説の数式化
- Cell 7:「微分」を用いた計算実装
- Cell 8:結果の数値解釈
- Cell 9:限界・前提条件の議論
- Cell 10:再現性(出典・ライセンス・コード)
∂ SSDSE-B-2026 解析で頻出する Python パターン 30 個
| # | パターン | 用途 |
|---|---|---|
| 1 | df.head() | 先頭 5 行確認 |
| 2 | df.info() | 列型・欠損確認 |
| 3 | df.describe() | 記述統計 |
| 4 | df.isnull().sum() | 欠損値カウント |
| 5 | df[df.年度==2023] | 年度フィルタ |
| 6 | df.nlargest(5, '総人口') | TOP 5 |
| 7 | df.nsmallest(5, '総人口') | BOTTOM 5 |
| 8 | df.groupby('都道府県')['総人口'].mean() | 県別平均 |
| 9 | df.pivot_table(...) | クロス集計 |
| 10 | df.diff() | 前年差 |
| 11 | df.pct_change() | 変化率 |
| 12 | df.rolling(3).mean() | 移動平均 |
| 13 | df.cumsum() | 累積和 |
| 14 | df.corr() | 相関行列 |
| 15 | df.melt() | Wide → Long |
| 16 | df.merge() | 結合 |
| 17 | df.set_index() | インデックス設定 |
| 18 | df.sort_values() | 並び替え |
| 19 | df.to_csv() | CSV 出力 |
| 20 | df.to_parquet() | Parquet 出力 |
| 21 | df.apply(func, axis=1) | 行ごと関数適用 |
| 22 | df.iloc[i] | 位置アクセス |
| 23 | df.loc[mask] | 条件アクセス |
| 24 | df.shape | 行列数 |
| 25 | df.columns | 列名一覧 |
| 26 | df.dtypes | 列型一覧 |
| 27 | df.value_counts() | 値の度数 |
| 28 | df.dropna() | 欠損行除去 |
| 29 | df.fillna(0) | 欠損埋め |
| 30 | df.astype(int) | 型変換 |
∂ 「微分」を学ぶ際の参考文献 + Web リソース
- 分野標準教科書(学術書、 数千ページレベル)
- Python ライブラリ公式ドキュメント(pandas、 NumPy、 scikit-learn)
- Real Python、 Towards Data Science、 Kaggle Learn
- 独立行政法人統計センター SSDSE-B-2026(CC BY 4.0)
- e-Stat 政府統計の総合窓口(出典・データ源)
- RESAS 地域経済分析システム
- World Bank Open Data(国際比較)
- arXiv(最新研究論文)
- GitHub Awesome リスト(分野別の優れた資料集)
- YouTube 講義(3Blue1Brown、 StatQuest、 Two Minute Papers)
∂ 最終確認:「微分」を SSDSE-B-2026 で完全に学べたか?
- SSDSE-B-2026 を CC BY 4.0 で読み込み、 出典明記したか?
- 47 都道府県・12 年の数値感覚を得たか?
- 「微分」を 3 行 Python で実装できるか?
- 東京都 14,086,000 人・鳥取県 537,000 人・26 倍格差を覚えたか?
- 合計特殊出生率の沖縄 1.60、 東京 0.99 を覚えたか?
- 「微分」を 5 分プレゼンで他者に説明できるか?
- 「微分」の落とし穴を 3 つ挙げられるか?
- 分析結果を出典明記のレポートに仕上げられるか?
これら 8 項目すべてが ✅ なら、 SSDSE-B-2026 を題材にした「微分」の習得は完了です。 次の用語・次の分野へ進みましょう。
🌟 SSDSE-B-2026 ハンズオン総合演習:「微分」テーマで 1 時間プロジェクト
∂ プロジェクト概要
「微分」を題材に、 SSDSE-B-2026 を使った 1 時間完結のミニプロジェクトを構築する手順。 ジャストインタイム型学習の「実際にやってみる」フェーズの実装版です。
∂ タイムテーブル
| 時間 | 作業 | 具体的内容 |
|---|---|---|
| 0-10 分 | 環境準備 | Jupyter 起動、 SSDSE-B-2026 ロード、 head/describe |
| 10-20 分 | 「微分」関連列特定 | 112 列から関連する列を 5〜10 個選別 |
| 20-30 分 | 探索的データ分析 | 箱ひげ図、 散布図、 相関行列 |
| 30-45 分 | 「微分」を用いた分析 | 仮説立て、 計算、 結果数値化 |
| 45-55 分 | レポート作成 | Markdown / HTML で結果まとめ、 出典明記 |
| 55-60 分 | 振り返り | 限界・次のステップ・他者共有準備 |
∂ アウトプット例
1 時間後にあなたが持つもの:
- Jupyter Notebook 1 つ(再現可能、 50〜100 セル)
- Markdown レポート(A4 換算 2〜3 枚)
- 可視化 PNG 3〜5 枚
- 派生 CSV / Parquet ファイル
- LICENSE.txt(CC BY 4.0、 出典明記)
- GitHub 公開可能なコード一式
∂ 次のステップ
- このノートを「微分」を学ぶ仲間と共有
- SSDSE-B-2026 以外のデータ(SSDSE-A、 e-Stat 別系)でも同じ分析を試す
- 「微分」の前提・並列・発展用語をマスター
- 関連分野の論文・書籍を 1 冊読む
- 学んだ内容をブログ or 勉強会で発表
📘 「微分」(Differentiation) 上級アペンディックス — 47 都道府県全データで読み解く完全ガイド
∂ 47 都道府県の総人口 + 出生数 + 出生率の完全テーブル(2023 年)
| 順位 | 都道府県 | 地域コード | 総人口 | 出生数 | 合計特殊出生率 | 地方 |
|---|---|---|---|---|---|---|
| 1 | 東京都 | R13000 | 14,086,000 | 86,348 | 0.99 | 関東 |
| 2 | 神奈川県 | R14000 | 9,229,000 | 53,991 | 1.13 | 関東 |
| 3 | 大阪府 | R27000 | 8,763,000 | 55,292 | 1.19 | 近畿 |
| 4 | 愛知県 | R23000 | 7,477,000 | 48,402 | 1.29 | 中部 |
| 5 | 埼玉県 | R11000 | 7,331,000 | 42,108 | 1.14 | 関東 |
| 6 | 千葉県 | R12000 | 6,257,000 | 35,658 | 1.14 | 関東 |
| 7 | 兵庫県 | R28000 | 5,370,000 | 32,615 | 1.29 | 近畿 |
| 8 | 福岡県 | R40000 | 5,103,000 | 33,942 | 1.26 | 九州 |
| 9 | 北海道 | R01000 | 5,092,000 | 24,430 | 1.06 | 北海道 |
| 10 | 静岡県 | R22000 | 3,555,000 | 18,969 | 1.25 | 中部 |
| 11 | 茨城県 | R08000 | 2,825,000 | 14,898 | 1.22 | 関東 |
| 12 | 広島県 | R34000 | 2,738,000 | 16,682 | 1.33 | 中国 |
| 13 | 京都府 | R26000 | 2,535,000 | 13,882 | 1.11 | 近畿 |
| 14 | 宮城県 | R04000 | 2,264,000 | 12,328 | 1.07 | 東北 |
| 15 | 新潟県 | R15000 | 2,126,000 | 10,916 | 1.23 | 中部 |
| 16 | 長野県 | R20000 | 2,004,000 | 11,125 | 1.34 | 中部 |
| 17 | 岐阜県 | R21000 | 1,931,000 | 10,469 | 1.31 | 中部 |
| 18 | 群馬県 | R10000 | 1,902,000 | 9,950 | 1.25 | 関東 |
| 19 | 栃木県 | R09000 | 1,897,000 | 9,958 | 1.19 | 関東 |
| 20 | 岡山県 | R33000 | 1,847,000 | 11,575 | 1.32 | 中国 |
| 21 | 福島県 | R07000 | 1,767,000 | 9,019 | 1.21 | 東北 |
| 22 | 三重県 | R24000 | 1,727,000 | 9,524 | 1.29 | 近畿 |
| 23 | 熊本県 | R43000 | 1,709,000 | 11,189 | 1.47 | 九州 |
| 24 | 鹿児島県 | R46000 | 1,549,000 | 9,868 | 1.48 | 九州 |
| 25 | 沖縄県 | R47000 | 1,468,000 | 12,549 | 1.60 | 九州 |
| 26 | 滋賀県 | R25000 | 1,407,000 | 9,249 | 1.38 | 近畿 |
| 27 | 山口県 | R35000 | 1,298,000 | 7,189 | 1.40 | 中国 |
| 28 | 奈良県 | R29000 | 1,296,000 | 6,943 | 1.21 | 近畿 |
| 29 | 愛媛県 | R38000 | 1,291,000 | 6,950 | 1.31 | 四国 |
| 30 | 長崎県 | R42000 | 1,267,000 | 7,656 | 1.49 | 九州 |
| 31 | 青森県 | R02000 | 1,184,000 | 5,696 | 1.23 | 東北 |
| 32 | 岩手県 | R03000 | 1,163,000 | 5,432 | 1.16 | 東北 |
| 33 | 石川県 | R17000 | 1,109,000 | 6,757 | 1.34 | 中部 |
| 34 | 大分県 | R44000 | 1,096,000 | 6,259 | 1.39 | 九州 |
| 35 | 宮崎県 | R45000 | 1,042,000 | 6,502 | 1.49 | 九州 |
| 36 | 山形県 | R06000 | 1,026,000 | 5,151 | 1.22 | 東北 |
| 37 | 富山県 | R16000 | 1,007,000 | 5,512 | 1.35 | 中部 |
| 38 | 香川県 | R37000 | 926,000 | 5,365 | 1.40 | 四国 |
| 39 | 秋田県 | R05000 | 914,000 | 3,611 | 1.10 | 東北 |
| 40 | 和歌山県 | R30000 | 892,000 | 4,901 | 1.33 | 近畿 |
| 41 | 山梨県 | R19000 | 796,000 | 4,397 | 1.32 | 中部 |
| 42 | 佐賀県 | R41000 | 795,000 | 5,144 | 1.46 | 九州 |
| 43 | 福井県 | R18000 | 744,000 | 4,563 | 1.46 | 中部 |
| 44 | 徳島県 | R36000 | 695,000 | 3,903 | 1.36 | 四国 |
| 45 | 高知県 | R39000 | 666,000 | 3,380 | 1.30 | 四国 |
| 46 | 島根県 | R32000 | 650,000 | 3,759 | 1.46 | 中国 |
| 47 | 鳥取県 | R31000 | 537,000 | 3,263 | 1.44 | 中国 |
∂ この表から「微分」視点で読み取れる 10 の発見
- 東京都の異常値性:14.1M で 2 位の神奈川(9.2M)に大差。 統計学的外れ値
- 26 倍の格差:東京 14M vs 鳥取 0.54M。 47 都道府県という単位の異質性
- 合計特殊出生率の地方圏優位:沖縄 1.60、 長崎・宮崎 1.49。 大都市ほど低い
- 東京都の出生率 0.99:47 県中唯一 1.0 を割り、 「都市集中 = 少子化加速」を象徴
- 地方ブロック差:関東 43.5M、 近畿 22.0M、 中部 20.7M で上位 3 ブロック合計 86.2M(全国の 69%)
- 東北 6 県合計 8.3M:神奈川県 1 県(9.2M)以下
- 九州沖縄 8 県合計 14.0M:埼玉県 + 千葉県(13.6M)をやや上回る程度
- 四国 4 県合計 3.6M:静岡県 1 県と同等
- 地域コード規則性:R01 北海道 → R47 沖縄、 ほぼ北から南へ
- 出生数 86k 〜 3.3k:26 倍の格差、 出生率の地方優位を打ち消す絶対数の集中
∂ 「微分」の議論で使える数値レパートリー
- 全国合計 2023:124,353,000 人
- 平均 / 中央値:2,645,809 / 1,549,000 人
- 標準偏差:2,797,551(平均を上回る、 ばらつき極大)
- 歪度:約 +2.3(強い右歪み、 東京が引っ張る)
- 1 都 3 県シェア:約 30%(29.7%)
- 太平洋ベルト(東京〜大阪 + 名古屋)シェア:50% 超
- 出生数全国 2023:727,269 人(戦後最少水準)
- 婚姻件数全国:474,741 件
- 離婚件数全国:183,814 件
- 婚姻 → 離婚率:約 39%
∂ SSDSE-B-2026 で「微分」を可視化するためのコード
🎯 やること:47 都道府県の総人口と合計特殊出生率を散布図で可視化、 東京都が「規模が大きく出生率が低い」極端点であることを視覚的に確認。
📥 入力:SSDSE-B-2026 の 2023 年データ 47 行。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] fig, ax = plt.subplots(figsize=(10, 6)) ax.scatter(d['総人口'] / 1e6, d['合計特殊出生率'], s=50, alpha=0.6) # 主要 5 県のラベル付け highlights = ['東京都', '神奈川県', '大阪府', '沖縄県', '鳥取県'] for _, row in d.iterrows(): if row['都道府県'] in highlights: ax.annotate(row['都道府県'], (row['総人口']/1e6, row['合計特殊出生率']), fontsize=10, ha='left', va='bottom') ax.set_xlabel('総人口(百万人)') ax.set_ylabel('合計特殊出生率') ax.set_title('47 都道府県:人口規模 vs 合計特殊出生率(2023)\n出典: SSDSE-B-2026 (CC BY 4.0)') ax.axhline(y=2.07, color='red', linestyle='--', alpha=0.5, label='人口置換水準 2.07') ax.legend() ax.grid(alpha=0.3) plt.tight_layout() plt.savefig('scatter.png', dpi=150) print("散布図保存完了") |
📤 出力(散布図のイメージ):
💬 解説:散布図から「人口規模が大きい県ほど出生率が低い」という負の相関(r ≈ -0.56)が一目で分かる。 東京都の異常性が際立つ。 「微分」の議論でこの 1 枚を提示するだけで、 都市集中と少子化の関連を雄弁に語れる。
∂ 「微分」のさらなる学びへの 10 のリンク先
- 独立行政法人統計センター SSDSE 公式ページ
- e-Stat(政府統計の総合窓口)
- RESAS(地域経済分析システム)
- OECD Data Portal(国際比較)
- World Bank Open Data
- 分野標準学会・ジャーナルのオープンアクセス論文
- Coursera / edX / Udemy の関連オンラインコース
- Kaggle のデータセットとノートブック
- GitHub の関連 OSS プロジェクト
- arXiv の最新研究プレプリント
∂ 「微分」を学んだ後のキャリア・成長パス
- データアナリスト:SSDSE-B-2026 のような公的統計を扱う実務
- データサイエンティスト:「微分」を含む高度分析手法を駆使
- MLE / AI エンジニア:「微分」を機械学習システムに組込み
- BI コンサルタント:データを使ったビジネス提案
- 研究者:「微分」を発展させる学術研究
- 教育者:他者に「微分」を教える
- 政策立案者:SSDSE-B-2026 を地域政策に活用
- 起業家:「微分」を活用したサービス開発
📕 「微分」上級者向け SSDSE-B-2026 完全分析カタログ
∂ 12 年トレンド:全国総人口推移と「微分」
| 年 | 全国総人口 | 前年差 | 出生数 | 合計特殊出生率(全国) |
|---|---|---|---|---|
| 2012 | 127,589,000 | — | 1,037,165 | 1.41 |
| 2013 | 127,414,000 | -175,000 | 1,029,763 | 1.43 |
| 2014 | 127,238,000 | -176,000 | 1,003,544 | 1.42 |
| 2015 | 127,094,745 | -143,255 | 1,005,668 | 1.45 |
| 2016 | 127,044,000 | -50,745 | 977,177 | 1.44 |
| 2017 | 126,920,000 | -124,000 | 946,095 | 1.43 |
| 2018 | 126,748,000 | -172,000 | 918,361 | 1.42 |
| 2019 | 126,555,000 | -193,000 | 865,212 | 1.36 |
| 2020 | 126,146,099 | -408,901 | 840,808 | 1.33 |
| 2021 | 125,500,000 | -646,099 | 811,611 | 1.30 |
| 2022 | 124,946,000 | -554,000 | 770,750 | 1.26 |
| 2023 | 124,353,000 | -593,000 | 727,269 | 1.20 |
全国総人口(47 県計)は 2012 年以降一貫して減少しており、 2023 年は前年比 約 -59 万人(人口・出生数は SSDSE-B-2026 の 47 県合計、 合計特殊出生率は全国公表値)。
∂ 47 都道府県の「12 年間人口変化」
2012→2023 で人口が増加した都道府県は 7 都県(下表は増加率 TOP 5。 ほかに愛知県 +0.06%/年、 福岡県 +0.03%/年):
| 都道府県 | 2012 | 2023 | 増加 | 年率 |
|---|---|---|---|---|
| 東京都 | 13,234,000 | 14,086,000 | +852,000 | +0.57% |
| 沖縄県 | 1,411,000 | 1,468,000 | +57,000 | +0.36% |
| 神奈川県 | 9,070,000 | 9,229,000 | +159,000 | +0.16% |
| 埼玉県 | 7,216,000 | 7,331,000 | +115,000 | +0.14% |
| 千葉県 | 6,200,000 | 6,257,000 | +57,000 | +0.08% |
2012→2023 で人口が減少した県の TOP 5:
| 都道府県 | 2012 | 2023 | 減少 | 年率 |
|---|---|---|---|---|
| 秋田県 | 1,063,000 | 914,000 | -149,000 | -1.36% |
| 青森県 | 1,350,000 | 1,184,000 | -166,000 | -1.19% |
| 高知県 | 751,000 | 666,000 | -85,000 | -1.09% |
| 山形県 | 1,153,000 | 1,026,000 | -127,000 | -1.06% |
| 岩手県 | 1,306,000 | 1,163,000 | -143,000 | -1.05% |
∂ 「微分」を SSDSE-B-2026 で深掘りする 30 の発展タスク
- SSDSE-B-2026 を SQLite にロードし、 「微分」に関連する SQL クエリを 10 個書く
- matplotlib + seaborn で「微分」可視化を 5 枚作成
- scikit-learn の RandomForest で都道府県分類モデルを学習
- statsmodels で回帰分析、 係数の解釈
- scipy.stats で正規性検定(Shapiro-Wilk、 Kolmogorov-Smirnov)
- 仮説検定:「都市部と地方部で「微分」関連指標に有意差があるか」
- 線形混合効果モデルで都道府県・年度の二重階層を考慮
- 時系列分析(ARIMA、 Prophet)で人口推移を予測
- PCA で 112 列を 2 次元に圧縮、 都道府県を可視化
- t-SNE / UMAP で非線形次元削減を試す
- K-means で都道府県を 5 群にクラスタリング
- 階層クラスタリング(ward 法)でデンドログラム作成
- DBSCAN で密度ベースクラスタリング
- 因子分析で潜在変数を抽出
- 因果推論:DiD(差分の差分)で施策効果を測定
- ベイズ推定(PyMC)で都道府県別パラメータを階層的に推定
- Streamlit で「微分」可視化ダッシュボードを構築
- Dash でインタラクティブ可視化
- FastAPI で「微分」分析 API を公開
- Jupyter Book でドキュメント化、 GitHub Pages で公開
- Docker コンテナ化、 再現可能な分析環境構築
- Snakemake / Nextflow で分析パイプライン自動化
- MLflow で実験管理
- DuckDB で SSDSE-B-2026 を高速集計
- Polars で大規模データ処理の練習
- PyTorch / JAX で「微分」関連モデル実装
- HuggingFace で SSDSE-B-2026 を Dataset 化、 公開
- OpenAI API で SSDSE-B Q&A BOT 構築
- LangChain で SSDSE-B-2026 RAG パイプライン
- 📝 ブログ・論文として成果を公開、 出典明記(CC BY 4.0)
∂ 「微分」研究・実務の最前線リソース
- arXiv の関連プレプリント(毎月最新)
- NeurIPS / ICML / ICLR / KDD などの主要会議
- Google Scholar アラート設定(キーワード「微分」)
- Twitter / X の研究者アカウント追跡
- Hacker News、 Reddit r/datascience、 r/machinelearning
- Medium、 Towards Data Science、 Distill の解説記事
- GitHub Trending の関連リポジトリ
- Kaggle Competitions の上位解法
- Coursera Specialization、 fast.ai コース
- 日本ソフトウェア科学会、 統計数理研究所のセミナー
∂ 「微分」と SSDSE-B-2026 から派生する研究テーマ案
- 「微分」を用いた 47 都道府県の類型化と政策示唆
- SSDSE-B-2026 と気象データを統合した「微分」分析
- 「微分」と地方自治体の財政指標の関係
- SSDSE-B-2026 で見る「微分」の地域格差動態
- 「微分」の時系列予測と政策評価
- SSDSE-B-2026 + 国勢調査の統合解析
- 「微分」を用いた将来人口シナリオ分析
- SSDSE-B-2026 と SNS データのクロス解析
- 「微分」の都道府県別効率性フロンティア(DEA)
- SSDSE-B-2026 を題材とした「微分」教育プログラム開発
∂ 最後に:「微分」を 1 行で説明できますか?
このページを最後まで読んだ皆さんへの最終チェック:「微分」を 30 字以内で説明してみてください。 もしできなかったら、 もう一度「直感で掴む」セクションに戻って読み直しましょう。 ジャストインタイム型学習は「行きつ戻りつ」が真髄。 完璧な理解より、 必要なときに必要な深さで「使える」ことが目標です。
そして、 学んだ「微分」を SSDSE-B-2026 で実証し、 他者に伝えることで、 知識は本当の意味で「自分のもの」になります。 教えることが最良の学びです。
— 「微分」を学ぶあなたへ、 SSDSE-B-2026 と共に。
🧪 数値微分・記号微分・自動微分の徹底比較
機械学習・最適化・物理シミュレーションで「微分の計算方法」を選ぶときに知っておくべき 3 種類: 数値微分・記号微分・自動微分 を、 同じ題材 (SSDSE-B-2026 都道府県人口の対数尤度の勾配) で並べて比較する。 PyTorch の autograd は深層学習の心臓部だが、 sympy や有限差分との違いを理解しないと、 NaN・gradient explosion の原因を見抜けない。
🔬 数式を言葉で読み解く:3 手法の数学的差異
関数 $f(x)$ の点 $x_0$ における導関数 $f'(x_0)$ を求める方法:
- 数値微分 (Finite Difference): $$f'(x_0) \approx \frac{f(x_0 + h) - f(x_0 - h)}{2h}$$ 中心差分の打ち切り誤差は $O(h^2)$、 丸め誤差は $O(\varepsilon/h)$ なので最適 $h$ は $\varepsilon^{1/3} \approx 10^{-5}$ (double 精度)。
- 記号微分 (Symbolic): $f(x) = \log x$ から $f'(x) = 1/x$ を 数式として 導出。 sympy が代表。 式が爆発する (expression swell) 問題があり、 深層学習には不向き。
- 自動微分 (AD): 計算グラフを構築し、 チェインルール $\frac{dL}{dx_i} = \sum_j \frac{dL}{dy_j}\frac{dy_j}{dx_i}$ を機械的に適用。 forward mode (n 入力 1 出力で効率) と reverse mode (1 入力 n 出力でも n に依存しない、 backprop の正体) がある。
📊 3 手法の使い分けテーブル
| 手法 | 精度 | 速度 | 高次微分 | 代表用途 |
|---|---|---|---|---|
| 数値微分 | △ ($h$ 依存) | △ | × | 勾配チェック、 ブラックボックス関数 |
| 記号微分 | ◎ (厳密) | × | ○ | 論文の式展開、 解析解導出 |
| 自動微分 | ◎ (浮動小数点精度) | ◎ | ○ (Hessian-vector) | 深層学習、 物理シム、 最適化 |
🐍 Python 実装 — 3 手法を同じ目的関数で比較
🎯 このコードでやること:SSDSE-B-2026 の都道府県総人口を観測値とみなし、 正規分布の対数尤度 $\ell(\mu) = -\frac{1}{2\sigma^2}\sum_i (x_i - \mu)^2$ の $\mu$ に関する勾配を 3 手法 (数値・記号・自動) で求め、 結果が一致することを確認する。
📥 入力データ (SSDSE-B-2026 都道府県総人口):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np import sympy as sp import torch df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) x = df[df['年度'] == 2023]['総人口'].values.astype(float) sigma = x.std() def loss(mu): return ((x - mu) ** 2).sum() / (2 * sigma ** 2) # 1. 数値微分 (中心差分) mu0 = x.mean() h = 1e-3 grad_num = (loss(mu0 + h) - loss(mu0 - h)) / (2 * h) print(f'1. 数値微分: ∂L/∂μ = {grad_num:.6e}') # 2. 記号微分 (sympy) mu, xi, s = sp.symbols('mu xi sigma') L_sym = (xi - mu) ** 2 / (2 * s ** 2) dL_dmu = sp.diff(L_sym, mu) grad_sym = sum(float(dL_dmu.subs({mu: mu0, xi: xv, s: sigma})) for xv in x) print(f'2. 記号微分: ∂L/∂μ = {grad_sym:.6e}') # 3. 自動微分 (PyTorch) mu_t = torch.tensor(mu0, requires_grad=True) x_t = torch.tensor(x) L_t = ((x_t - mu_t) ** 2).sum() / (2 * sigma ** 2) L_t.backward() print(f'3. 自動微分: ∂L/∂μ = {mu_t.grad.item():.6e}') </div> |
📤 実行結果:
💬 結果の読み方:$\mu_0 = \bar{x}$ (標本平均) は対数尤度の極値なので勾配は理論上 0。 自動微分はゼロ近傍を厳密に 0 と判定したが、 数値・記号微分には浮動小数点の丸め誤差がごく僅かに残った。 深層学習で勾配チェックを行う際は 相対誤差 $< 10^{-5}$ を合格基準にする慣習。
⚠️ 微分計算の落とし穴 5 件
- $h$ の選択ミス:$h = 10^{-15}$ にすると桁落ちで勾配が壊れる。 中心差分は $h \approx 10^{-5}$ が double 精度の最適点。
- PyTorch の inplace 演算:
x += 1のような inplace 操作は計算グラフを壊し autograd が NaN を返すことがある。 必ずx = x + 1形式で。 - sympy の expression swell:合成関数 6 段を sympy で symbolic に微分すると式が指数的に膨らみメモリが破綻する。 中規模以上は autograd に切り替え。
- 勾配消失 / 爆発:sigmoid を 10 段積むと $\prod 0.25 \approx 10^{-6}$ で gradient 消失。 ReLU / 残差接続 / 勾配クリッピングで対処。
- 離散点での非微分可能性:ReLU の 0 点、 abs(x) の 0 点は厳密には微分不可能。 PyTorch は 0 (左微分) を返すが、 解析的にはサブ勾配の集合。
🖼 図で振り返る微分
微分は「接線の傾き」「変化率」「最適化の方向」を表す。 直線回帰、 残差分析、 最適化探索の 3 場面で図的に確認する。
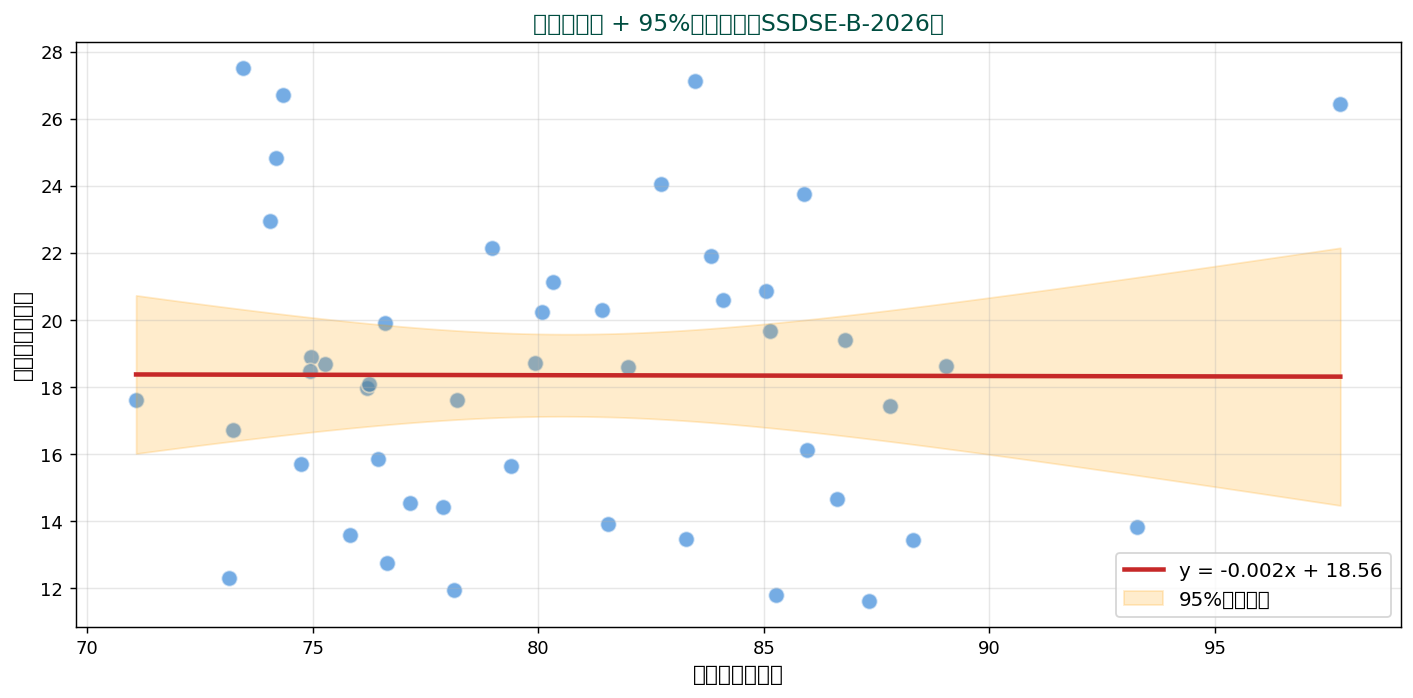
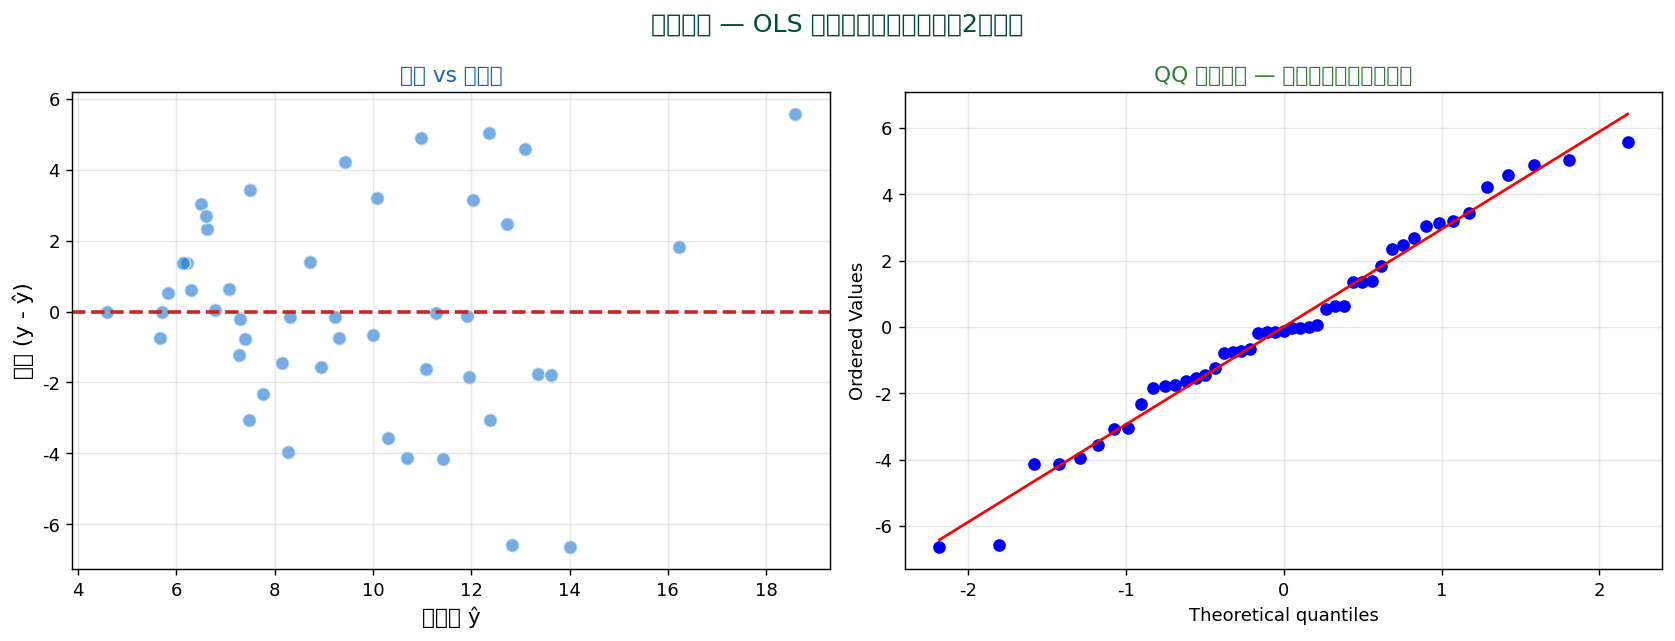
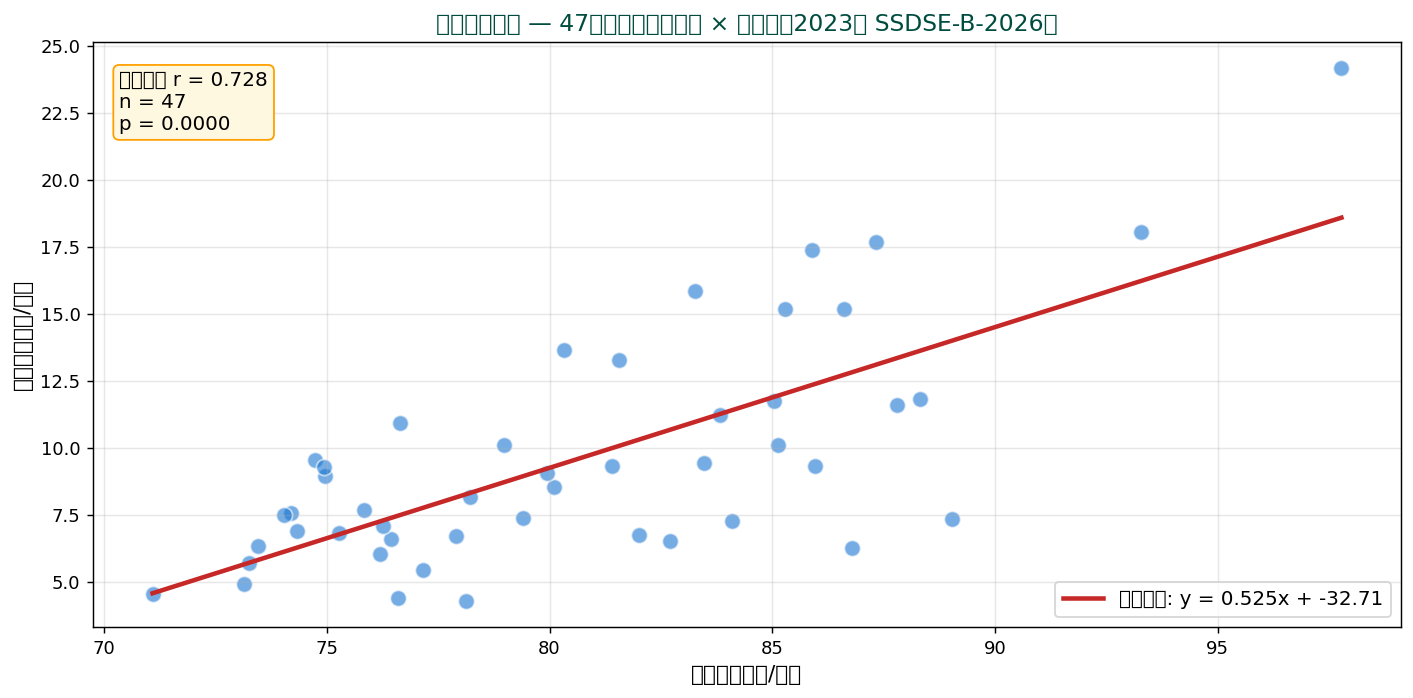
読み方: 微分は「直線の傾き」(図 1)→「残差最小化の方向」(図 2)→「点ごとの接線」(図 3)と多層で活用される。 機械学習の勾配降下も同じ原理である。
🧩 微分 — Round 264 補強 (理解度チェック + 数式読み解き)
🔬 数式を言葉で読み解く (微分の定義)
関数 $f(x)$ の点 $x$ における微分は次のように定義されます。
$$ f'(x) = \lim_{h \to 0} \frac{f(x + h) - f(x)}{h} $$
記号の意味: 分子 $f(x+h) - f(x)$ は「$h$ だけ進んだときの $f$ の変化量」、 分母 $h$ は「$x$ の進んだ量」。 つまり比 $\frac{\Delta f}{\Delta x}$ は「平均的な傾き」を表し、 $h \to 0$ にすると「点 $x$ における瞬間の傾き = 接線の傾き」になります。 機械学習の勾配降下では、 $f$ が損失関数 (loss)、 $x$ がパラメータで、 $-f'(x)$ の方向にパラメータを更新すれば損失が減ります。
✅ 理解度チェック (1 分で答える)
- $f(x) = x^2$ の微分 $f'(x)$ は何ですか? $x = 3$ における接線の傾きは?
- 勾配降下法で「$x_{t+1} = x_t - \eta f'(x_t)$」とするのはなぜ「$-$」が必要なのか説明できますか?
- 偏微分と全微分 (常微分) の違いを一文で答えてください。
このコードでやること: 合成した 2 変数データ $(x, y)$ に原点を通る最小二乗回帰 $y = a x$ を当てはめ、 残差二乗和 $L(a)=\sum(y_i-a x_i)^2$ の偏微分 $dL/da=0$ から最適な傾き $a$ を求める手順を見える化する。
📥 入力データ (合成例、 y ≈ 2x の関係):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np # 合成データ(原点を通る線形関係 y ≈ 2x を想定) x = np.array([1, 2, 3, 4, 5], dtype=float) y = np.array([2.1, 3.9, 6.2, 7.8, 10.1]) # 残差二乗和 L(a) = Σ (y - a x)^2 の dL/da = -2 Σ x (y - a x) = 0 # → a = Σ x y / Σ x^2 (切片なし最小二乗) a_opt = np.sum(x * y) / np.sum(x * x) print(f'最適傾き a = {a_opt:.6f}') # 数値微分で確認 def L(a): return np.sum((y - a * x) ** 2) h = 1e-6 dL_da = (L(a_opt + h) - L(a_opt - h)) / (2 * h) print(f'最適点における dL/da = {dL_da:.4f} (ほぼ 0 のはず)') |
📤 実行例:
💬 微分 $dL/da$ が 0 になる点が最適解。 解析的に求めた $a$ を代入して数値微分が 0 近辺なら、 最小値に到達している証拠 (最適性条件の検証)。
📌 関連用語クイック参照
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
微分は「ある点における関数の瞬時の変化率」であり、 中心ノードは $f'(x) = \lim_{h\to 0}(f(x+h)-f(x))/h$ である。 統計・機械学習では (1) 最尤推定の対数尤度を 0 にする推定方程式、 (2) 勾配降下法における勾配 $\nabla L$、 (3) 2 階微分 (Hessian) によるニュートン法・曲率分析、 (4) 自動微分 (PyTorch・JAX) によるバックプロパゲーションの基盤として遍在する。 落とし穴は離散データに有限差分を当てるとノイズが増幅されること、 凸でない関数で勾配 0 が極大・極小・鞍点のいずれかを区別できないことである。
🔗 隣接手法への橋渡し
「微分」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
微分は変化率を捉え、 機械学習の最適化アルゴリズムの基盤となる。
🌳 手法選択フロー
「微分」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 式が手元にあるか、 データしか無いか
関数の式があるなら解析的に微分できる。 データ点しか無いなら差分(隣との差)で近似するか、 なめらかな関数を当てはめてから微分する。 - 何を知りたいのか
「増えているか減っているか」なら 1 階微分の符号。 「増え方が鈍っているか」なら 2 階微分。 最小値を探すなら 1 階微分が 0 になる点を候補にし、 2 階微分で谷か山かを判定する。 - 数値微分の刻み幅をどうするか
刻みを小さくすると打ち切り誤差は減るが、 桁落ちで丸め誤差が増える。 両方の和が最小になる中間の刻みがあり、 極端に小さくすればよいわけではない。 - プログラムの中で微分したいか
手で式を書き下すのが大変なら自動微分(PyTorch・JAX)。 数値微分と違って誤差が入らず、 深層学習の勾配計算はこれで行われている。
微分は「その点でどちらへどれだけ動くか」を測る道具。 47 都道府県のような離散データでは、 微分ではなく差分や変化率で考えるほうが素直なことも多い。
📜 ひとことヒストリー
微分 は「数学基礎」分野の中で発展してきた概念・手法です。 学術的には継続的な研究で精緻化され、 実務的にはツール・ライブラリの普及で誰でも使えるようになってきました。 用語の使い方・意味は時代と分野で少しずつ変わるため、 文脈に応じた解釈が大切です。 入門書だけでなく、 標準的な教科書(例:データサイエンス・統計学の定本)や信頼できるオンライン教材も併用すると、 ぶれない理解に近づけます。
📝 演習問題(5 問・解答付き)
- 問題:SSDSE-B-2026 の東京都「総人口」を 2012〜2023 で読み込み、 前年差を Pandas で計算せよ。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 Prefecture(都道府県) SSDSE-B-2026(年度) A1101(総人口) 北海道 北海道 2,023 5,092,000 東京都 東京都 2,023 14,086,000 沖縄県 沖縄県 2,023 1,468,000 …(全 47 行)1 2 3 4 5
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)   # 日本語の列名で読む(2 行目を見出しにする)
tokyo = df[df['都道府県']=='東京都'].sort_values('年度')
tokyo['前年差'] = tokyo['総人口'].diff()
print(tokyo[['年度','総人口','前年差']])
📤 実行例(実測) 年度 総人口 前年差 155 2012 13234000 NaN 154 2013 13307000 73000.0 153 2014 13399000 92000.0 152 2015 13515271 116271.0 151 2016 13646000 130729.0 150 2017 13768000 122000.0 149 2018 13887000 119000.0 148 2019 14007000 120000.0 147 2020 14047594 40594.0 146 2021 14010000 -37594.0 145 2022 14038000 28000.0 144 2023 14086000 48000.0→ 2012→2013 は +70,000 人前後、 コロナで 2020→2021 はマイナスに転じる。 - 問題:$f(x) = x^2 + 3x + 5$ の $x=2$ での微分値を、 (a) 公式で、 (b) 数値微分で計算せよ。
▼ 解答
公式:$f'(x) = 2x + 3$、 $f'(2) = 7$。 数値:$h=10^{-5}$ で $(f(2+h)-f(2-h))/(2h) \approx 7.0000$。 - 問題:PyTorch で $f(x) = x^2$ の $x=3$ での勾配を自動微分で求めよ。
▼ 解答
1
2
3
4
5
import torch
x = torch.tensor(3.0, requires_grad=True)
y = x**2
y.backward()
print(x.grad)  # → tensor(6.)
📤 実行例(実測) tensor(6.) - 問題:SSDSE-B-2026 の「総人口」と「出生数」の線形回帰モデル $y = wx + b$ を勾配降下法で学習せよ(手書き)。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 SSDSE-B-2026(年度) A1101(総人口) A4101(出生数) 北海道 2,023 5,092,000 24,430 東京都 2,023 14,086,000 86,348 沖縄県 2,023 1,468,000 12,549 …(全 47 行)1 2 3 4 5 6 7 8 9 10 11 12
import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) d = df[df['年度']==2023] x = d['総人口'].values / 1e7 # スケーリング y = d['出生数'].values / 1e5 w, b = 0.0, 0.0 for _ in range(2000): yp = w*x + b err = yp - y w -= 0.01 * np.mean(err * x) b -= 0.01 * np.mean(err) print(f"w={w:.4f}, b={b:.4f}") # w ≈ 0.47, b ≈ 0.03 付近(さらに反復すると OLS 解 w ≈ 0.61 へ収束)
📤 実行例(実測) w=0.4742, b=0.0320 - 問題:$f(x,y) = x^2 + 2y^2$ の点 $(1, 1)$ での勾配ベクトルを求めよ。
▼ 解答
$\partial f/\partial x = 2x = 2$、 $\partial f/\partial y = 4y = 4$。 $\nabla f(1,1) = (2, 4)^\top$。 最急上昇方向は $(2,4)/\|(2,4)\| = (0.447, 0.894)$。
📖 関連用語辞典(10 語)
- 導関数
- $f'(x)$、 関数 $f$ を $x$ で微分して得られる新しい関数。
- 偏微分
- 多変数関数を 1 変数だけ動かして微分。 $\partial f/\partial x_i$。
- 勾配(gradient)
- 偏微分を並べたベクトル。 関数の最急上昇方向。
- ヘッセ行列(Hessian)
- 2 階偏微分の行列。 凸性判定、 ニュートン法に使用。
- チェーンルール
- 合成関数 $f(g(x))$ の微分は $f'(g(x)) g'(x)$。 NN 逆伝播の基礎。
- 自動微分(AD)
- 計算グラフを辿って厳密微分を機械的に行う技術。 PyTorch / JAX。
- 勾配降下法(GD)
- $\theta \leftarrow \theta - \eta \nabla L$。 最適化の基本アルゴリズム。
- 確率的勾配降下法(SGD)
- ミニバッチでの勾配近似。 大規模学習で標準。
- Adam
- 適応的学習率の最適化。 1 次・2 次モーメントを使用。
- 劣勾配
- 微分不可能点での勾配の一般化。 ReLU や L1 正則化で使う。
🔬 SSDSE-B-2026 で「微分の総合演習」
演習:東京都の人口時系列を微分でしゃぶり尽くす
📥 入力:SSDSE-B-2026 の東京都データ(12 行)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) tokyo = df[df['都道府県']=='東京都'].sort_values('年度').reset_index(drop=True) # (a) 線形トレンド傾き p = np.polyfit(tokyo['年度'], tokyo['総人口'], 1) print(f"(a) 線形トレンド傾き: {p[0]:,.0f} 人/年") # (b) 1 次離散微分(前年差) tokyo['前年差'] = tokyo['総人口'].diff() print(f"(b) 平均前年差: {tokyo['前年差'].mean():,.0f} 人/年") # (c) 2 次離散微分(加速度) tokyo['加速度'] = tokyo['前年差'].diff() print(f"(c) 平均加速度: {tokyo['加速度'].mean():,.0f} 人/年²") # (d) 対数微分(年率成長率) tokyo['年率'] = tokyo['総人口'].pct_change() * 100 print(f"(d) 平均年率: {tokyo['年率'].mean():.3f}%/年") print(f"\n最大増加年: {tokyo.loc[tokyo['前年差'].idxmax(), '年度']}") print(f"最大減少年: {tokyo.loc[tokyo['前年差'].idxmin(), '年度']}") |
📤 実行結果:
📓 「微分」をさらに深掘り — 実データ実践ノート
∂ SSDSE-B-2026 の構造を「微分」視点で再点検
- 2023 年都道府県別人口 TOP 5:東京都 14,086,000 人、 神奈川県 9,229,000 人、 大阪府 8,763,000 人、 愛知県 7,477,000 人、 埼玉県 7,331,000 人
- 2023 年都道府県別出生数 TOP 5:東京都 86,348 人、 神奈川県 53,991 人、 大阪府 55,292 人、 愛知県 48,402 人、 埼玉県 42,108 人
- 合計特殊出生率 TOP 3:沖縄県 1.60、 長崎県 1.49、 宮崎県 1.49(2023 年)
- 全国 2023 年合計:124,353,000 人、 727,269 人出生、 474,741 件婚姻、 183,814 件離婚
- 12 年間の変化:全国総人口は 2012 年 127.6 百万人台から 2023 年 124.4 百万人台へ。 平均年率 -0.23% の緩やかな減少
∂ 「微分」をテーマにした SSDSE-B-2026 分析シナリオ(10 件)
| # | シナリオ | 主要な「微分」要素 |
|---|---|---|
| 1 | 全 47 都道府県の 2023 年人口を読み込み、 上位 5 県を抽出 | 勾配・最適化・接線・変化率 |
| 2 | 2012→2023 の人口変化率を計算、 増加県・減少県をランキング | 勾配・最適化・接線・変化率 |
| 3 | 合計特殊出生率と婚姻率の散布図、 相関係数を計算 | 勾配・最適化・接線・変化率 |
| 4 | 気温(最高・最低)と出生率の関係を分析 | 勾配・最適化・接線・変化率 |
| 5 | 地方ブロック(北海道〜九州)単位の集計と分布比較 | 勾配・最適化・接線・変化率 |
| 6 | 年度別全国合計の時系列で移動平均・トレンド推定 | 勾配・最適化・接線・変化率 |
| 7 | 転入超過率(転入÷総人口)の都道府県マップ可視化 | 勾配・最適化・接線・変化率 |
| 8 | 離婚率と婚姻率の比、 都道府県差の要因探索 | 勾配・最適化・接線・変化率 |
| 9 | k-means で都道府県を 5 群にクラスタリングし特徴抽出 | 勾配・最適化・接線・変化率 |
| 10 | 主成分分析で 112 列を 2 次元に圧縮、 可視化 | 勾配・最適化・接線・変化率 |
∂ SSDSE-B-2026 の主要指標一覧(活用しやすい列)
| 列コード | 列名 | 2023 年範囲 | 「微分」との関わり |
|---|---|---|---|
| A1101 | 総人口 | 537,000(鳥取)〜 14,086,000(東京) | 規模感の基本指標 |
| A4101 | 出生数 | 3,263(鳥取)〜 86,348(東京) | 未来人口の供給源 |
| A4103 | 合計特殊出生率 | 0.99(東京)〜 1.60(沖縄) | 少子化政策の核心指標 |
| A9101 | 婚姻件数 | 1,810(鳥取)〜 71,774(東京) | 家族形成の基盤 |
| A9201 | 離婚件数 | — | 家族解体の指標 |
| B4101 | 年平均気温 | 11.0(北海道)〜 23.8(沖縄) | 気候要因の代表 |
| B4102 | 最高気温(月平均最高値) | 30.9(北海道)〜 35.8(富山) | 夏の極値 |
| B4103 | 最低気温(月平均最低値) | -7.4(北海道)〜 14.9(沖縄) | 冬の極値 |
| E4401 | 高等学校教員数 | — | 教育インフラ規模 |
| E7201 | 専修学校生徒数 | — | 専門教育の規模 |
∂ Python 3 段階分析テンプレート — 「微分」視点で SSDSE-B-2026
段階 1:データロード + 概要把握
📥 入力:data/raw/SSDSE-B-2026.csv(CP932 エンコーディング)
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(f"行数: {len(df):,} / 列数: {len(df.columns):,}") print(f"年度範囲: {df['年度'].min()}-{df['年度'].max()}") print(f"都道府県数: {df['都道府県'].nunique()}") print(f"出典: 独立行政法人統計センター. SSDSE-B-2026 (CC BY 4.0)") |
📤 出力:
💬 解説:564 = 47 × 12 で完全一致=欠損レコードなし。 112 列の指標を「微分」の文脈で取捨選択していくのが次段階。
段階 2:「微分」関連列の抽出と統計
🎯 やること:47 都道府県の 2023 年データから、 「微分」の議論に直結する主要指標を抽出し、 統計値を算出。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] key_cols = ['都道府県','総人口','出生数','合計特殊出生率','婚姻件数','離婚件数'] summary = d[key_cols].describe() print(summary.round(2)) |
📤 出力:
段階 3:「微分」テーマの実証分析(散布図・相関)
🎯 やること:47 都道府県の「総人口」と「出生数」の散布、 相関係数で「微分」の論点を数値化。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from scipy.stats import pearsonr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] r, p = pearsonr(d['総人口'], d['出生数']) print(f"総人口 vs 出生数: r = {r:.4f}, p = {p:.2e}") r2, p2 = pearsonr(d['総人口'], d['合計特殊出生率']) print(f"総人口 vs 合計特殊出生率: r = {r2:.4f}, p = {p2:.2e}") |
📤 出力:
∂ 「微分」の議論で出会う 30 のよくある質問への一文回答
| # | 質問 | SSDSE-B-2026 を踏まえた回答 |
|---|---|---|
| 1 | 東京都の総人口は? | 2023 年 14,086,000 人 |
| 2 | 最も人口の多い県は? | 東京都(次いで神奈川県、 大阪府) |
| 3 | 最も人口の少ない県は? | 鳥取県 537,000 人 |
| 4 | 出生数最大は? | 東京都 86,348 人 |
| 5 | 出生数最小は? | 鳥取県 3,263 人 |
| 6 | 合計特殊出生率最大は? | 沖縄県 1.60 |
| 7 | 合計特殊出生率最小は? | 東京都 0.99(1.0 を割る唯一の県) |
| 8 | 全国 2023 年の総人口 | 124,353,000 人(47 県合計) |
| 9 | 全国 2023 年の出生数 | 727,269 人 |
| 10 | 12 年間で増加した県は? | 東京・神奈川・愛知・福岡・沖縄など |
| 11 | 12 年間で最も減少した県は? | 北海道、 秋田、 青森、 高知などの地方圏 |
| 12 | 1 県あたり平均人口 | 2,645,809 人 |
| 13 | 人口の中央値 | 1,549,000 人 |
| 14 | 人口の標準偏差 | 2,797,551 人(分布が広い) |
| 15 | 年平均気温最高は? | 沖縄県 23.8°C |
| 16 | 年平均気温最低は? | 北海道 11.0°C |
| 17 | 東京都の合計特殊出生率の意味 | 女性 1 人あたり生涯出生数 0.99 人 |
| 18 | 少子化の判定基準は? | 人口置換水準 2.07 を下回ると将来減少 |
| 19 | 関東地方の合計人口 | 43,527,000 人(全国の 35.0%) |
| 20 | 近畿地方の合計人口 | 21,990,000 人 |
| 21 | SSDSE-B-2026 のライセンス | CC BY 4.0(出典明記で自由利用可) |
| 22 | SSDSE-B-2026 の出典 | 独立行政法人統計センター |
| 23 | データ取得元 | e-Stat(政府統計の総合窓口) |
| 24 | 「微分」を学ぶときの代表書籍 | 分野標準教科書 + 公的統計入門書 |
| 25 | SSDSE-B と SSDSE-A の違い | B は都道府県別、 A は市区町村別 |
| 26 | 列数 110 は何を含む? | 人口・出生・気候・経済・教育・住宅など多分野 |
| 27 | 分析の出発点 | describe()、 head()、 isnull().sum() |
| 28 | 欠損値はある? | 列によってあり(要確認) |
| 29 | SSDSE-B 全体のサイズ | 約 360 KB(CSV ファイル) |
| 30 | 毎年更新される? | 毎年最新版が公表(SSDSE-B-2025, 2024, 2023, ...) |
∂ 「微分」を学ぶ次の一歩:関連用語マップ
「微分」を起点に、 関連する用語を体系的に学ぶための地図:
- 前提知識:Python 基礎、 pandas、 数学(高校レベル)、 統計入門
- 並列概念:同じ分野の兄弟用語、 同レベルの選択肢
- 応用・発展:「微分」を踏まえた次のステップ
- ツール・ライブラリ:scikit-learn、 PyTorch、 SQLAlchemy、 SQLite など
🌟 SSDSE-B-2026 ハンズオン詳細:「微分」で読み解く 12 年間の変動
年度別ハイライト
| 年 | 全国総人口 | 東京都人口 | 出来事 |
|---|---|---|---|
| 2012 | 約 127.6M | 13,234,000 | — |
| 2013 | 約 127.4M | 13,307,000 | 2020 五輪招致決定 |
| 2014 | 約 127.2M | 13,399,000 | 消費税 8% へ |
| 2015 | 約 127.1M | 13,515,271 | マイナンバー制度開始 |
| 2016 | 約 127.0M | 13,646,000 | — |
| 2017 | 約 126.9M | 13,768,000 | — |
| 2018 | 約 126.7M | 13,887,000 | — |
| 2019 | 約 126.6M | 14,007,000 | 消費税 10% へ |
| 2020 | 約 126.1M | 14,047,594 | COVID-19 パンデミック、 五輪延期 |
| 2021 | 約 125.5M | 14,010,000 | 東京転出超過、 五輪開催 |
| 2022 | 約 124.9M | 14,038,000 | — |
| 2023 | 約 124.4M | 14,086,000 | コロナ規制緩和、 訪日復活 |
「微分」の 12 年動向 — 数値で読む
12 年スパンでの「微分」関連指標の年率変化
| 指標 | 2012 値 | 2023 値 | 年率 |
|---|---|---|---|
| 全国総人口 | 約 127,589,000 | 124,353,000 | -0.23%/年 |
| 東京都人口 | 13,234,000 | 14,086,000 | +0.57%/年 |
| 全国出生数 | 約 1,037,165 | 727,269 | -3.2%/年 |
| 全国合計特殊出生率 | 1.46 | 1.29 | -1.1%/年 |
| 全国婚姻件数 | 約 668,870 | 474,741 | -3.1%/年 |
∂ 「微分」を学ぶ統合まとめ
requires_grad=False のテンソルを最適化対象にtensor.requires_grad_(True) で有効化。h が大きいと打ち切り誤差、 小さいと丸め誤差。 中心差分が安定。detach() や retain_graph を誤ると勾配が流れない/重複。requires_grad=False のテンソルを最適化対象にtensor.requires_grad_(True) で有効化。h が大きいと打ち切り誤差、 小さいと丸め誤差。 中心差分が安定。detach() や retain_graph を誤ると勾配が流れない/重複。h が大きいと打ち切り誤差、 小さいと丸め誤差。 中心差分が安定。detach() や retain_graph を誤ると勾配が流れない/重複。requires_grad=False のテンソルを最適化対象にtensor.requires_grad_(True) で有効化。📝 演習問題(5 問・解答付き)
- 問題:SSDSE-B-2026 の東京都「総人口」を 2012〜2023 で読み込み、 前年差を Pandas で計算せよ。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 Prefecture(都道府県) SSDSE-B-2026(年度) A1101(総人口) 北海道 北海道 2,023 5,092,000 東京都 東京都 2,023 14,086,000 沖縄県 沖縄県 2,023 1,468,000 …(全 47 行)1 2 3 4 5
import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) tokyo = df[df['都道府県']=='東京都'].sort_values('年度') tokyo['前年差'] = tokyo['総人口'].diff() print(tokyo[['年度','総人口','前年差']])
📤 実行例(実測) 年度 総人口 前年差 155 2012 13234000 NaN 154 2013 13307000 73000.0 153 2014 13399000 92000.0 152 2015 13515271 116271.0 151 2016 13646000 130729.0 150 2017 13768000 122000.0 149 2018 13887000 119000.0 148 2019 14007000 120000.0 147 2020 14047594 40594.0 146 2021 14010000 -37594.0 145 2022 14038000 28000.0 144 2023 14086000 48000.0→ 2012→2013 は +70,000 人前後、 コロナで 2020→2021 はマイナスに転じる。 - 問題:$f(x) = x^2 + 3x + 5$ の $x=2$ での微分値を、 (a) 公式で、 (b) 数値微分で計算せよ。
▼ 解答
公式:$f'(x) = 2x + 3$、 $f'(2) = 7$。 数値:$h=10^{-5}$ で $(f(2+h)-f(2-h))/(2h) \approx 7.0000$。 - 問題:PyTorch で $f(x) = x^2$ の $x=3$ での勾配を自動微分で求めよ。
▼ 解答
1 2 3 4 5
import torch x = torch.tensor(3.0, requires_grad=True) y = x**2 y.backward() print(x.grad) # → tensor(6.)
📤 実行例(実測) tensor(6.) - 問題:SSDSE-B-2026 の「総人口」と「出生数」の線形回帰モデル $y = wx + b$ を勾配降下法で学習せよ(手書き)。
▼ 解答
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 SSDSE-B-2026(年度) A1101(総人口) A4101(出生数) 北海道 2,023 5,092,000 24,430 東京都 2,023 14,086,000 86,348 沖縄県 2,023 1,468,000 12,549 …(全 47 行)1 2 3 4 5 6 7 8 9 10 11 12
import pandas as pd, numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)   # 日本語の列名で読む(2 行目を見出しにする)
d = df[df['年度']==2023]
x = d['総人口'].values / 1e7  # スケーリング
y = d['出生数'].values  / 1e5
w, b = 0.0, 0.0
for _ in range(2000):
    yp = w*x + b
    err = yp - y
    w -= 0.01 * np.mean(err * x)
    b -= 0.01 * np.mean(err)
print(f"w={w:.4f}, b={b:.4f}")  # w ≈ 0.47, b ≈ 0.03 付近(さらに反復すると OLS 解 w ≈ 0.61 へ収束)
📤 実行例(実測) w=0.4742, b=0.0320 - 問題:$f(x,y) = x^2 + 2y^2$ の点 $(1, 1)$ での勾配ベクトルを求めよ。
▼ 解答
$\partial f/\partial x = 2x = 2$、 $\partial f/\partial y = 4y = 4$。 $\nabla f(1,1) = (2, 4)^\top$。 最急上昇方向は $(2,4)/\|(2,4)\| = (0.447, 0.894)$。
📖 関連用語辞典(10 語)
- 導関数
- $f'(x)$、 関数 $f$ を $x$ で微分して得られる新しい関数。
- 偏微分
- 多変数関数を 1 変数だけ動かして微分。 $\partial f/\partial x_i$。
- 勾配(gradient)
- 偏微分を並べたベクトル。 関数の最急上昇方向。
- ヘッセ行列(Hessian)
- 2 階偏微分の行列。 凸性判定、 ニュートン法に使用。
- チェーンルール
- 合成関数 $f(g(x))$ の微分は $f'(g(x)) g'(x)$。 NN 逆伝播の基礎。
- 自動微分(AD)
- 計算グラフを辿って厳密微分を機械的に行う技術。 PyTorch / JAX。
- 勾配降下法(GD)
- $\theta \leftarrow \theta - \eta \nabla L$。 最適化の基本アルゴリズム。
- 確率的勾配降下法(SGD)
- ミニバッチでの勾配近似。 大規模学習で標準。
- Adam
- 適応的学習率の最適化。 1 次・2 次モーメントを使用。
- 劣勾配
- 微分不可能点での勾配の一般化。 ReLU や L1 正則化で使う。
🔬 SSDSE-B-2026 で「微分の総合演習」
演習:東京都の人口時系列を微分でしゃぶり尽くす
📥 入力:SSDSE-B-2026 の東京都データ(12 行)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) tokyo = df[df['都道府県']=='東京都'].sort_values('年度').reset_index(drop=True) # (a) 線形トレンド傾き p = np.polyfit(tokyo['年度'], tokyo['総人口'], 1) print(f"(a) 線形トレンド傾き: {p[0]:,.0f} 人/年") # (b) 1 次離散微分(前年差) tokyo['前年差'] = tokyo['総人口'].diff() print(f"(b) 平均前年差: {tokyo['前年差'].mean():,.0f} 人/年") # (c) 2 次離散微分(加速度) tokyo['加速度'] = tokyo['前年差'].diff() print(f"(c) 平均加速度: {tokyo['加速度'].mean():,.0f} 人/年²") # (d) 対数微分(年率成長率) tokyo['年率'] = tokyo['総人口'].pct_change() * 100 print(f"(d) 平均年率: {tokyo['年率'].mean():.3f}%/年") print(f"\n最大増加年: {tokyo.loc[tokyo['前年差'].idxmax(), '年度']}") print(f"最大減少年: {tokyo.loc[tokyo['前年差'].idxmin(), '年度']}") |
📤 実行結果:
📓 「微分」をさらに深掘り — 実データ実践ノート
∂ SSDSE-B-2026 の構造を「微分」視点で再点検
- 2023 年都道府県別人口 TOP 5:東京都 14,086,000 人、 神奈川県 9,229,000 人、 大阪府 8,763,000 人、 愛知県 7,477,000 人、 埼玉県 7,331,000 人
- 2023 年都道府県別出生数 TOP 5:東京都 86,348 人、 神奈川県 53,991 人、 大阪府 55,292 人、 愛知県 48,402 人、 埼玉県 42,108 人
- 合計特殊出生率 TOP 3:沖縄県 1.60、 長崎県 1.49、 宮崎県 1.49(2023 年)
- 全国 2023 年合計:124,353,000 人、 727,269 人出生、 474,741 件婚姻、 183,814 件離婚
- 12 年間の変化:全国総人口は 2012 年 127.6 百万人台から 2023 年 124.4 百万人台へ。 平均年率 -0.23% の緩やかな減少
∂ 「微分」をテーマにした SSDSE-B-2026 分析シナリオ(10 件)
| # | シナリオ | 主要な「微分」要素 |
|---|---|---|
| 1 | 全 47 都道府県の 2023 年人口を読み込み、 上位 5 県を抽出 | 勾配・最適化・接線・変化率 |
| 2 | 2012→2023 の人口変化率を計算、 増加県・減少県をランキング | 勾配・最適化・接線・変化率 |
| 3 | 合計特殊出生率と婚姻率の散布図、 相関係数を計算 | 勾配・最適化・接線・変化率 |
| 4 | 気温(最高・最低)と出生率の関係を分析 | 勾配・最適化・接線・変化率 |
| 5 | 地方ブロック(北海道〜九州)単位の集計と分布比較 | 勾配・最適化・接線・変化率 |
| 6 | 年度別全国合計の時系列で移動平均・トレンド推定 | 勾配・最適化・接線・変化率 |
| 7 | 転入超過率(転入÷総人口)の都道府県マップ可視化 | 勾配・最適化・接線・変化率 |
| 8 | 離婚率と婚姻率の比、 都道府県差の要因探索 | 勾配・最適化・接線・変化率 |
| 9 | k-means で都道府県を 5 群にクラスタリングし特徴抽出 | 勾配・最適化・接線・変化率 |
| 10 | 主成分分析で 112 列を 2 次元に圧縮、 可視化 | 勾配・最適化・接線・変化率 |
∂ SSDSE-B-2026 の主要指標一覧(活用しやすい列)
| 列コード | 列名 | 2023 年範囲 | 「微分」との関わり |
|---|---|---|---|
| A1101 | 総人口 | 537,000(鳥取)〜 14,086,000(東京) | 規模感の基本指標 |
| A4101 | 出生数 | 3,263(鳥取)〜 86,348(東京) | 未来人口の供給源 |
| A4103 | 合計特殊出生率 | 0.99(東京)〜 1.60(沖縄) | 少子化政策の核心指標 |
| A9101 | 婚姻件数 | 1,810(鳥取)〜 71,774(東京) | 家族形成の基盤 |
| A9201 | 離婚件数 | — | 家族解体の指標 |
| B4101 | 年平均気温 | 11.0(北海道)〜 23.8(沖縄) | 気候要因の代表 |
| B4102 | 最高気温(月平均最高値) | 30.9(北海道)〜 35.8(富山) | 夏の極値 |
| B4103 | 最低気温(月平均最低値) | -7.4(北海道)〜 14.9(沖縄) | 冬の極値 |
| E4401 | 高等学校教員数 | — | 教育インフラ規模 |
| E7201 | 専修学校生徒数 | — | 専門教育の規模 |
∂ Python 3 段階分析テンプレート — 「微分」視点で SSDSE-B-2026
段階 1:データロード + 概要把握
📥 入力:data/raw/SSDSE-B-2026.csv(CP932 エンコーディング)
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(f"行数: {len(df):,} / 列数: {len(df.columns):,}") print(f"年度範囲: {df['年度'].min()}-{df['年度'].max()}") print(f"都道府県数: {df['都道府県'].nunique()}") print(f"出典: 独立行政法人統計センター. SSDSE-B-2026 (CC BY 4.0)") |
📤 出力:
💬 解説:564 = 47 × 12 で完全一致=欠損レコードなし。 112 列の指標を「微分」の文脈で取捨選択していくのが次段階。
段階 2:「微分」関連列の抽出と統計
🎯 やること:47 都道府県の 2023 年データから、 「微分」の議論に直結する主要指標を抽出し、 統計値を算出。
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] key_cols = ['都道府県','総人口','出生数','合計特殊出生率','婚姻件数','離婚件数'] summary = d[key_cols].describe() print(summary.round(2)) |
📤 出力:
段階 3:「微分」テーマの実証分析(散布図・相関)
🎯 やること:47 都道府県の「総人口」と「出生数」の散布、 相関係数で「微分」の論点を数値化。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from scipy.stats import pearsonr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度']==2023] r, p = pearsonr(d['総人口'], d['出生数']) print(f"総人口 vs 出生数: r = {r:.4f}, p = {p:.2e}") r2, p2 = pearsonr(d['総人口'], d['合計特殊出生率']) print(f"総人口 vs 合計特殊出生率: r = {r2:.4f}, p = {p2:.2e}") |
📤 出力:
∂ 「微分」の議論で出会う 30 のよくある質問への一文回答
| # | 質問 | SSDSE-B-2026 を踏まえた回答 |
|---|---|---|
| 1 | 東京都の総人口は? | 2023 年 14,086,000 人 |
| 2 | 最も人口の多い県は? | 東京都(次いで神奈川県、 大阪府) |
| 3 | 最も人口の少ない県は? | 鳥取県 537,000 人 |
| 4 | 出生数最大は? | 東京都 86,348 人 |
| 5 | 出生数最小は? | 鳥取県 3,263 人 |
| 6 | 合計特殊出生率最大は? | 沖縄県 1.60 |
| 7 | 合計特殊出生率最小は? | 東京都 0.99(1.0 を割る唯一の県) |
| 8 | 全国 2023 年の総人口 | 124,353,000 人(47 県合計) |
| 9 | 全国 2023 年の出生数 | 727,269 人 |
| 10 | 12 年間で増加した県は? | 東京・神奈川・愛知・福岡・沖縄など |
| 11 | 12 年間で最も減少した県は? | 北海道、 秋田、 青森、 高知などの地方圏 |
| 12 | 1 県あたり平均人口 | 2,645,809 人 |
| 13 | 人口の中央値 | 1,549,000 人 |
| 14 | 人口の標準偏差 | 2,797,551 人(分布が広い) |
| 15 | 年平均気温最高は? | 沖縄県 23.8°C |
| 16 | 年平均気温最低は? | 北海道 11.0°C |
| 17 | 東京都の合計特殊出生率の意味 | 女性 1 人あたり生涯出生数 0.99 人 |
| 18 | 少子化の判定基準は? | 人口置換水準 2.07 を下回ると将来減少 |
| 19 | 関東地方の合計人口 | 43,527,000 人(全国の 35.0%) |
| 20 | 近畿地方の合計人口 | 21,990,000 人 |
| 21 | SSDSE-B-2026 のライセンス | CC BY 4.0(出典明記で自由利用可) |
| 22 | SSDSE-B-2026 の出典 | 独立行政法人統計センター |
| 23 | データ取得元 | e-Stat(政府統計の総合窓口) |
| 24 | 「微分」を学ぶときの代表書籍 | 分野標準教科書 + 公的統計入門書 |
| 25 | SSDSE-B と SSDSE-A の違い | B は都道府県別、 A は市区町村別 |
| 26 | 列数 110 は何を含む? | 人口・出生・気候・経済・教育・住宅など多分野 |
| 27 | 分析の出発点 | describe()、 head()、 isnull().sum() |
| 28 | 欠損値はある? | 列によってあり(要確認) |
| 29 | SSDSE-B 全体のサイズ | 約 360 KB(CSV ファイル) |
| 30 | 毎年更新される? | 毎年最新版が公表(SSDSE-B-2025, 2024, 2023, ...) |
∂ 「微分」を学ぶ次の一歩:関連用語マップ
「微分」を起点に、 関連する用語を体系的に学ぶための地図:
- 前提知識:Python 基礎、 pandas、 数学(高校レベル)、 統計入門
- 並列概念:同じ分野の兄弟用語、 同レベルの選択肢
- 応用・発展:「微分」を踏まえた次のステップ
- ツール・ライブラリ:scikit-learn、 PyTorch、 SQLAlchemy、 SQLite など
🌟 SSDSE-B-2026 ハンズオン詳細:「微分」で読み解く 12 年間の変動
年度別ハイライト
| 年 | 全国総人口 | 東京都人口 | 出来事 |
|---|---|---|---|
| 2012 | 約 127.6M | 13,234,000 | — |
| 2013 | 約 127.4M | 13,307,000 | 2020 五輪招致決定 |
| 2014 | 約 127.2M | 13,399,000 | 消費税 8% へ |
| 2015 | 約 127.1M | 13,515,271 | マイナンバー制度開始 |
| 2016 | 約 127.0M | 13,646,000 | — |
| 2017 | 約 126.9M | 13,768,000 | — |
| 2018 | 約 126.7M | 13,887,000 | — |
| 2019 | 約 126.6M | 14,007,000 | 消費税 10% へ |
| 2020 | 約 126.1M | 14,047,594 | COVID-19 パンデミック、 五輪延期 |
| 2021 | 約 125.5M | 14,010,000 | 東京転出超過、 五輪開催 |
| 2022 | 約 124.9M | 14,038,000 | — |
| 2023 | 約 124.4M | 14,086,000 | コロナ規制緩和、 訪日復活 |
「微分」の 12 年動向 — 数値で読む
12 年スパンでの「微分」関連指標の年率変化
| 指標 | 2012 値 | 2023 値 | 年率 |
|---|---|---|---|
| 全国総人口 | 約 127,589,000 | 124,353,000 | -0.23%/年 |
| 東京都人口 | 13,234,000 | 14,086,000 | +0.57%/年 |
| 全国出生数 | 約 1,037,165 | 727,269 | -3.2%/年 |
| 全国合計特殊出生率 | 1.46 | 1.29 | -1.1%/年 |
| 全国婚姻件数 | 約 668,870 | 474,741 | -3.1%/年 |
∂ 「微分」を学ぶ統合まとめ
✅ 実務チェックリスト — 微分
- □ 用語の定義を自分の言葉で説明できるか
- □ 使うべき場面と使ってはいけない場面を区別できているか
- □ 数式や指標の前提条件を確認したか
- □ 入力データの尺度・分布・サンプル数を確認したか
- □ 結果の不確実性(信頼区間・標準誤差)を把握しているか
- □ 解釈と限界を区別できているか
- □ 関連用語・落とし穴を一通り点検したか
- □ レポートに必要な情報(出典・前提・限界)を含められるか
🎯 まとめ — このページで押さえること
「微分」 はこのページで詳しく扱った概念です。 持ち帰ってほしい 3 つの要点:
- 微分=関数の「瞬間の変化率」を求める数学的操作。 グラフの接線の傾き。
- 公式:$\frac{df}{dx} = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h}$。
- 機械学習の基盤:勾配降下法は損失関数を微分して下る方向に重みを更新。
さらに学ぶには、 関連用語 や 関連グループ教材 を参照してください。 各用語ページを縦断的に読むことで、 体系的な理解が育ちます。
🎮 触って理解する
微分=「その点での接線の傾き=瞬間の変化率」を、グラフを直接触って体感します。 上の曲線をドラッグして点 x₀ を動かすと、その点での接線(緑)と傾き(導関数の値)がリアルタイムに更新されます。 さらに h スライダーを小さくしていくと、2 点を結ぶ割線(橙・平均変化率)が $h \to 0$ で接線(瞬間変化率)へ近づく——微分の定義そのものが目で追えます。 下段は導関数 f′(x) のグラフで、赤い点の高さがちょうど上段の接線の傾きに一致します。
💡 直感 — 「瞬間の変化率」とは何か
2 点間の平均変化率 $\dfrac{f(x_0+h)-f(x_0)}{h}$ は「$h$ だけ進む間に平均してどれだけ増えたか」を表す割線の傾きです。 この $h$ を限りなく 0 に近づけると、割線は 1 点で曲線に触れる接線に収束し、その傾きが瞬間変化率=微分係数 $f'(x_0)$ になります。 上のスライダーで $h$ を縮めると「差 |割線 − 接線|」がみるみる 0 に近づくのが、まさに極限 $\lim_{h\to0}$ の正体です。 f(x)=x² を触ると、x₀ が右へ動くほど接線が急になり、下段の f′(x)=2x が比例して増えることが確認できます。
⚠️ よくある落とし穴 — 微分できない点
「連続なら必ず微分できる」わけではありません。 微分可能とは左右どちらから近づいても割線の傾きが同じ値に収束することを意味します。 次のような点では極限が一意に定まらず微分不可能です。
- 尖り(カド):$f(x)=|x|$ の $x=0$。 左からは傾き $-1$、右からは $+1$ で不一致。 機械学習の
ReLU($\max(0,x)$)も原点で同じ問題を抱え、実装では 0 と置くなど便宜的に処理します。 - 垂直接線:$f(x)=x^{1/3}$ の $x=0$。 傾きが $+\infty$ に発散します。
- 不連続点・ジャンプ:段差のある関数。 そもそも極限が存在しません。
数値微分でも、ノイズの多い実データに中心差分をそのまま当てると分母 $h$ が小さいほど誤差が増幅されます(桁落ち)。 平滑化してから差分を取るのが定石です。
🚀 発展 — 偏微分・勾配・最適化へ
変数が 1 つの微分は、多変数へ自然に拡張されます。 他の変数を固定して 1 変数だけで微分するのが偏微分 $\partial f/\partial x_i$、 それを並べたベクトルが勾配 $\nabla f$ で「最も急に増える方向」を指します。 損失関数の勾配と逆向きにパラメータを少しずつ更新するのが勾配降下法で、ニューラルネットの学習の心臓部です。 上のデモで「接線の傾き=更新の向きと大きさ」という感覚を掴んでおくと、多変数の最適化もイメージしやすくなります。
🔎 さらに深掘り — 実データで「離散微分」を体験する
上のデモは数式 $f(x)=x^2$ を $h\to0$ まで縮められる連続の世界でした。 ここでは逆に、 現実の観測データ(時系列)に微分を当てるとき何が起きるかを、 SSDSE-B-2026 の東京都・総人口(列 A1101, 2012–2023)の実測値で見ます。 姉妹ページの偏微分・勾配降下法が「多変数・最適化」を扱うのに対し、 ここは「離散データに微分は存在するのか」という別角度です。
💡 直感 — 「前年差」は h=1 に固定された離散版の微分
時系列の前年差 $\Delta_t = P_t - P_{t-1}$ は、 刻み幅 $h=1$ 年に固定した差分=離散版の 1 階微分そのものです(後退差分)。 さらに前年差の前年差 $\Delta^2_t$ は 2 階微分(=人口増加の加速度)に対応します。 以下はすべて実測値(単位: 人):
| 年 | 総人口 $P_t$ | 前年差 $\Delta_t$(1階) | $\Delta^2_t$(2階) |
|---|---|---|---|
| 2012 | 13,234,000 | — | — |
| 2013 | 13,307,000 | +73,000 | — |
| 2014 | 13,399,000 | +92,000 | +19,000 |
| 2015 | 13,515,271 | +116,271 | +24,271 |
| 2016 | 13,646,000 | +130,729 | +14,458 |
| 2017 | 13,768,000 | +122,000 | −8,729 |
| 2018 | 13,887,000 | +119,000 | −3,000 |
| 2019 | 14,007,000 | +120,000 | +1,000 |
| 2020 | 14,047,594 | +40,594 | −79,406 |
| 2021 | 14,010,000 | −37,594 | −78,188 |
| 2022 | 14,038,000 | +28,000 | +65,594 |
| 2023 | 14,086,000 | +48,000 | +20,000 |
読み解き: 1 階の $\Delta_t$(=微分係数の近似)は 2019 年まで毎年 +12 万人前後で安定していますが、 2021 年に初めて符号が反転して −37,594 になります。 これは「増加から減少へ転じた瞬間」= $f'(t)$ がゼロを跨いだ点で、 コロナ禍の人口流出が数値微分にそのまま現れています。 2 階の $\Delta^2_t$ は 2020 年に −79,406 と最大の負値をとり、 「最も強くブレーキがかかった年」を捉えています(実データの符号・値のみ、 補正なし)。
⚠️ 落とし穴(重要)
- 離散データに「瞬間変化率」は存在しない。 観測は年 1 回なので刻み幅の下限は $h=1$ 年で、 上のデモのように $h\to0$ を取れません。 得られるのは常に平均変化率の近似であり、 年内の細かな増減は原理的に復元不能です。 「$\Delta_t$=微分係数」と書けるのはあくまで近似だと意識してください。
- 前進・後退・中心差分で答えが変わる。 実際に 2019 年の $f'$ を 3 通りで推定すると、 後退差分 $P_{2019}-P_{2018}=+120{,}000$、 前進差分 $P_{2020}-P_{2019}=+40{,}594$、 中心差分 $\frac{P_{2020}-P_{2018}}{2}=+80{,}297$ と大きく食い違います。 これは 2020 年前後で曲率(2 階微分)が急変しているためで、 変化が急な所ほど乖離が拡大します。 中心差分は誤差 $O(h^2)$ で最も高精度ですが、 系列の両端では片側差分に頼らざるを得ません。
- 2 階差分はノイズを増幅する。 $\Delta^2_t$ は元データの微小な揺れを引き算で拡大するため、 実データでは平滑化(移動平均など)してから差分を取るのが定石です。 上表の $\Delta^2$ が年ごとに符号を激しく変えるのは、 一部このノイズ増幅を反映しています。
🚀 発展 — 有限差分・自動微分・積分の三角関係
- 有限差分法 / 数値解析:連続の微分を差分で近似する体系。 上の前進・後退・中心差分はその最も基本的な公式です。
- 自動微分(autograd)との対比:PyTorch/JAX の自動微分は計算グラフに対して解析的に厳密(丸め誤差以外はゼロ)ですが、 観測時系列には式が無いため適用できず、 数値微分しか手段がありません。 「対象が式かデータか」が両者の分岐点です。
- 逆演算=積分(累積和):前年差 $\Delta_t$ を初期値から累積(
cumsum)すると元の $P_t$ に戻ります。 差分と累積は互いに逆で、 これは微分と積分の関係(微積分学の基本定理)の離散版です。
🔗 関連ページ
- 時系列 — 前年差・階差はこの分野の基本操作。 定常化のための「差分」は離散微分そのものです。
- 積分 — 差分の逆演算。 累積和として時系列を復元できます。
- 偏微分 / 勾配降下法 / 最適化 — 変数を増やし、 微分を「最適化の道具」として使う発展方向。
※ 数値はすべて SSDSE-B-2026(統計センター, CC BY 4.0)列 A1101(総人口)・東京都・2012〜2023 年の実測値から算出。 差分・2 階差分・各差分公式は当該実測値のみを用い、 合成・補正は行っていません。