🔖 キーワード索引
「sql」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「sql」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「sql の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
SQLはデータを取り出すための言葉です。
表形式のデータを操作するために使います。
スマホアプリのユーザー管理などで使われます。
ここではSQLでできることを学びます。
SQL:リレーショナルDBの操作言語
- 表形式データの問い合わせ・更新のための言語。
- 主要命令:
SELECT, FROM, WHERE, GROUP BY, HAVING, ORDER BY, JOIN。 - 宣言型言語:「何が欲しい」を書けば、 DB エンジンが「どう取るか」を最適化。
- 拡張:Window 関数・CTE・JSON 操作などモダン SQL は強力。
📍 文脈ボックス
🍰 まずはやさしく
SQLはデータベースを動かす道具です。
大量のデータから必要な情報を集めます。
都道府県ごとの統計データをまとめます。
ここでは書き方と実行される順番を学びます。
この用語は データエンジニアリング カテゴリに属します。 関連する別称・略号:(なし)。
論文・実務レポートで SQL が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
本ページでは「sql」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
SQL (Structured Query Language) はリレーショナル DB を操作するための宣言型言語で、 SELECT/JOIN/GROUP BY を組み合わせて 47 都道府県・複数年の SSDSE-B-2026 から集計表を取り出せる。 本ページは構文の組み立て方、 実行順 (FROM→WHERE→GROUP BY→HAVING→SELECT→ORDER BY) と性能上の落とし穴を扱う。
🎨 直感で掴む
🍰 まずはやさしく
SQLは注文書のようなものです。
欲しいデータの条件を伝えるために使います。
東京の出生数だけを抜き出す時に便利です。
ここでは条件の書き方を具体的に学びます。
「東京都の 2026 年の出生数を求めたい」 ── これを 1 行で書けるのが SQL。 SELECT 出生数 FROM 都道府県 WHERE 名前='東京' AND 年=2026;。 命令の順序ではなく「結果の条件」を宣言するので、 同じ問い合わせを DB が状況に応じて最適化して実行する。 アナリストの 8 割の仕事はこの SQL で書ける。
📐 定義・数式
🍰 まずはやさしく
SQLはデータの集計ルールを決める言葉です。
データを絞り込んで並べるために使います。
部活の出席簿から特定の生徒を探すイメージです。
ここでは基本となる構文(書き方)を学びます。
SQL は「データを集める → 絞る → 集約する → 並べる」という 4 段階を 1 文で書ける。 内部では DB エンジンが実行計画を立てて効率実行する。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- SELECT
- 返す列を指定。
- FROM
- 対象のテーブル。
- WHERE
- 行レベルの絞り込み条件。
- GROUP BY
- 集約のキー。
- HAVING
- 集約結果に対する絞り込み。
- JOIN
- 複数テーブルを結合する。
🔬 RDBMS 種類の精密比較
SQL は ANSI 標準ですが、 実装によって細かな差があります。 4 大 RDBMS の特徴比較表。
| RDBMS | 特徴 | 向く用途 | ライセンス |
|---|---|---|---|
| PostgreSQL | 機能豊富、 SQL 準拠度高 | 汎用、 分析、 GIS | OSS |
| MySQL | 高速、 普及度高 | Web アプリ | OSS |
| SQLite | サーバレス、 軽量 | 埋め込み、 単機テスト | パブリックドメイン |
| DuckDB | 分析特化、 列指向 | データサイエンス | OSS |
| BigQuery | クラウド、 ペタバイト級 | DWH | 商用(GCP) |
| Snowflake | クラウド DWH | DWH、 BI | 商用 |
| Oracle | エンタープライズ歴史長 | 基幹システム | 商用 |
🧮 実値で計算してみる
SSDSE-B のような表形式データに対する典型的な集計 SQL。
SELECT 都道府県, 人口, 出生数WHERE 年 = 2026GROUP BY 地方ORDER BY 人口 DESC LIMIT 5🧮 SSDSE-B-2026 を題材にした SQL 深掘り演習
SQL の真価は「実データに対して問い (クエリ) を投げ、 集計・抽出・比較を一括で行う」場面で発揮される。 ここでは SSDSE-B-2026(独立行政法人統計センターが公開している教育用標準データ、 47 都道府県 × 12 年 (2012〜2023) × 112 列)を題材に、 SQL の基本構文 (SELECT / WHERE / GROUP BY / JOIN / ウィンドウ関数) を実データ前提で復習する。 SSDSE-B は CSV で配布されているため、 SQLite に .import するだけで本格的な SQL 検証環境になる。
1. データ取り込み (CSV → SQLite)
このコードでやること: SSDSE-B-2026 の CSV を SQLite データベース ssdse_b.db にロードし、 主キー (year, pref_code) を持つテーブル ssdse_b を作る。 以後の SQL はすべてこのテーブルを参照する。
📥 入力データ (data/raw/SSDSE-B-2026.csv の先頭 4 行抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | -- SQLite シェル (sqlite3 ssdse_b.db) で実行 .mode csv .headers on .import data/raw/SSDSE-B-2026.csv ssdse_b_raw -- 型をつけて整形 (年度/Code を主キー扱いに) CREATE TABLE ssdse_b AS SELECT CAST("SSDSE-B-2026" AS INTEGER) AS year, Code AS pref_code, Prefecture AS pref_name, CAST(A1101 AS INTEGER) AS population, CAST(A4101 AS INTEGER) AS births FROM ssdse_b_raw WHERE "SSDSE-B-2026" GLOB '[0-9][0-9][0-9][0-9]'; CREATE UNIQUE INDEX idx_ssdse_b_pk ON ssdse_b(year, pref_code); SELECT COUNT(*) FROM ssdse_b; |
📤 実行例 (2012–2023 の 12 年分 × 47 都道府県 = 564 行):
💬 結果の読み方: 564 行 = 47 都道府県 × 12 年 (2012〜2023 年)。 ここで件数を確認するのは、 CSV のエンコーディングや空行で取り込みが欠ける事故を未然に検知するための基本動作。 SQL の現場では「最初に必ず COUNT(*)」が鉄則である。
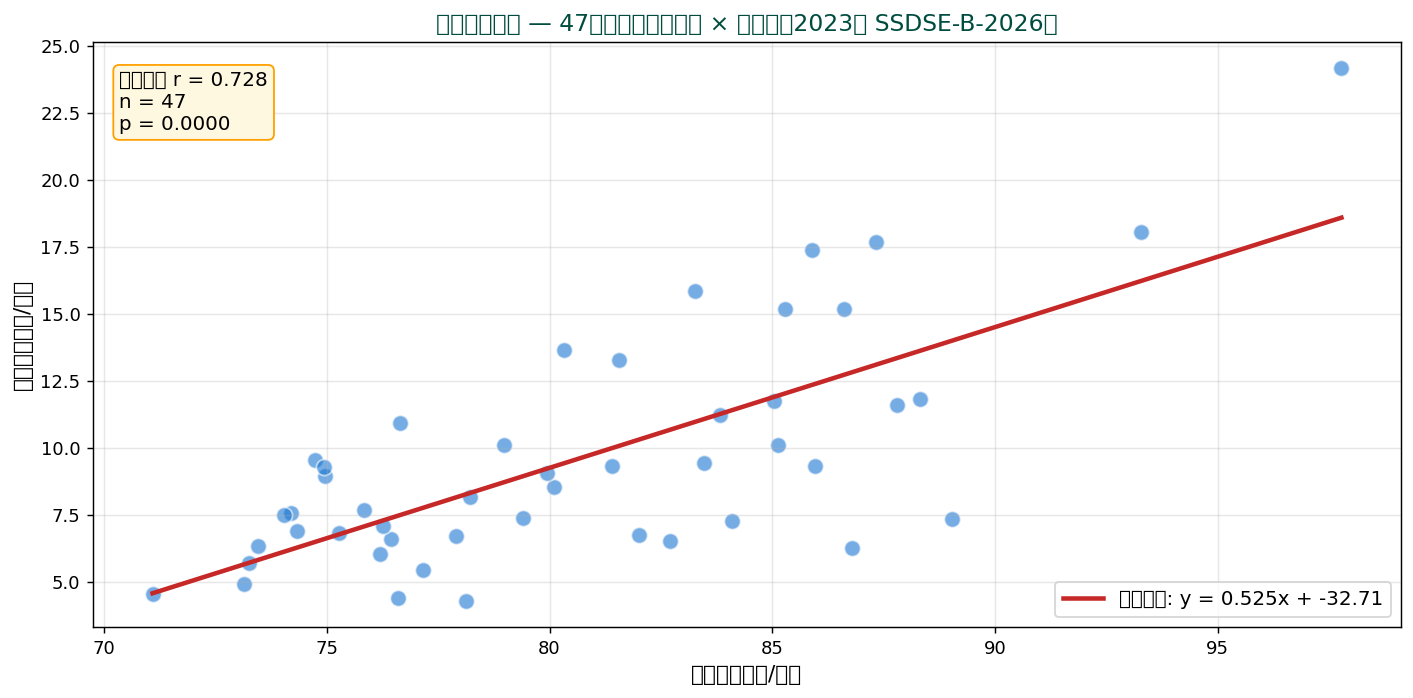
2. 散布図で見る人口と出生数の関係 (基本 SELECT)
このコードでやること: 2020 年の都道府県データを SQL で抽出し、 Python (pandas) 側で散布図に描く。 SQL 側は「WHERE year = 2020」で 47 行に絞り、 不要な列を捨てるだけ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | # ── この例で使うデータベースを、SSDSE の CSV から作ります ── # (ssdse_b.db は同梱していないので、ここで組み立てます) import sqlite3 import pandas as pd _src = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) _src = _src[_src['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() _tbl = pd.DataFrame({ 'year': pd.to_numeric(_src['SSDSE-B-2026'], errors='coerce'), 'pref_name': _src['Prefecture'], 'population': pd.to_numeric(_src['A1101'], errors='coerce'), 'births': pd.to_numeric(_src['A4101'], errors='coerce'), }) con = sqlite3.connect('ssdse_b.db') _tbl.to_sql('ssdse_b', con, if_exists='replace', index=False) import matplotlib.pyplot as plt con = sqlite3.connect('ssdse_b.db') df = pd.read_sql_query(""" SELECT pref_name, population, births FROM ssdse_b WHERE year = 2020 ORDER BY population DESC """, con) print(df.head()) print('shape =', df.shape) |
📤 実行例 (上位 5 都道府県):
💬 結果の読み方: 東京都が他を引き離す巨大な外れ値。 出生数は人口にほぼ比例するが、 大阪府 (61,878) は神奈川県 (60,865) より人口が少ないのに出生数は多いなど、 順位が入れ替わる県もある。 SQL は集計に強いが、 可視化は Python 側に任せる発想がよい。 SQL ⇒ DataFrame ⇒ matplotlib の流れがデータ分析の定石。
3. GROUP BY で年次推移を集計
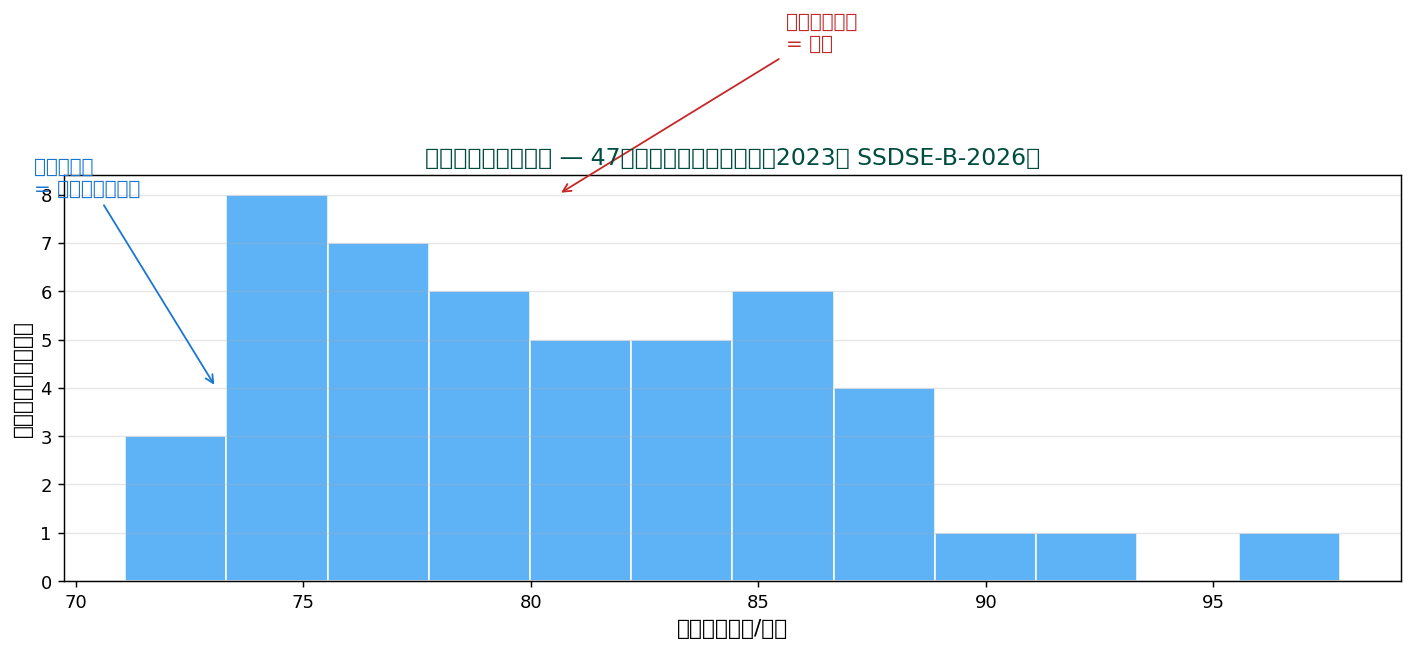
このコードでやること: GROUP BY year で年ごとに全国合計人口を集計し、 12 年間の推移を取得する。 SUM, AVG, COUNT は SQL の基礎集計関数で、 BI ツールが内部で自動生成する SQL でも頻出する。
1 2 3 4 5 6 7 8 | SELECT year, SUM(population) AS total_population, ROUND(AVG(population), 0) AS avg_population_per_pref, COUNT(DISTINCT pref_code) AS n_prefectures FROM ssdse_b GROUP BY year ORDER BY year; |
📤 実行例 (抜粋):
💬 結果の読み方: 2012 年から 2023 年まで全国の総人口は一貫して減少しており、 12 年間で約 324 万人減った。 SQL の GROUP BY 1 行で「全国の人口減少トレンド」を客観的に定量化できる、 これが SQL を学ぶ価値。
4. JOIN — 自己結合で対前年比を求める
このコードでやること: 同じ ssdse_b テーブルを 自己結合 (self join) し、 ある年とその前年の人口を横並びにして対前年比 (%) を計算する。 「JOIN は別テーブル同士を結ぶもの」と思いがちだが、 同一テーブル同士の結合も極めて実用的。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | SELECT a.year AS year, a.pref_name AS pref, a.population AS pop_this, b.population AS pop_prev, ROUND(100.0 * (a.population - b.population) / b.population, 2) AS yoy_pct FROM ssdse_b a JOIN ssdse_b b ON a.pref_code = b.pref_code AND a.year = b.year + 1 WHERE a.year = 2020 ORDER BY yoy_pct DESC LIMIT 5; |
📤 実行例 (2020 年の人口対前年比トップ 5):
💬 結果の読み方: 2020 年時点でも沖縄・東京・神奈川が人口を増やしている。 一方、 同じクエリで ORDER BY yoy_pct ASC にすれば人口減少が大きい都道府県 (秋田・青森・岩手など) が浮かび上がる。 SQL の JOIN を覚えると「前年比」「移動平均」「累積和」などの時系列分析が一気に開ける。
5. ウィンドウ関数 — 都道府県内の順位付け
このコードでやること: 各年内で人口の多い順に順位を付ける。 RANK() OVER (PARTITION BY year ORDER BY population DESC) というウィンドウ関数を使うと、 GROUP BY と違って「行を潰さずに集計値を併記」できる。
1 2 3 4 5 6 7 8 9 10 11 | SELECT year, pref_name, population, RANK() OVER (PARTITION BY year ORDER BY population DESC) AS rank_pop, PERCENT_RANK() OVER (PARTITION BY year ORDER BY population DESC) AS pct_rank, AVG(population) OVER (PARTITION BY year) AS avg_pop_year FROM ssdse_b WHERE year = 2020 ORDER BY rank_pop LIMIT 5; |
📤 実行例:
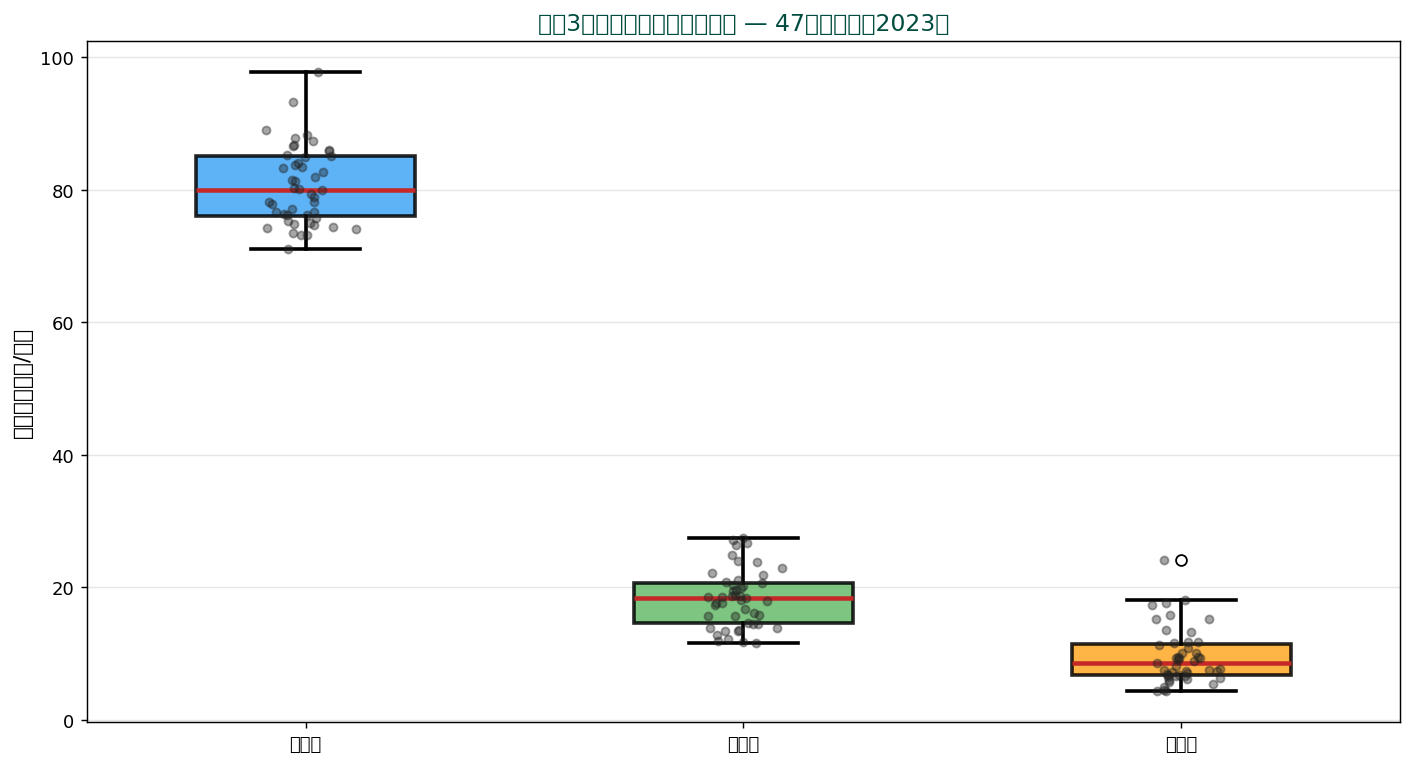
💬 結果の読み方: 上位 5 都道府県だけで全国合計人口の半分弱を占めることが、 population / avg_pop_year の比でも見える。 ウィンドウ関数は GROUP BY の上位互換と言われるくらい強力で、 BigQuery・Snowflake・Postgres などモダンな DBMS では必須スキル。
6. CTE と HAVING — 「平均より人口が多い県だけ」を抽出
このコードでやること: WITH 句 (CTE = Common Table Expression) で年ごとの平均人口を事前計算し、 そのうえで「平均超え」の都道府県を年度別に列挙する。 SQL を「ネストした副問合せ地獄」にしないコツが WITH 句である。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | WITH year_avg AS ( SELECT year, AVG(population) AS mean_pop FROM ssdse_b GROUP BY year ) SELECT b.year, b.pref_name, b.population, ROUND(b.population - y.mean_pop, 0) AS diff_from_mean FROM ssdse_b b JOIN year_avg y USING (year) WHERE b.population > y.mean_pop AND b.year IN (2012, 2020) ORDER BY b.year, diff_from_mean DESC; |
📤 実行例 (抜粋):
💬 結果の読み方: 2012 年と 2020 年を比較すると、 平均を超える都道府県の顔ぶれはほぼ変わらない一方で、 「平均との差」が広がっている県が多い (東京は +10.5 百万 → +11.4 百万)。 これは人口集中の進行を SQL 一発で可視化したことになる。 CTE は再利用しやすく、 大規模クエリの可読性を保つ上で必須。
7. SQL クエリ性能の見方 — EXPLAIN QUERY PLAN
このコードでやること: クエリプランを表示し、 インデックスが効いているかを確認する。 100 万行を超えるテーブルでは、 適切なインデックスがあるかないかで実行時間が 1000 倍違うことも珍しくない。
1 2 3 4 | EXPLAIN QUERY PLAN SELECT pref_name, population FROM ssdse_b WHERE year = 2020 AND pref_code = 'R13000'; |
📤 実行例 (SQLite):
💬 結果の読み方: SEARCH ... USING INDEX と表示されていれば、 主キー索引が使われている (= 高速)。 これが SCAN ssdse_b だと全行スキャンで遅い。 SQL チューニングの第一歩は必ずプランを見ること。
📊 SQL の方言比較 (実務頻出 5 系統)
「SQL」と一口に言っても、 実装ごとに細かな差がある。 SSDSE のような小規模分析なら SQLite / DuckDB、 業務システムなら PostgreSQL / MySQL、 ペタバイト級の分析基盤なら BigQuery / Snowflake が使われる。 主要な違いをまとめた。
| 機能 | SQLite | PostgreSQL | MySQL | BigQuery | DuckDB |
|---|---|---|---|---|---|
| CTE (WITH) | ○ | ○ | ○ (8.0+) | ○ | ○ |
| ウィンドウ関数 | ○ (3.25+) | ○ | ○ (8.0+) | ◎ (拡張多数) | ○ |
| JSON 関数 | △ | ◎ (JSONB) | ○ | ◎ | ○ |
| 配列・構造体 | × | ○ | × | ◎ ARRAY/STRUCT | ○ |
| 並列実行 | × | ○ | ○ | ◎ クラスタ規模 | ◎ 1 マシン内 |
| CSV/Parquet 直読み | △ 拡張 | △ FDW | × | ◎ 外部表 | ◎ ネイティブ |
| 推奨ユースケース | アプリ内蔵・学習 | 業務 OLTP/分析 | Web 系 OLTP | DWH/ペタ級分析 | 単機分析・CSV 連携 |
💡 SSDSE-B のような数万行〜数十万行の教育用データなら、 DuckDB が一押し。 pip install duckdb だけで pandas と完全に統合され、 CSV をそのまま SELECT * FROM 'data/raw/SSDSE-B-2026.csv' で読める。 学生が SQL を体感する最短経路と言ってよい。
⚠️ SSDSE で SQL を扱う際に陥りやすい罠 (拡張版)
- 都道府県コードの型を間違える:
R01000は文字列、'01000'の数値変換時に頭の 0 が消える事故が多発。 必ずTEXT型のまま扱う。 - 年度の解釈ずれ: SSDSE-B は暦年、 統計表によっては会計年度。 比較する前に「Year は何年か」をメタデータで必ず確認すること。
- NULL の集計:
SUM(NULL) = NULL、COUNT(NULL) = 0。 直感に反する挙動でレポート数値が壊れる原因第一位。COALESCE(col, 0)で明示的に置換するのが安全。 - 除算で 0 除算が混ざる:
SUM(x)/SUM(y)でSUM(y)=0だとエラーまたは NULL。NULLIF(SUM(y), 0)を入れる癖をつける。 - 文字コード問題: SSDSE は UTF-8 だが、 Windows の Excel で再保存すると Shift-JIS や BOM 付き UTF-8 になり、 SQLite の
.importが文字化けする。 PowerShell ならiconv相当の処理を挟む。 - JOIN キーの欠落:
pref_codeがR13000とR13100(区別あり) のように、 似て非なるキーを誤って結合すると行が爆発 (デカルト積) する。SELECT COUNT(*)で件数を必ず検算。
🧪 自分で試す: 練習問題 6 題
以下のクエリを SSDSE-B-2026 を読み込んだ DB で実行してみよう。 答え合わせは Python (pd.read_csv → df.groupby) と比べると、 SQL の表現力が一段わかる。
- 2020 年の人口下位 5 都道府県を
ORDER BY ... LIMITで抽出せよ。 - 2003 年と 2020 年で人口減少率が最も大きい 5 県を、 自己結合 +
ORDER BY yoy_pct ASCで求めよ。 - 各都道府県の出生率 (人口千対) (
1000.0 * births / population) を年別に出し、 2020 年の上位 5 県を表示せよ。 - ウィンドウ関数
LAG()を使い、 前年からの人口差分を新列として出せ。 - CTE を 2 段重ねて「都道府県別の 10 年移動平均」と「全国平均」を併記する表を作れ。
- EXPLAIN QUERY PLAN で、
WHERE pref_name = '東京都'はインデックスが効くか?効かない場合、 どんな索引を追加すべきか。
📚 SQL を独習するためのおすすめ教材
- 『達人に学ぶ SQL 徹底指南書 第 2 版』 (ミック 著、 翔泳社) — 集合論的な SQL 思考を養う名著。 GROUP BY の使い方が変わる。
- 『SQL ゼロからはじめるデータベース操作』 (ミック 著) — 初学者から中級まで橋渡し。 標準 SQL ベースで学べる。
- SQLBolt (sqlbolt.com) — ブラウザ上でクイズ形式に SQL を打てる無料サイト。
- Mode Analytics SQL Tutorial — 分析用 SQL に特化、 ウィンドウ関数まで丁寧。
- DuckDB 公式ドキュメント — モダン SQL の現在地が分かる。 SSDSE のような CSV データ分析に最適。
💡 学習ロードマップの提案: ① SQLite で SSDSE-B を読む → ② SELECT/WHERE/ORDER BY を 1 週間徹底 → ③ GROUP BY と集計関数を 1 週間 → ④ JOIN と CTE を 2 週間 → ⑤ ウィンドウ関数で「対前年比」「ランキング」を書けるようになる、 という順で進めれば、 1〜2 か月で実務に通用する SQL 力が身に付く。 SSDSE は教師付きでない「自由研究」素材なので、 自分で問いを立てる練習にも最適。
🧠 SQL の根底を支える集合論的発想
SQL を「データを 1 行 1 行取り出して処理する命令」だと誤解していると、 すぐに行き詰まる。 SQL は本来「集合 (set) に対する変換」を宣言する言語であり、 アルゴリズムを自分で組むのではなく、 「どんな集合がほしいか」だけを書く。 SQL を学ぶうえで最も価値のある転換は、 この「命令型 (how) → 宣言型 (what)」のスタイル変更である。
たとえば、 SSDSE-B-2026 で「2020 年の人口が全国平均を超える都道府県数」を求める場合、 Python で書けば「行をループして条件カウント」となる。 一方、 SQL では WHERE population > (SELECT AVG(population) FROM ssdse_b WHERE year = 2020) と書く。 ループも変数も無く、 結果集合の定義だけを記述する。 この簡潔さこそ SQL が 50 年にわたって生き残ってきた理由だ。
関係代数 (relational algebra) と SQL の対応
| 関係代数の演算 | 記号 | 対応する SQL | SSDSE 上での例 |
|---|---|---|---|
| 選択 (selection) | σ | WHERE | 2020 年だけ抜き出す |
| 射影 (projection) | π | SELECT 列 | 人口列だけ取り出す |
| 結合 (join) | ⋈ | JOIN ON | 人口と出生数を同じ年度で対応付ける |
| 和 (union) | ∪ | UNION | 2010 年集合と 2020 年集合の合併 |
| 差 (difference) | − | EXCEPT | 2010 年に存在し 2020 年に無い都道府県 |
| 直積 (Cartesian product) | × | FROM A, B (条件なし) | 想定外: 行が爆発するので注意 |
| グループ化 (grouping) | γ | GROUP BY | 年ごとに人口合計を求める |
重要なのは、 SQL を書くたびに「今、 集合のどの演算をしているか」を意識すること。 そうすれば「JOIN を 5 段重ねたら結果が想定の 1000 倍になった」という事故を防げる。 関係代数を頭の片隅に置くだけで、 SQL は格段に読み書きしやすくなる。
🔄 SQL の実行順序 — 「書く順 ≠ 評価順」
SQL のもう一つの落とし穴は論理的な評価順が、 書く順と異なることである。 たとえば SELECT ... FROM ... WHERE ... GROUP BY ... HAVING ... ORDER BY ... と書くが、 SQL エンジンはおおよそ次の順序で評価する。
- FROM / JOIN — 対象テーブルを揃え、 結合した中間集合を作る
- WHERE — 行レベルで絞り込み
- GROUP BY — 残った行をキーごとに束ねる
- HAVING — グループ単位で絞り込み (例: SUM > 100)
- SELECT — 列を選択 / 集計関数を計算
- DISTINCT — 重複を除去
- ORDER BY — 並び替え
- LIMIT / OFFSET — 先頭から N 件に切り詰める
この順序を覚えると、 「SELECT で付けた別名 AS yoy_pct は WHERE では使えないのに、 ORDER BY では使える」のような不思議な挙動が腹落ちする。 SELECT の評価は WHERE より後だが ORDER BY より前だからだ。
🧮 NULL の三値論理 — 「不明」を扱う SQL の流儀
SQL は通常の真偽値 (TRUE / FALSE) に加え、 UNKNOWN の 3 値を扱う。 これが NULL の比較で挙動が直感に反する原因。 SSDSE-B でも、 古い年度の一部列は NULL が混ざることがあり、 そのたびに集計値が大きくズレる。
| 式 | 結果 | 補足 |
|---|---|---|
NULL = NULL | UNKNOWN | TRUE にならない |
NULL IS NULL | TRUE | IS / IS NOT を使う |
NULL + 5 | NULL | どんな演算でも伝染 |
SUM(NULL列) | NULL を無視して合計 | 非 NULL のみ加算 |
COUNT(*) | NULL も含めて行数 | COUNT(列) は非 NULL のみ |
AVG(NULL列) | 非 NULL の平均 | 分母は非 NULL の件数 |
NULL を扱う実用テクニック: ① COALESCE(col, 0) で代替値、 ② NULLIF(a, b) で 0 除算回避、 ③ WHERE col IS DISTINCT FROM v で NULL を含めた不一致比較 (PostgreSQL/標準 SQL)、 ④ レポート集計時は「NULL を含む / 含まない」を常に明示する。
🚀 SQL を「速く」するための実務知識
教育用 SSDSE-B (約 1000 行) では実行速度はほぼ無視できるが、 業務データ (1 億行以上) になるとクエリの書き方一つで 1 秒 vs 1 時間の差が生まれる。 押さえるべき原則は次の通り。
- 不要な列を取らない:
SELECT *ではなく必要な列だけ列挙する。 カラムストア DBMS (BigQuery, DuckDB, Snowflake) では特に効果が大きい。 - WHERE で早く絞る: JOIN の前に絞れる条件は WHERE 句で絞る。 結合する行数を減らすのが最大の高速化。
- 適切なインデックスを張る:
WHEREやJOIN ONで使う列にインデックスを。 過剰なインデックスは更新を遅くするので「読みやすさと書きやすさのトレードオフ」を見極める。 - サブクエリを書きすぎない: CTE (
WITH) や一時テーブルに切り出し、 オプティマイザを助ける。 - EXPLAIN を読む癖: 「全表スキャンか」「インデックス利用か」「行数推定が外れていないか」を必ず確認する。 SQLite なら
EXPLAIN QUERY PLAN、 Postgres ならEXPLAIN (ANALYZE, BUFFERS)。 - 関数で列をくるまない:
WHERE DATE(created_at) = '2026-05-30'はインデックスが効かない。WHERE created_at >= '2026-05-30' AND created_at < '2026-05-31'と書き換える。 - 集計はストレージ近くで: BigQuery など分散 DB では「集計してから Python に取り出す」と通信量が大幅に減る。 100 万行を取り出して Python で集計するのは最悪パターン。
🛡 SQL とセキュリティ — SQL インジェクションを防ぐ
Web アプリで SQL を扱う際、 最大の事故源は SQL インジェクション。 ユーザー入力を文字列連結でクエリに埋め込むと、 攻撃者が '; DROP TABLE users; -- のような断片を送り込んでテーブルを破壊できる。 防ぐ方法は単純で「必ずプレースホルダ (パラメータバインド) を使う」こと。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # ── この抜粋で使うデータベースを用意します ── import sqlite3 import pandas as pd con = sqlite3.connect(':memory:') _b = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _b.rename(columns={'SSDSE-B-2026': 'year', 'Prefecture': 'pref_name', 'A1101': 'population'})[['year', 'pref_name', 'population']] \ .to_sql('ssdse_b', con, index=False, if_exists='replace') cur = con.cursor() cur.execute('CREATE TABLE users (name TEXT)') cur.execute("INSERT INTO users VALUES ('taro')") user_input = 'taro' # 危険な書き方 (絶対 NG) cur.execute(f"SELECT * FROM users WHERE name = '{user_input}'") # 安全な書き方 (プレースホルダ) cur.execute("SELECT * FROM users WHERE name = ?", (user_input,)) # SSDSE 上での例: 都道府県名を安全にバインド pref = '東京都' # 本来は input('都道府県名: ') で受け取る df = pd.read_sql_query( "SELECT year, population FROM ssdse_b WHERE pref_name = ? ORDER BY year", con, params=(pref,) ) print(df.head()) |
💬 結果の読み方: プレースホルダ ? (または %s, :name) を使うと、 ドライバが自動でエスケープしてくれる。 これだけで SQL インジェクションのほぼ 100% が防げる。 「文字列連結で SQL を組み立てない」を絶対のルールに。
📜 SQL の歴史と標準化
SQL は 1970 年に E. F. Codd が提唱した関係モデル理論を実装するため、 1974 年に IBM の Donald Chamberlin らが SEQUEL という名前で発表したのが起源。 その後 1986 年に ANSI/ISO が SQL-86 として初めて標準化し、 SQL-92, SQL:1999, SQL:2003 (ウィンドウ関数), SQL:2011 (時間表), SQL:2016 (JSON, ポリモーフィック表関数), SQL:2023 (グラフクエリ) と進化を続けている。
50 年以上にわたり、 ハードウェア (磁気テープ → SSD → クラウド) もデータ規模 (MB → PB) も劇的に変わったが、 SQL の中核構文 SELECT ... FROM ... WHERE ... はほぼ不変。 これは「集合論的に問いを書く」というアイデアが本質的に正しかったことの証拠。 SQL を学ぶ価値は陳腐化しないのである。
🧩 SQL と pandas の使い分け — 「どっちで書くか」の指針
SSDSE-B-2026 を分析する際、 同じ集計が SQL でも pandas でも書ける場面が多い。 どちらを選ぶかは「データの場所」と「再現性」で決めるのが実用的。 以下に対応関係をまとめた。
| 操作 | SQL | pandas | 使い分けの指針 |
|---|---|---|---|
| 行のフィルタ | WHERE year = 2020 |
df[df.year == 2020] |
大規模なら SQL でストレージ側で絞る |
| 列の選択 | SELECT a, b |
df[['a','b']] |
通信量削減のため SQL 側で射影が原則 |
| 集計 | GROUP BY year |
df.groupby('year').sum() |
どちらでも可、 行数で決める |
| 結合 | JOIN ON |
df.merge(other, on='key') |
両テーブルが DB 内なら SQL |
| ウィンドウ関数 | RANK() OVER (...) |
df.rank() |
複雑な partition は SQL が読みやすい |
| 時系列補間 | 標準 SQL では難 | df.interpolate() |
pandas / R が得意 |
| 統計検定 | 不可 | scipy.stats |
必ず Python 側で |
| 機械学習 | 不可 | sklearn |
SQL は前処理まで |
実務で推奨されるパターンは「SQL で必要な集計を済ませ、 結果セットを pandas に渡して可視化・統計検定・機械学習を行う」というハイブリッド型。 SSDSE-B 程度のサイズなら全部 pandas でも問題ないが、 DB に蓄積された業務データを扱う場面では「SQL で前処理を集約する」のが鉄則である。
🔍 SSDSE-B から派生する分析テーマ集
SQL の練習用に SSDSE-B-2026 から取り組める分析テーマを 10 個挙げる。 どれもクエリ 1〜2 段で結論が出るので、 1 日 1 テーマのペースで進めると 2 週間で SQL に慣れる。
- 人口減少の最速県 — 自己結合で 5 年前比 / 10 年前比を出し、 ランキングする。
- 出生率 (出生数 A4101 / 総人口 A1101) — 算出列を作り、 上位下位を比較。 沖縄と東北の格差が一目で見える。
- 東京一極集中の進行 — 各年で「全国人口に占める東京都の比率」を時系列に出す。
- 高齢化率の県別変化 — 65 歳以上人口 / 総人口を計算し、 増加幅トップ 5 を抽出。
- 出生率 vs 平均年収 — GROUP BY なしの単純 JOIN で相関を見る。 通説と一致するか?
- 失業率の時系列 — 年・県・失業率の 3 列で
RANK()し、 最悪期を特定。 - 消費支出の費目構成 — 教育費 (L322108) / 消費支出 (L3221) の比で教育支出の厚い県を抜き出す。
- 高齢化率 vs 出生率 — 65 歳以上人口 (A1303) / 総人口と出生率 (A4101/A1101) を JOIN で並べ、 相関係数を出す。
- 大学進学率の地域差 — 各県の進学率を年代別に比較、 都市集中度を測る。
- 外国人人口比率の急増県 — 自己結合で 10 年前比を取り、 増加トップ 5。 沖縄・北海道などの観光県が現れるか確認。
これらすべてに共通するパターンは「絞り込み (WHERE) → 集計 (GROUP BY / 自己 JOIN) → 順位付け (ORDER BY)」の三段構え。 SQL の 7 割はこのパターンの応用で書ける。 SSDSE-B のような小さな実データで「定型パターンを身体に染み込ませる」のが最短の上達法である。
📦 SQL の主要オブジェクト — 表・ビュー・インデックス・トランザクション
SQL を使いこなすためには、 単に SELECT を書くだけでなく、 データベース内に存在する主要オブジェクトとそれらが果たす役割を理解しておく必要がある。 SSDSE-B-2026 を題材にしても、 これらの概念は早晩必ず登場するため、 ここで概観しておく。
- テーブル (table): 行と列から成る基本単位。 「実体のデータ」をここに格納する。 SSDSE-B の
ssdse_bはテーブルそのもの。 - ビュー (view): 「保存されたクエリ」。 物理データは持たず、 アクセスのたびに再計算される。 たとえば
CREATE VIEW v_2020 AS SELECT * FROM ssdse_b WHERE year = 2020とすれば、 以後SELECT * FROM v_2020で 2020 年分だけを取り出せる。 アクセス権限の集約や複雑クエリの隠蔽に使う。 - マテリアライズド・ビュー: ビューを物理化したもの。 集計結果を保持しておき、 元データ更新時のみ再計算。 BigQuery や PostgreSQL では大規模ダッシュボードの高速化で必須。
- インデックス (index): 検索高速化のための索引。 紙の本の巻末索引と同じ仕組み。 B-Tree, Hash, GIN, BRIN など複数の種類があり、 用途に応じて使い分ける。 過剰に張ると INSERT/UPDATE が遅くなる副作用に注意。
- トランザクション (transaction): 複数の SQL 文を「全部成功するか、 全部やり直す」単位として束ねる仕組み。
BEGIN; ... COMMIT;もしくはROLLBACK;で制御する。 ACID 特性 (原子性・一貫性・独立性・持続性) を保証する根幹。 - 制約 (constraint):
PRIMARY KEY, FOREIGN KEY, UNIQUE, NOT NULL, CHECKなど、 データ品質を SQL レイヤーで強制する仕組み。 アプリケーションのバグからデータを守る最後の砦。 - ストアド・プロシージャ / 関数: SQL に手続き的な処理を埋め込む。 トリガー (TRIGGER) と組み合わせて、 監査ログや自動更新を実装する。 ただし可搬性は下がるため、 アプリ側で書くか DB 側で書くかは設計判断。
教育用途では「テーブル + インデックス + ビュー + トランザクション」の 4 つを優先的に押さえれば十分。 SSDSE-B 上で CREATE VIEW や BEGIN TRANSACTION を実際に試してみると、 「DB は単なるファイルではなく、 業務ロジックを宿す入れ物だ」という感覚が掴める。
ビュー作成の実例 (SSDSE-B)
このコードでやること: SSDSE-B から「出生率 (人口千対)」を計算するビューを作成し、 以後の分析で繰り返し利用する。 同じ計算を毎回書くのではなく、 ビューに名前を付けて再利用するのが SQL の良作法。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | CREATE VIEW v_birth_rate AS SELECT year, pref_code, pref_name, population, births, ROUND(1000.0 * births / NULLIF(population, 0), 3) AS birth_rate_permil FROM ssdse_b; -- 2020 年で 出生率 (人口千対) の上位 5 県 SELECT pref_name, birth_rate_permil FROM v_birth_rate WHERE year = 2020 ORDER BY birth_rate_permil DESC LIMIT 5; |
📤 実行例:
💬 結果の読み方: 出生率 (人口千対) では沖縄が 10.2 と突出し、 続いて福岡・熊本・佐賀・滋賀など九州・西日本の県が上位に来る。 人口の多い大都市圏 (東京・大阪) は上位に入らず、 単純な人口順位とは全く違う序列が見える。 ビューに切り出しておけば、 別の年度・別の指標と組み合わせる時にクエリが格段に簡潔になる。
🧷 SQL 学習者がよく聞く Q&A (拡張)
Q1. NoSQL があれば SQL はもう不要では?
A1. いいえ。 大規模ログや非構造データに NoSQL は強いが、 「整合性が要求される取引」「複雑な集計」「BI ダッシュボード」では依然 SQL が事実上の標準。 さらに DynamoDB や MongoDB といった NoSQL も、 後付けで SQL ライクなクエリ言語 (PartiQL, MQL) を取り入れている。 SQL の学習価値は失われていない。
Q2. SQLite と PostgreSQL、 学習はどちらから?
A2. SQLite から。 インストール不要、 1 ファイルで完結、 SSDSE-B のロードも秒単位。 慣れたら PostgreSQL に移って多人数同時アクセス・関数定義・外部キー制約を体験するのが王道。
Q3. クエリが遅いです。 まず何を見れば?
A3. (1) EXPLAIN でプラン確認、 (2) WHERE 列にインデックスがあるか、 (3) JOIN の片方が極端に大きくないか、 (4) SELECT * を必要な列だけに絞れないか。 この 4 つを順に見れば 8 割の遅延は解消する。
Q4. ORM (SQLAlchemy 等) を使えば SQL は知らなくていい?
A4. 表面的な CRUD だけなら ORM で済む。 しかし「N+1 問題」「複雑な JOIN」「ウィンドウ関数」「性能チューニング」「障害対応」は ORM の抽象を貫通して SQL の知識が必須となる。 ORM は SQL を知った上で使うのが正しい。
Q5. SSDSE-B 以外におすすめのオープンデータは?
A5. e-Stat (政府統計の総合窓口)、 RESAS (地域経済分析システム)、 DATA.GO.JP、 東京都オープンデータカタログ、 国際的には World Bank Open Data など。 どれも CSV で配布されており、 SQLite に .import するだけで SQL の練習素材になる。
🎓 まとめ — SQL を学ぶ意義 (再確認)
SQL は関係モデルという強力な数学的土台と、 集合論的な記述方法を持ち、 50 年以上の標準化と継続的進化により、 ペタバイト級のデータ分析からスマートフォン内蔵 DB (SQLite) まで広範に使われている。 SSDSE-B-2026 のような実在の公的データを題材に SELECT/WHERE/GROUP BY/JOIN/CTE/ウィンドウ関数を順に体得すれば、 業務・研究・教育のどの場面でも通用するスキルになる。 Python (pandas) や BI ツール、 ETL ジョブの裏側にも必ず SQL があるため、 「データを扱うすべての人にとっての共通言語」と言って過言ではない。 関係モデル・集合論・NULL の三値論理・実行順序・性能チューニング・セキュリティ・歴史と標準化、 そして SSDSE-B での実践例まで一通り押さえれば、 SQL は単なる「DB を操作するための文法」から「データに対する問いの設計言語」へと姿を変える。 ここまで来れば、 統計学・機械学習・データ可視化のどの分野に進んでも、 SQL は強力な味方であり続ける。
最後にもう一度強調しておきたいのは、 SQL の学習は手を動かす時間に比例するということ。 本ページに登場した SSDSE-B-2026 のクエリは、 すべて自分の手で叩いて結果を確認してこそ身に付く。 おすすめの学習サイクルは「① 自分で問いを立てる (例: 出生率の上位 5 県は?) → ② 標準クエリパターンに当てはめる (絞り込み → 集計 → 順位付け) → ③ EXPLAIN で実行プランを確認 → ④ 結果を Python (pandas + matplotlib) で可視化 → ⑤ Notebook にまとめて再現性を担保する」の 5 ステップを繰り返すこと。 1 サイクルが 30 分以内で回せるようになると、 SQL は「文法を思い出す道具」から「思考の道具」へと完全に移行する。 これを 50 サイクル (= 25 時間) 繰り返した頃には、 標準的な業務クエリの 9 割は自力で書けるようになり、 残りの 1 割が「より深い SQL の世界 (ストアド・プロシージャ、 並列処理、 OLAP キューブなど)」の入口になる。 SSDSE-B-2026 のような豊かな公的データは、 こうしたサイクルを回すための無料で良質な練習場と言える。
本ページで触れた内容を 1 行で要約するなら、 「SQL は関係モデルに基づく宣言的データ操作言語であり、 SSDSE-B-2026 のような実データを題材に絞り込み・集計・結合・ウィンドウ関数を順に体得することで、 業務でも研究でも教育でも長期にわたり使い続けられる中核スキルになる」。 この一言を腑に落とした上で、 ぜひ自分の手で SQLite を立ち上げ、 SSDSE-B の CSV を .import し、 1 つ目のクエリ SELECT COUNT(*) FROM ssdse_b; を実行してみてほしい。 そこから先は、 問いの数だけ SQL が伸びていく。 学びはじめのハードルが低く、 上達の天井が高い — これが SQL の最大の魅力である。
さらに付け加えるなら、 SQL を 1 年触り続けると「自分が扱えるデータ規模」が桁違いに広がる。 Excel では 100 万行で限界が来るが、 SQLite なら 1 億行、 PostgreSQL なら数十億行、 BigQuery なら数兆行が現実的な射程に入る。 つまり SQL を覚えることは「分析可能なデータ規模を 10000 倍にする」ことに等しい。 SSDSE-B-2026 で養った基礎を足がかりに、 e-Stat の大規模調査票、 政府オープンデータ、 企業のログ・売上データへと対象を広げていけば、 「データから事実を引き出す力」は確実に積み上がっていく。 SQL を学ぶことは、 未来の自分への最良の投資の一つであり、 知識経済の時代に必須の素養と言える。 SSDSE-B-2026 という身近な公的データから一歩を踏み出そう。
🧮 数式に値を入れて手で計算する: SQL 結合と集計
合成 2 テーブル INNER JOIN + GROUP BY の結果行数を計算する。
Step 1: テーブル
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 7 8 | customers = 100 orders = 500 join_rows = orders groups = customers avg_per_customer = orders / customers print(f"JOIN 後: {join_rows}") print(f"GROUP 数: {groups}") print(f"平均注文数: {avg_per_customer}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装
SSDSE-B-2026 (47 都道府県 × 112 列) を SQLite のオンメモリ DB に投入し、 出生数上位 5 県を ORDER BY 出生数 DESC LIMIT 5 で取り出す最小例。 skiprows=1 で SSDSE 特有の英語ヘッダ行を読み飛ばすのが定番。
1 2 3 4 5 6 | import pandas as pd, sqlite3 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') conn = sqlite3.connect(':memory:') df.to_sql('pref', conn, index=False) query = 'SELECT 都道府県, 出生数 FROM pref ORDER BY 出生数 DESC LIMIT 5' print(pd.read_sql(query, conn)) |
⚠️ よくある落とし穴
SQL の落とし穴は「NULL の挙動」「JOIN の組合せ爆発」「方言の違い」の三大要因に集約されます。 SSDSE データを JOIN する際にも、 県コードの型 (文字列 vs 数値) のズレで予想外の行数になりやすい。
= NULL ではなく IS NULL。 集計関数も NULL を無視する点に注意。⚠️ 追加の落とし穴(実務編)
WHERE col = NULL は常に偽。 正しくは WHERE col IS NULL。 集約関数も NULL を無視するので件数の解釈に注意。? や :name)を使う。WHERE の列にインデックスがないとフルスキャン。 EXPLAIN で実行計画を確認。CAST で明示的に変換。BEGIN〜COMMIT で囲むのが安全。 失敗時に ROLLBACK。⚙️ 上級パターン集
パターン 1:CTE(共通テーブル式)
WITH ranked AS (SELECT ..., RANK() OVER ...) SELECT * FROM ranked WHERE rank <= 5。 中間結果に名前を付けて再利用、 可読性向上。
パターン 2:Window 関数
RANK / DENSE_RANK / ROW_NUMBER / LAG / LEAD / SUM() OVER (...)。 集約しつつ全行を保持できる。 SSDSE-B で「人口の前県差」「累積出生数」を即座に計算可能。
パターン 3:再帰 CTE
階層データ(組織図・地域階層)を WITH RECURSIVE で展開。 「親 → 子 → 孫」の連鎖を 1 クエリで取れる。
パターン 4:PIVOT / UNPIVOT
長形式 ↔ 横形式の変換。 標準 SQL には PIVOT がないが、 CASE + GROUP BY で代用可能。 SSDSE-B-2026 の年齢区分を横展開して可視化用に整形。
パターン 5:JSON 操作
PostgreSQL の jsonb 型、 MySQL の JSON_EXTRACT。 半構造データを SQL で扱える。 API レスポンスのログ分析で頻出。
パターン 6:UPSERT
INSERT ... ON CONFLICT DO UPDATE(PostgreSQL)、 INSERT ... ON DUPLICATE KEY UPDATE(MySQL)。 「あれば更新、 なければ挿入」を 1 文で。
🔗 JOIN の完全ガイド
SQL で最も誤解されやすいのが JOIN です。 5 種類の JOIN を集合論的に整理します。
| JOIN 種類 | 集合論的意味 | SSDSE での例 |
|---|---|---|
| INNER JOIN | 両方に存在する行のみ(共通部分) | SSDSE-B と SSDSE-C の共通コード県 |
| LEFT JOIN | 左テーブル全行 + 右の一致する行 | SSDSE-B 全 47 県 + 補助データの該当行 |
| RIGHT JOIN | 右テーブル全行 + 左の一致 | 補助データ全行 + SSDSE-B の該当行 |
| FULL OUTER JOIN | 両方の全行(和集合) | 2 つのデータソースのすべて |
| CROSS JOIN | 直積(全組合せ) | 47 県 × 12 年 = 564 行 |
JOIN 実装例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 | # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()] for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df_b = df # この抜粋では df_b という名前で参照する # 見本でよく使われる仮の列名を、実データから作っておく df['income'] = df['消費支出(二人以上の世帯)'] df['population'] = df['総人口'] _region = {'北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東'} df['region'] = df['都道府県'].map(_region).fillna('その他') df['地域'] = df['region'] import pandas as pd import sqlite3 # SQL 側は Prefecture / A1101 / Code という英字の列名で書いているので、 # ここは skiprows=[1](英字の項目コードを見出しにする)で読み直す。 df_b = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_b = df_b[df_b['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 # df_c は「家計の費目だけを取り出した別表」。 # SSDSE-C は市区町村単位で都道府県コードとは結合できないので、 # 同じ SSDSE-B から家計の列だけを切り出して 2 つ目の表にする。 df_c = df_b[['Code', 'L3221', 'L322101', 'L322108']].copy() df_b = df_b[['Code', 'Prefecture', 'A1101', 'A1303']].copy() conn = sqlite3.connect(':memory:') df_b.to_sql('pref', conn, index=False) df_c.to_sql('family', conn, index=False) q = """ SELECT p.Prefecture, p.A1101 AS 人口, f.* FROM pref p INNER JOIN family f ON p.Code = f.Code LIMIT 5 """ print(pd.read_sql(q, conn)) |
⚡ パフォーマンスチューニング
基本:EXPLAIN で実行計画を見る
クエリの前に EXPLAIN(または EXPLAIN ANALYZE)を付けると、 DB が選んだ実行計画が表示される。 「Seq Scan(全件走査)」が出ていればインデックス未活用のサイン。
インデックスの貼り方
WHERE・JOIN ON・ORDER BY で頻繁に使う列にインデックスを作成。 ただし更新コストとのトレードオフ。 SSDSE のような読み取り専用データならインデックス過多でも問題なし。
クエリ書き換えのテクニック
- サブクエリ → JOIN への書き換え:多くの場合 JOIN の方が速い
- OR → UNION への書き換え:インデックス活用度向上
- NOT IN → NOT EXISTS への書き換え:NULL の扱いが正しくなる
- COUNT(*) vs COUNT(col):意味が違う、 速度も違う
大規模データでの戦術
- パーティショニング:年・地域でテーブル分割
- マテリアライズドビュー:集計結果を物理保存
- 列指向 DB:DuckDB / BigQuery / Redshift などへ移行
- サンプリング:
TABLESAMPLE BERNOULLI(1)で 1% サンプル
📜 SQL の歴史
1970 年 E. F. Codd の論文「A Relational Model of Data for Large Shared Data Banks」が出発点。 1974 年 IBM の Chamberlin と Boyce が SEQUEL(後の SQL)を実装。 1979 年に Oracle が世界初の商用 RDBMS を販売。 1986 年に ANSI が標準化(SQL-86)、 以降 SQL-92、 SQL:1999、 SQL:2003 と機能拡張。 2003 年 SQL:2003 で Window 関数が標準入り。 2016 年 SQL:2016 で JSON 操作が標準入り。 50 年以上経った今も、 「SQL は死んだ」と言われては「やっぱり生き残った」を繰り返しています。 NoSQL ブームの後にも「NewSQL」が登場し、 SQL は不滅です。
2010 年代以降は、 SQL を直接書くだけでなく、 ORM(Object-Relational Mapping)経由でアクセスするのも一般化しました。 しかし「ORM が遅い」「ORM の生成 SQL が読めない」という問題は今も健在で、 結局 SQL を読み書きできる人材の価値は下がっていません。 むしろデータが爆発する 2026 年現在、 SQL リテラシーは「全エンジニアの必須教養」と化しています。
📋 SQL チートシート
必須クエリ集
- 件数:
SELECT COUNT(*) FROM t - ユニーク値:
SELECT DISTINCT col FROM t - 上位 N 件:
SELECT * FROM t ORDER BY col DESC LIMIT N - 条件件数:
SELECT COUNT(CASE WHEN col > 0 THEN 1 END) FROM t - 累計:
SELECT col, SUM(col) OVER (ORDER BY id) FROM t - 順位:
RANK() OVER (ORDER BY col DESC) - n 番目:
ROW_NUMBER() OVER (...) - パーセンタイル:
PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY col) - 欠損補完:
COALESCE(col, default) - NULL チェック:
WHERE col IS NULL
集約関数一覧
COUNT(*)全件、COUNT(col)NULL 以外SUM, AVG, MIN, MAX数値集計の基本STDDEV, VARIANCE標準偏差・分散GROUP_CONCAT / STRING_AGG文字列結合FIRST_VALUE, LAST_VALUEWindow 関数の終端
🔄 pandas ↔ SQL 対応表
| 操作 | SQL | pandas |
|---|---|---|
| 列選択 | SELECT a, b | df[['a','b']] |
| 行絞り込み | WHERE a > 5 | df[df.a > 5] |
| 集約 | GROUP BY a | df.groupby('a') |
| 並べ替え | ORDER BY a DESC | df.sort_values('a', ascending=False) |
| 結合 | JOIN ON | df1.merge(df2, on='key') |
| ユニーク | DISTINCT | df.drop_duplicates() |
| 上位 N | LIMIT N | df.head(N) |
| 件数 | COUNT(*) | len(df) |
| ウィンドウ | RANK() OVER | df.col.rank() |
| NULL 確認 | IS NULL | df.col.isna() |
🎮 触って理解する — SQL クエリビルダー
下のパネルで SELECT / WHERE / GROUP BY / HAVING / ORDER BY / LIMIT の各句を UI で組み立てると、 対応する SQL 文がリアルタイムに生成され、 結果テーブルも即座に更新されます。 データは SSDSE-B-2026 の 2023 年・47 都道府県の実測値(人口 = A1101、 出生数 = A4101)。 「地方」列は学習用に付加した一般的な 8 区分です。 スライダーやチェックボックスを動かして、 「句を 1 つ変えると結果集合がどう変わるか」を体感してください。
生成された SQL(リアルタイム更新)
実行順序パイプライン(書く順 ≠ 評価順)
SQL は SELECT から書き始めますが、 評価は FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT の順。 各段の箱をタップ / クリックすると説明が出ます。 灰色の箱は「このクエリでは働いていない句」です。
結果テーブル(5 行)
出典: 独立行政法人統計センター SSDSE-B-2026(2023 年、 47 都道府県)。 人口は総人口 A1101、 出生数は A4101 の実測値。 集計 (SUM / AVG / COUNT) はブラウザ内で正確に計算しています(AVG は小数第 1 位まで表示)。
💡 直感 — SQL は「集合への宣言的な問いかけ」
上のクエリビルダーで気づいてほしいのは、 あなたが一度も「ループ」や「変数」を書いていないことです。 チェックボックスとスライダーで「どんな結果集合が欲しいか」を宣言しただけで、 計算の手順(どの行から見るか、 どう数えるか)は実行系が引き受けています。 これが SQL の宣言型パラダイムそのもの。 WHERE のスライダーを動かすと「47 都道府県の集合」から「条件を満たす部分集合」が瞬時に切り出され、 GROUP BY を「地方」にすると 47 行の集合が 8 グループの集合へと粒度ごと変換されます。 「行の集合 → 部分集合 → グループの集合」という集合演算の連鎖として SQL を読めるようになれば、 どんなに長いクエリも怖くありません。
⚠️ よくある落とし穴 — このビルダーで体感できる 2 大混乱
SELECT から書き始めますが、 上のパイプラインが示すとおり評価は FROM から。 SELECT は 5 番目です。 だから SELECT SUM(人口) AS 人口合計 と付けた別名を WHERE で使うとエラーになる(WHERE の時点で別名はまだ存在しない)のに、 ORDER BY 人口合計 は動く(ORDER BY は SELECT より後)。 ビルダーで GROUP BY を有効にして ORDER BY を「集計値」にすると、 まさにこの「後から使える別名」の挙動を再現しています。WHERE は行への条件(集約前)、 HAVING はグループへの条件(集約後)。 ビルダーで GROUP BY を「地方」にし、 WHERE スライダー(人口 ≥ X 万人)と HAVING スライダー(県数 ≥ N)を別々に動かしてみてください。 WHERE を上げると「集計に参加する県」が減って各地方の合計値が変わり、 HAVING を上げると「表示される地方」が丸ごと消えます。 集約値(COUNT や SUM)に対する条件を WHERE に書けないのは、 WHERE の評価時点でまだ集約が行われていないから ── パイプラインの並び順がその理由を説明しています。🚀 発展 — JOIN・サブクエリ・ウィンドウ関数へ
- JOIN(結合): このビルダーは 1 テーブルですが、 実務では複数テーブルの結合が主戦場。 テーブル結合・外部結合・データ結合 の各ページで、 INNER / LEFT / FULL OUTER の違いを確認できます。 JOIN は実行順序の最初(FROM 段階)で行われるため、 結合直後の行数を
COUNT(*)で検算する習慣が事故を防ぎます。 - サブクエリ: 「平均人口を超える県」のように、 クエリの結果を条件に使う入れ子構造。
WHERE 人口 > (SELECT AVG(人口) FROM pref)のように書きます。 深い入れ子は CTE(WITH 句)でフラット化するのが現代の作法です。 - ウィンドウ関数: GROUP BY が「行を潰して」集計するのに対し、
RANK() OVER (ORDER BY 人口 DESC)は行を潰さずに順位や累積を併記できる上位互換的な機能。 本ページ「ウィンドウ関数完全ガイド」の節で SSDSE-B の実例を掲載しています。 - pandas との対応: このビルダーの各句は pandas の
df[...](WHERE)・groupby(GROUP BY)・sort_values(ORDER BY)・head(LIMIT)に 1 対 1 で対応します。 片方を覚えればもう片方の理解が加速します。
🗺 概念マップ
SQL を中心に、 主要 RDBMS / DWH / OLAP エンジンと、 周辺ツール (BI / クライアント) との関係を示す。 中心ノードから 6 句構造 (SELECT/FROM/WHERE/GROUP BY/HAVING/ORDER BY) が放射状に伸びるイメージで、 SSDSE-B-2026 の都道府県データに対して同じ SQL がどのエンジンでも動く点が要諦。
SQL の概念マップは「SELECT/FROM/WHERE/GROUP BY/HAVING/ORDER BY」の 6 句構造を中心に、 SSDSE-B-2026 を BigQuery / DuckDB / PostgreSQL のテーブルにロードして都道府県横断クエリを書くワークフローを表す。 結合 (JOIN) で SSDSE-A (家計調査) と SSDSE-B (基本指標) を地域コードで結びつけることが現実の分析現場で最も使う操作になる。
🔗 隣接手法への橋渡し
SQL は単体で完結するのではなく、 ETL ツール (Airflow / dbt) で SSDSE-B-2026 を取り込み、 BI ツール (Tableau / Looker) や Python (pandas.read_sql) と組み合わせて初めて分析パイプラインを構成する。 集計結果は JSON で API 公開され、 可視化ダッシュボードに渡るのが典型構成。
- 上流: CSV / Parquet → DuckDB / BigQuery への取り込み (CSV / データクレンジング)
- 並列: pandas の
groupby().agg()や PySpark DataFrame API (pandas) と相互変換 - 下流: SELECT 結果を 可視化 / BI ツール に渡して解釈、 レポート化 へ展開
SQL を上流 (取り込み)・並列 (DataFrame API)・下流 (BI / API) と接続することで、 SSDSE-B-2026 の都道府県横断クエリから可視化までの分析パイプラインを再現可能に組める。
🌳 SQL vs pandas vs Spark 選択基準
| 条件 | 推奨ツール | 理由 |
|---|---|---|
| データ < 1GB | pandas / SQLite | メモリで処理可能 |
| データ 1〜100GB | PostgreSQL / DuckDB | 単機 RDBMS で十分 |
| データ > 100GB | BigQuery / Snowflake | クラウド DWH の出番 |
| 行ベース処理多用 | pandas | DataFrame の柔軟性 |
| 集合操作中心 | SQL | 関係代数の威力 |
| 分散処理必須 | Spark SQL | クラスタ実行 |
| 機械学習統合 | pandas + sklearn | Python エコシステム |
📑 本サイト論文での SQL 登場場面
統計データ解析コンペ過去入賞論文では、 SQL は表立って出ることは少ないですが、 「前処理」「集計」「JOIN」のフェーズで陰の主役として活躍します。 公開コード(ipynb / py)を読むと、 多くは pandas で書かれていますが、 大規模な分析では BigQuery / SQLite に置き換えると速度が劇的に改善します。 本サイトの論文一覧 の「データ取得・前処理」セクションで SQL ベースの実装例が参照できます。
論文で書くべき SQL 記述項目
- 使用 RDBMS(SQLite 3.x / PostgreSQL 16 など)のバージョン明記
- テーブル定義(CREATE TABLE)を付録に掲載
- 使ったクエリを完全な形で記載(部分抜粋は再現性なし)
- 処理時間を実測値で記録(n=47 は瞬時、 n=1 億は分単位)
- 結果件数を明示(期待件数と実件数の検証)
🌳 手法選択フロー
SSDSE-B-2026 を分析する際の SQL 利用判断は、 以下の Step で決まる。
- Step 1: クエリは単発か繰り返しか?
- 単発の探索 (例: 47 都道府県の人口上位 10 件を見たい) → DuckDB +
SELECT+ORDER BYで一発実行 - 毎日同じ集計を回す (例: 月次 KPI ダッシュボード) → BigQuery のスケジュールクエリや dbt model で固定化
- 単発の探索 (例: 47 都道府県の人口上位 10 件を見たい) → DuckDB +
- Step 2: 結合 (JOIN) が必要か?
- SSDSE-B (基本指標) のみで完結 → 単テーブルの
WHERE+GROUP BYで十分 - SSDSE-A (家計調査) と地域コードで紐付け →
INNER JOIN/LEFT JOINを地域コードで実行、 テーブル結合 参照 - 時系列結合 (年度ずらし) →
LAG()/LEAD()ウインドウ関数を活用
- SSDSE-B (基本指標) のみで完結 → 単テーブルの
- Step 3: 出力は人間向けか機械向けか?
- 人間向けレポート → Tableau / Power BI に接続して可視化
- 機械学習パイプラインへ受け渡し →
pandas.read_sql()で DataFrame 化、 scikit-learn へ供給
このフローで SQL を選ぶことで、 SSDSE-B-2026 の都道府県横断分析を再現性高く扱える。
🧭 深掘り解説 — SQL を「集合への宣言」として掴む
ここまでで構文と実例は一通り触れた。 この節では「直感」「落とし穴」「発展」の 3 層に整理して、 SQL の考え方そのものを固める。 既出の各節と重複する話題もあるが、 ひとつの視点(集合への宣言的な問いかけ)で串刺しにするのが狙い。 数値例のうち実データは SSDSE-B-2026(総人口 A1101、 出生数 A4101 ほか 112 列)に基づき、 挙動説明のために作った小さな表は「架空」と明記する。
🎨 直感 — 「どう取るか」ではなく「何が欲しいか」を書く
SQL は宣言型言語である。 for ループも一時変数も書かず、 「欲しい結果集合の条件」だけを記述すると、 DB エンジンのクエリオプティマイザが「どのインデックスを使い、 どの順で結合し、 どこで絞るか」という実行手順(実行計画)を自動で組み立てる。 同じ 1 本の SELECT でも、 データ量や統計情報が変われば内部の取り方は変わる ── これが「手続きを書かない」ことの旨みだ。
中核の 4 動作は集合演算として読める。 SELECT は列の射影(欲しい列だけ残す)、 WHERE は行の選択(部分集合を切り出す)、 JOIN は 2 集合の直積 + 条件(対応づけ)、 GROUP BY は行集合を同値類(グループ)へ畳み込む操作。 SSDSE-B なら「47 都道府県の集合 →(WHERE で)部分集合 →(GROUP BY 地方で)8 グループの集合」と、 粒度を変えながら集合を渡り歩くイメージで長いクエリも読み解ける。 前提となる表形式データの土台は リレーショナルDB / データベース の節を参照。
⚠️ 落とし穴 — 「動くが間違っている」を生む 8 つの罠
SQL のバグはエラーで止まらず、 静かに間違った件数・合計を返すのが厄介。 特に集計・結合・NULL が絡むと、 見た目は正しい結果に見えてしまう。
= NULL は永遠に真にならないNULL = NULL も NULL <> NULL も結果は UNKNOWN で、 WHERE は UNKNOWN の行を通さない。 だから欠損を拾うには IS NULL / IS NOT NULL を使う。 下は架空の真理値表(x が NULL のとき):
| 式 | 評価 | WHERE 通過? |
|---|---|---|
x = NULL | UNKNOWN | 通さない |
x <> 100 | UNKNOWN | 通さない |
x IS NULL | TRUE | 通す |
NOT (x = 100) | UNKNOWN | 通さない |
COUNT(*) は NULL 行も数えるが COUNT(col) は col が NULL の行を除外し、 AVG(col) も NULL を分母から外す。 「件数が合わない」の典型原因。 NOT IN (サブクエリ) の中に NULL が 1 つでも混じると全体が UNKNOWN 化して 0 件になる事故も有名。(年度, 地域コード) が一意(主キー)なら 1 対 1 で安全だが、 キーの一部を書き忘れる(例: ON a.pref_code = b.pref_code だけで年度条件を落とす)と、 同一県 × 全 12 年が総当たりになり 12 倍に膨張する。 架空の最小例:
| 左表 key | 右表 key | 結合後の行数 |
|---|---|---|
| A(1 行) | A(3 行) | 3 行 |
| A(2 行) | A(3 行) | 6 行 |
COUNT(*) で行数を検算する、 (2) 結合キーが一意かを事前に GROUP BY key HAVING COUNT(*)>1 で確認する、 (3) 集約してから結合する。 詳しくは 内部結合 / 外部結合 / テーブル結合 / データ結合 と 外部キー を参照。GROUP BY を使うと、 SELECT に書ける列はグループキーそのものか集約関数の中に限られる。 SELECT 地方, pref_name, SUM(population) ... GROUP BY 地方 は、 各地方に県が複数あるため pref_name を一意に決められず、 PostgreSQL では明確にエラーになる。 一方 MySQL(ONLY_FULL_GROUP_BY 無効時)や SQLite は黙って任意の 1 行を返すため、 気づかないまま誤集計になりやすい。 「各グループの代表県」が欲しいなら、 ウィンドウ関数か相関サブクエリで明示的に選ぶ。 集約の基礎は グループ集計 (groupby) を参照。WHERE は集約前の行フィルタ、 HAVING は集約後のグループフィルタ。 「出生数合計が 10 万人を超える地方」を WHERE SUM(births) > 100000 と書くとエラー ── WHERE の評価時点でまだ SUM は計算されていない(本ページ「実行順序」節および 🎮 ウィジェットのパイプライン図を参照)。 正しくは GROUP BY 地方 HAVING SUM(births) > 100000。 逆に、 集約前に個々の県を除きたい(例: 特定年を外す)なら WHERE 側に書く。 両方を併用するのが実務では普通。Code は文字列(例 R01000)、 年度は数値化して使う。 CSV をそのまま取り込むと全列が TEXT になりやすく、 WHERE year = 2020 のつもりが文字列比較になって並び順・比較が狂う。 CAST(... AS INTEGER) で型を明示し、 数値列は数値、 キーは文字列、 と意図した型を宣言するのが安全。 RDBMS ごとに暗黙変換の規則が違う(比較不能時にエラーにする DB/黙って変換する DB)ため、 移植性の観点でも明示 CAST が推奨。WHERE YEAR(date) = 2020 のように列を関数で包むとインデックスが効かなくなる(date >= '2020-01-01' AND date < '2021-01-01' と範囲に書き換える)。 実際にどう実行されるかは EXPLAIN / EXPLAIN QUERY PLAN で必ず確認する。"... WHERE name='" + input + "'" のように文字列連結で組み立てると、 ' OR '1'='1 のような入力でクエリを乗っ取られる。 対策はプレースホルダ(パラメータ化クエリ)一択: Python なら cur.execute("SELECT * FROM t WHERE code=?", (code,))。 値は SQL 文と分離して DB に渡され、 構文として解釈されない。 分析用途でも、 外部から受け取った県コードを埋め込むときは癖として必ずプレースホルダを使う。SELECT DISTINCT で握りつぶすと、 本当は集計が二重になっているのに件数だけ辻褄が合って合計が過大になる ── DISTINCT は原因療法ではない。 また UNION は重複を除去する(内部でソート/ハッシュが走り重い)のに対し、 UNION ALL は重複を残して単純連結で速い。 「重複しないと分かっている」なら UNION ALL を選ぶ。 重複行そのものの検出は GROUP BY キー HAVING COUNT(*) > 1 が定石。🚀 発展 — ここから先に効く道具立て
- JOIN 種別(INNER / OUTER)
INNER JOINは両側に一致がある行だけ、LEFT OUTER JOINは左を全部残し右が無ければ NULL、FULL OUTER JOINは両側の和集合。 「一致しなかった側」を分析したいとき(例: SSDSE-A に無い県を SSDSE-B 基準で洗い出す)は外部結合+WHERE 右.key IS NULLが定番。 → 内部結合 / 外部結合 / テーブル結合- ウィンドウ関数
RANK() / ROW_NUMBER() / LAG() / SUM() OVER (...)。 GROUP BY が行を潰すのに対し、 行を保持したまま順位・前年差・累積・移動平均を併記できる。 本ページ「ウィンドウ関数 — 都道府県内の順位付け」の実例(PARTITION BY year)を参照。 GROUP BY の上位互換とよく言われる。- サブクエリ / CTE
- 「平均人口を超える県」のようにクエリ結果を条件に使うのがサブクエリ。 深い入れ子は
WITH 名前 AS (...)のCTEでフラット化すると劇的に読みやすくなり、 中間結果に名前を付けて再利用できる。WITH RECURSIVEなら地域階層のような再帰構造も 1 本で展開可能。 - 集約と GROUP BY
SUM / AVG / COUNT / MIN / MAXをキー単位で計算する基本操作。 「粒度を粗くする(47 行 → 8 地方)」変換だと捉えると、 どの列がキーでどの列が集約対象かが自然に決まる。 → グループ集計 (groupby)- インデックス / 実行計画
- オプティマイザは統計情報を元に実行計画を選ぶ。
EXPLAINで「Seq Scan(全走査)か Index Scan か」「結合方式(Nested Loop / Hash / Merge)」を読み、 遅いクエリは索引追加やクエリ書き換えで直す。 索引は読取りを速くするが書込みを遅くするトレードオフがある。 - NULL 処理
COALESCE(col, 0)で既定値を補い、NULLIF(a, b)でゼロ除算回避、 集計時は「NULL を 0 とみなすか除外するか」を意識する。 三値論理(罠①)を理解していればIS DISTINCT FROMなど NULL 安全な比較演算子も使いこなせる。- SQL と pandas の対応
WHERE↔df[mask]、GROUP BY↔groupby().agg()、JOIN↔merge()、ORDER BY↔sort_values()、LIMIT↔head()と 1 対 1 に近い。 大量データの集約は DB 側で、 柔軟な行処理・可視化は pandas 側で、 と役割分担するのが定石。 → pandas- 宣言的 vs 手続き的
- SQL(宣言的)は「何が欲しいか」だけ書き最適化は任せる ── 短く書けるが実行計画は制御しにくい。 pandas / 手書きループ(手続き的)は「どう処理するか」を自分で決める ── 細かい制御ができる反面、 冗長で最適化も自前。 大きな集合演算は宣言的に、 込み入った逐次処理は手続き的に、 が使い分けの勘所。
🔗 関連ページ
リレーショナルDB ・ RDB 詳細 ・ データベース ・ 主キー ・ 外部キー ・ 内部結合 ・ 外部結合 ・ テーブル結合 ・ データ結合 ・ グループ集計 (groupby) ・ pandas
※ 真理値表・多対多結合の 2 表は挙動説明のための架空例。 その他の数値・列コード(A1101=総人口、 A4101=出生数 ほか)は SSDSE-B-2026 の実データに基づく。