🔖 キーワード索引
「tidy data」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「tidy data」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「tidy data の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データの整理整頓のようなものです。
分析やグラフ作成を楽にするために使います。
部活の出席簿をきれいにまとめるイメージです。
ここではデータの整え方とコツを読みます。
Tidy data:Wickham 提案:1行1観測・1列1変数の整った形式
- 3 原則:(1) 1 観測 = 1 行、 (2) 1 変数 = 1 列、 (3) 1 観測単位 = 1 テーブル。
- Long 形式とも呼ばれる。 集計・可視化が画一的に書ける。
- Wide → Long 変換:pandas の
melt、 R のpivot_longer。 - 可視化ライブラリ (ggplot2, seaborn, plotly) はほぼ tidy data 前提。
💡 Tidy 実務 Tips 集
- 常に raw データを保存:tidy 化後のデータだけだと、 元に戻せない。 「raw → cleaned → tidy → analyzed」 の階層を維持。
- 変換は冪等に:同じスクリプトを 2 回実行しても同じ結果になるよう、 副作用を排除。
- 列名はスネークケース:「消費支出(二人以上の世帯)」 → 「consumption_expenditure」 のように。 日本語列名は
df.query()で扱いにくい。 - 単位は別カラム:「人口(千人)」 → カラム名「人口」、 別に「単位 = 千人」 列。
- 日付は ISO 8601:「YYYY-MM-DD」 形式に統一。 ソート・比較・パースが安定。
- NaN は数値型のまま:「不明」 や「-」 を NaN に変換することで、 欠損集計が容易に。
- カテゴリ列は category 型:メモリ削減と高速化。 都道府県名・性別など反復値の多い列。
- 関数化:「load_ssdse_b()」「to_tidy()」「validate_schema()」 などの関数化で再利用性。
- テスト:tidy 化スクリプトは pytest でテスト。 SSDSE が更新されても挙動が変わらないことを保証。
- ドキュメント:「この列は何を意味するか」 を README/コメントで明示。 半年後の自分のために。
📊 Tidy data と Excel 文化の対立
日本企業の多くは Excel 中心のデータ文化を持っており、 これが tidy data 思想とは正反対です。 Excel の典型的アンチパターン:
- セル結合:見た目を整えるためにセルを結合。 機械可読性を完全に破壊。
- 色情報による分類:行の背景色で「重要」「保留」 を表現。 CSV エクスポートで消える。
- 複数表が 1 シート:「人口表」 と「経済表」 が縦に並ぶ。 自動読込が困難。
- 注釈が混在:「※」 でデータの注意書きをセルに直接書く。
- 合計行・列:データと集計が混在。 group_by が二重カウントする。
- 図表が混在:シート内にチャートとデータが同居。
SSDSE はこれら全てを排除し、 1 シート 1 表、 セル結合なし、 注釈は別ファイル という tidy 原則を厳守。 これが「教育用標準」 を名乗る所以です。 自治体オープンデータの多くはまだ Excel 文化に染まっており、 tidy 化に時間がかかる現状があります。
🔮 Tidy data の未来
2026 年現在、 tidy data 思想は次のように進化しています:
- LLM 時代の役割再評価:LLM に CSV を渡すとき、 tidy だと出力品質が劇的に上がる。 「LLM 向け前処理」 として tidy 化の重要性が増している。
- 列指向ストレージの標準化:Arrow / Parquet がデファクト。 tidy データを列指向で持てば、 wide ⇄ long の変換コストが激減。
- polars / DuckDB の台頭:tidy 入力前提の高速処理エンジン。 SSDSE-D(市区町村) 程度の規模なら 100 倍速。
- データ契約(Data Contracts):tidy 形式とスキーマを「契約」 として明示し、 アップストリームの変更を厳密に管理する文化。
- tidy + 確率的:単一値ではなく分布を持つ tidy データ(例:tidyposterior) が研究テーマに。
🗄 Tidy data と SQL — 不可分の関係
tidy data の long format は、 そのまま EAV(Entity-Attribute-Value) パターンの DB スキーマになります。
| 操作 | Pandas(tidy) | SQL |
|---|---|---|
| 行フィルタ | df.query() | WHERE |
| 列選択 | df[cols] | SELECT |
| 集約 | df.groupby().agg() | GROUP BY |
| 結合 | df.merge() | JOIN |
| ソート | df.sort_values() | ORDER BY |
| long → wide | df.pivot() | PIVOT (SQL Server) |
| wide → long | df.melt() | UNPIVOT |
| ウィンドウ関数 | df.groupby().transform() | OVER() |
| CTE | 変数代入 | WITH |
🌏 多言語データの tidy 化
SSDSE-B-2026 は日本語列名ですが、 国際比較するなら英語版が必要。 tidy 化のついでに翻訳列を作る:
METRIC_MAP = {
    '総人口': 'total_population',
    '合計特殊出生率': 'total_fertility_rate',
    '消費支出(二人以上の世帯)': 'consumption_expenditure',
    '65歳以上人口': 'population_aged_65_and_over',
    '大学数': 'number_of_universities',
}
df_long['metric_en'] = df_long['指標'].map(METRIC_MAP)
df_long.to_csv('SSDSE_tidy_bilingual.csv', index=False)
国際論文や OECD データとの比較分析で重要。 tidy 形式なら英語版の追加は 1 列の merge だけで完了。
📍 文脈ボックス
🍰 まずはやさしく
データ処理というグループの用語です。
全体の流れの中で意味を理解するために使います。
スマホのアプリでデータを扱うときにも役立ちます。
ここではこの用語の詳しい解説を読みます。
この用語は データ処理 カテゴリに属します。 関連する別称・略号:整然データ。
論文・実務レポートで Tidy data が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
本ページでは「tidy data」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「tidy data」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
データの形を整える考え方です。
コンピューターが処理しやすい形にするために使います。
テストの点数を年度ごとに並べる例で考えます。
ここでは見た目の違いと使い分けを読みます。
tidy data(整然データ)は「1 行 = 1 観測、 1 列 = 1 変数、 1 表 = 1 観測単位」という Hadley Wickham (2014) が定式化した形式。 SSDSE-B-2026 で具体的に見ると、 同じ情報を 2 つの表現で持てます。
Wide 形式(クロス表): 横軸に年度、 縦軸に都道府県、 セルに人口を置く。 47 行 × 10 列のマトリクス。 ヒトの目には見やすいが、 列名に 年度の値(2014, 2015, ...)が埋め込まれていて、 「年度」自体が変数として扱われていない。
| 都道府県 | 2014 | ... | 2023 |
|---|---|---|---|
| 北海道 | 5,410,000 | ... | 5,092,000 |
| 東京都 | 13,390,000 | ... | 14,090,000 |
Long 形式 / tidy 形式: 同じ情報を「都道府県, 年度, 総人口」の 3 列・564 行(47 都道府県 × 12 年度)で持つ。 列が 変数、 行が 観測と完全に対応する。 機械的処理向き。
| 都道府県 | 年度 | 総人口 |
|---|---|---|
| 北海道 | 2014 | 5,410,000 |
| 北海道 | 2023 | 5,092,000 |
| 東京都 | 2014 | 13,399,000 |
| 東京都 | 2023 | 14,086,000 |
tidy にする 3 つの実利:
- 可視化が一発: seaborn なら
sns.lineplot(data=df, x='年度', y='総人口', hue='都道府県')。 wide 形式だとdf.melt()で変換が必要。 - 集計が宣言的に書ける:
df.groupby('年度')['総人口'].sum()。 wide 形式だと年度列を 1 つ 1 つ参照する手続き的コードに。 - 新しい年度を追加するときに列構造を変えなくて良い: long なら新規行を append するだけ、 wide だと列を追加する必要があり下流の処理が壊れる。
tidy ⇄ wide の変換: pandas では df.melt()(wide → long)、 df.pivot()(long → wide)。 SSDSE-B-2026 の生 CSV は year × prefecture の (10×47)=470 行 long 形式なので、 すでに tidy。 ただし 変数が複数列に渡ると Wickham 第 1 原則に違反するので、 melt で「指標名」列に集約することも。
🎮 触って理解する
雑然データ(untidy data)には代表的な 3 大パターン があります。 タブで切り替え、 変換ボタンを押す(またはスライダを動かす・図の上を左右にドラッグする)と、 SSDSE-B-2026 の実測値がアニメーションしながら整然形へ組み変わります。 下の比較パネルで「同じ集計がどれだけ簡単になるか」も確かめてください。 基本の wide ⇄ long トグルは 表形式データ のページにもあります。 このページでは 3 パターンそれぞれの修復関数の違いを深掘りします。
操作: タブでパターン切替 / ボタンでアニメーション変換 / スライダまたは図の上を左右ドラッグ(タッチ対応)で途中経過をスクラブ。 値はすべて SSDSE-B-2026 実測値。
💡 直感の整理 — 3 原則と 3 大パターンの対応
整然データの直感は「1 行 = 1 観測・1 列 = 1 変数・1 表 = 1 観測単位」の 3 点セット。 上の 3 パターンは、 それぞれどの原則がどう破られているかが異なり、 だから修復関数も異なります。
| 雑然パターン | 破られている原則 | pandas | tidyr (R) |
|---|---|---|---|
| ① 列名が値(2021, 2022, … が列) | 1 列 = 1 変数(「年度」変数が列名に散在) | melt | pivot_longer |
| ② 複数変数が 1 列(「男_65歳以上」) | 1 列 = 1 変数(1 列に性別+年齢階級の 2 変数) | str.split(expand=True) | separate |
| ③ 1 観測が複数行(指標名・値の超縦持ち) | 1 行 = 1 観測(1 県の観測が複数行に分散) | pivot | pivot_wider |
特にパターン③は重要な気づきを与えます。 「縦長にすれば整然」ではない。 観測単位が「都道府県」なら 1 県 1 行が整然であり、 縦持ちしすぎ(EAV 形式)はむしろ雑然。 整然かどうかは観測単位を何と定めるかで決まります。
⚠️ よくある落とし穴 — 「見た目が綺麗」 ≠ 整然
- 見た目の綺麗さと整然性は別物: セル結合・合計行・色分けされた Excel 表は人間には「綺麗」でも機械には雑然。 逆に、 素っ気ない縦長の表こそ整然であることが多い。 判定基準は見た目ではなく「1 行 1 観測・1 列 1 変数」を満たすか。
- 分析目的による使い分け: scikit-learn の特徴量行列は wide、 seaborn / ggplot2 は long が前提。 整然形は「最終形」ではなく基準形(ハブ)。 整然形を起点に
melt/pivotで目的の形へ行き来するのが実務の型。 - 縦持ち至上主義: パターン③のとおり、 観測単位に対して 1 行 1 観測になっていない縦長は雑然。 EAV は保存・スキーマ拡張には便利だが、 列同士の演算には
pivotが必要になる。 - 変換の往復で情報が劣化する:
melt→pivotの往復で dtype が object 化したり、 組合せの直積化で欠損 (NaN) が暗黙に増えることがある。 変換後はdf.dtypesとdf.isna().sum()の確認を習慣に。
🚀 発展 — pandas 対応表と正規化との関係
3 パターンの修復は DB 正規化理論と対応します。 ②の separate は第 1 正規形(アトミック性: 1 セル 1 値)の回復、 ③の pivot は関数従属の整理(主キー = 都道府県に対する 1 行化)に相当。 tidy data は「第 3 正規形を分析しやすさの言葉で言い直したもの」という理解が発展的な整理です(詳細は上の「📐 定義・数式」参照)。 pandas では melt / pivot の他に、 集計を伴う pivot_table、 「指標_年」形式の列名に強い wide_to_long、 MultiIndex ベースの stack / unstack も同じ族の操作です。 関連ページ: 表形式データ / 縦持ち・横持ち / ピボットテーブル / groupby / pandas / DataFrame / テーブル結合。
📐 定義・数式
🍰 まずはやさしく
データの作り方のルールです。
誰が書いても同じ形にするために使います。
買い物リストの書き方を決めるようなものです。
ここでは3つの原則について詳しく読みます。
Wickham (2014) で定式化された定義。 リレーショナル DB の第三正規形に近いが、 「分析しやすさ」を目的としている点が異なる。
📐 Codd 第 1〜3 正規形と Tidy data の対応
Tidy data の 3 原則(1 行 1 観察、 1 列 1 変数、 1 値 1 セル)は、 リレーショナルデータベース理論の祖 E.F. Codd(1970)が提唱した 正規形(Normal Form) と本質的に同じ構造を持ちます。 数式的に整理すると次の通り:
関係 R が第 1 正規形(1NF)であるとは
$$ \forall t \in R, \forall A_i \in \text{Attr}(R): t[A_i] \in \text{Domain}(A_i) \text{ かつ } t[A_i] \text{ はアトミック} $$🔬 数式を言葉で読み解く
- R:関係(テーブル)
- t:タプル(行)
- A_i:属性(列)
- アトミック:これ以上分割できない単一値(例:「東京都/大阪府」と一つのセルに入れない)
→ これが Tidy data の「1 値 1 セル」と同義。 Codd の 1NF は 1970 年に提唱されたが、 Hadley Wickham(2014)の Tidy data 論文は これを統計家の言語で再定義 したものと言えます。
| Codd 用語 | Tidy data 用語 | SSDSE での具体例 |
|---|---|---|
| 関係 R | データセット | SSDSE-B-2026.csv 全体 |
| タプル t | 観察 | 1 都道府県 1 年のレコード |
| 属性 A | 変数 | 総人口、 消費支出、 出生数 |
| ドメイン Domain(A) | 値域 | 総人口 ∈ ℕ、 緯度 ∈ [-90, 90] |
| 主キー | 識別子列 | Code(地域コード)× SSDSE-B-2026(年度) |
📐 第 2・第 3 正規形と tidy data の関係
Codd 正規形は 1NF だけでなく 2NF, 3NF, BCNF へと続きます。 tidy data はおおむね 3NF まで意識すれば実務的に十分です。
第 2 正規形(2NF)
$$ \text{任意の非主属性 } A: \text{主キー全体に対して関数従属 } A = f(\text{PK}) $$数式を言葉で読み解く
「複合主キーがあるとき、 非キー列はその 主キー全体 に従属していなければならない(一部の列だけに従属していてはいけない)」。 例:(都道府県, 年) を主キーとしたとき、 「都道府県の所在地(北海道, 関東, …)」は 都道府県だけに従属 しているため 2NF 違反。 → 別テーブルに分けるべき。
第 3 正規形(3NF)
$$ \forall \text{非主属性 } A, B: A \rightarrow B \Rightarrow B \text{ も主キーに直接従属} $$数式を言葉で読み解く
「非キー列同士の従属関係を許さない」。 例:(都道府県コード, 都道府県名, 県庁所在地) があるとき、 「県庁所在地」は「都道府県名」に従属している(推移従属)。 → これも別テーブルに分けるのが 3NF。
| 正規形 | 条件 | SSDSE での例 |
|---|---|---|
| 1NF | アトミック性 | 1 セルに「東京都/大阪府」と書かない |
| 2NF | 完全関数従属 | (都道府県, 年) を PK としたとき、 「都道府県名」だけに従属する列は別表へ |
| 3NF | 非推移従属 | 「都道府県名 → 県庁所在地」は別表へ |
| BCNF | 候補キーへの依存 | 複数候補キーの曖昧性除去 |
tidy data は 1NF を最優先。 分析時には join で wide に戻すため、 過度な正規化は性能を損なうこともある(denormalization の判断が必要)。
🚨 untidy(汚いデータ)の 5 大パターンと修復
Wickham(2014)は untidy データを 5 つの典型パターンに分類しました。 SSDSE 系の公的統計でもしばしば見かけるので、 各パターンの修復コードを示します。
パターン 1:列ヘッダが値になっている
例:「2020年, 2021年, 2022年」が列名になっているケース。 → melt で年を 1 つの列にまとめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd # untidy 例:年が列名 untidy = pd.DataFrame({ '都道府県': ['北海道', '東京都', '大阪府'], '2020年': [5224614, 14047594, 8837685], '2021年': [5183687, 14010000, 8800000], '2022年': [5140000, 14040000, 8784000] }) print('--- untidy(年が列名)---') print(untidy) # tidy 化 tidy = untidy.melt(id_vars='都道府県', var_name='年', value_name='人口') print('\n--- tidy(年を 1 列にまとめた)---') print(tidy) |
📤 実行結果:
💬 結果の読み方:時系列プロットや回帰モデルを使うには「年」を 変数 として扱う必要がある。 untidy のままだと「2020年カラムと2021年カラムを比較するコード」を毎回書く羽目になる。
パターン 2:1 セルに複数の値
例:「東京都, 大阪府, 福岡県」と 1 セルに格納。 → str.split + explode。
パターン 3:複数変数が 1 列に
例:「男_15-19歳」「男_20-24歳」のように性別と年齢が結合。 → str.split で 2 列に分離。
パターン 4:変数が複数の表に分散
例:県別人口と県別 GDP が別ファイル。 → 都道府県コードで merge。
パターン 5:1 つの観察単位が複数行に分散
例:「都道府県, 男性人口」「都道府県, 女性人口」と 2 行に分かれている。 → pivot で 1 行に統合。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- row
- 1 行 = 1 観測 (例:1 都道府県・1 年度)。
- column
- 1 列 = 1 変数 (例:人口・出生数)。
- table
- 1 テーブル = 1 種類の観測単位。 異種を混ぜない。
- Long vs Wide
- Long = tidy、 Wide = クロス表。
🔬 Tidy data を言葉で読み解く(narration )
Tidy data の 3 原則を Hadley Wickham(2014, JSS)の言葉で書くと:
- 各変数は 1 つの列に(Each variable forms a column)
- 各観測は 1 つの行に(Each observation forms a row)
- 各観測単位の種類は 1 つの表に(Each type of observational unit forms a table)
この 3 原則を SSDSE-B-2026 で噛み砕いてみましょう。 SSDSE-B-2026 は 47 行(都道府県)× 約 100 列(変数) の表。 (1) 列名「総人口」「消費支出」「合計特殊出生率」 は 変数。 (2) 各行「東京都」「大阪府」「沖縄県」 は 観測(観測単位=都道府県)。 (3) 「都道府県」 という観測単位が 1 つの表に。 これは tidy です。
逆に「Excel 風」 の表(年×列、 都道府県×行、 セルに値) は wide format で、 多くの場合 untidy。 たとえば「年 ×(東京都, 大阪府, 沖縄県)」 のような表で、 列名が「東京都の人口」「大阪府の人口」… となっていたら、 「都道府県」 という変数が 列名に埋め込まれている ── これは tidy 原則 (1) 違反。 解決法は pd.melt() で「都道府県」 列に縦長化すること。
なぜ tidy にこだわるか? ── 分析パイプラインの標準化のため。 pandas, dplyr, ggplot2, scikit-learn など現代のデータ分析ツールは tidy 入力を前提 に設計されています。 untidy なデータを与えると、 「集計したいけど列名がバラバラ」「グラフを描きたいけど縦長じゃない」 と詰まる。 Wickham 自身が「tidy data はゴールではなく出発点」 と述べているとおり、 整形に時間を掛けるほど後の分析が楽になる。
SSDSE-B-2026 を tidy にすることで、 47 都道府県 × 100 変数 = 4,700 セルが 4,700 行 × 3 列(都道府県, 変数名, 値) に変換される。 すると、 「変数名 = 合計特殊出生率」 だけ抽出して 47 行を取り出すのが df.query('変数名 == "合計特殊出生率"') 1 行。 「変数名 = 消費支出(二人以上の世帯)」 と join するのも 1 行。 これが tidy の生産性です。
🧮 実値で計算してみる
SSDSE-B のクロス表を tidy 形式に変換する例。
🧮 SSDSE-B-2026 を tidy に変換
SSDSE-B-2026 は すでに tidy 形式(47 行 × 多数列、 各都道府県が観測単位)。 これを「超 tidy(long format)」 に変換すると、 4,700 行 × 3 列の縦長表になります:
| 都道府県 | 変数名 | 値 |
|---|---|---|
| 北海道 | 総人口 | 5,092,000 |
| 北海道 | 消費支出(二人以上の世帯) | 296,888 |
| 北海道 | 合計特殊出生率 | 1.06 |
| 東京都 | 総人口 | 14,086,000 |
| 東京都 | 消費支出(二人以上の世帯) | 341,320 |
| 東京都 | 合計特殊出生率 | 0.99 |
| 沖縄県 | 総人口 | 1,468,000 |
| 沖縄県 | 消費支出(二人以上の世帯) | 251,222 |
| 沖縄県 | 合計特殊出生率 | 1.60 |
この形式は ggplot2 や seaborn でプロットに直接渡せます。 facet_wrap('変数名') 1 行で 100 個の指標を並べて描けます。
📏 Wide vs Long フォーマット — 使い分けの実務
tidy の概念は重要ですが、 「常に long が tidy」 ではありません。 場面によって最適形が変わる。
| 用途 | 推奨 | 理由 |
|---|---|---|
| 機械学習の入力 | Wide | 特徴量行列 X が必要 |
| 可視化(ggplot2/seaborn) | Long | facet 指定に使う |
| 集計(groupby) | Long | 変数別の処理が楽 |
| 表示・Excel 出力 | Wide | 人間が読みやすい |
| DB 保存 | Long または EAV | スキーマ拡張容易 |
| 時系列分析 | Long(時間=長辺) | resample, rolling が効く |
pivot と melt は対の操作。 wide ↔ long を自在に行き来できることが tidy data 思想の核心です。
🧮 数式に値を入れて手で計算する: tidy 化前後の行数
合成 wide テーブル (3 行×4 月) を tidy (long) に変換した行数を計算する。
Step 1: wide
Step 2: long
🐍 Python で再現
1 2 3 4 | import pandas as pd wide = pd.DataFrame({'id':['A','B','C'], 'Jan':[10,20,30],'Feb':[12,22,32],'Mar':[14,24,34],'Apr':[16,26,36]}) long = wide.melt(id_vars='id', var_name='月', value_name='値') print(f"wide 形: {wide.shape}, long 形: {long.shape}") |
📤 実行結果
💬 手計算 (Step 2) 12 行と Python 出力が完全一致。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 | import pandas as pd df_wide = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_long = df_wide.melt(id_vars='Prefecture', var_name='指標', value_name='値') print(df_long.head()) |
🐍 Tidy 変換コード(SSDSE-B-2026)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import pandas as pd # SSDSE-B-2026 読み込み(2023 年度・コード列名を日本語へリネーム) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = (df[df['SSDSE-B-2026'] == 2023] .rename(columns={'Prefecture': '都道府県', 'A1101': '総人口', 'A4103': '合計特殊出生率', 'L3221': '消費支出', 'C5401': '標準地価'}) .drop(columns=['SSDSE-B-2026', 'Code'])) # wide → long 変換(melt) df_long = df.melt(id_vars=['都道府県'], var_name='変数名', value_name='値') print(df_long.head(10)) print(f'\nshape: {df_long.shape}') # (47*109, 3) = (5123, 3) # long → wide 変換(pivot) df_wide = df_long.pivot(index='都道府県', columns='変数名', values='値').reset_index() print(f'\nwide shape: {df_wide.shape}') # (47, 110) # tidy の威力:変数別の集計が 1 行 summary = df_long.groupby('変数名')['値'].agg(['mean', 'std', 'min', 'max']) print(summary.head()) # tidy の威力:複数変数を facet で同時可視化 import seaborn as sns import matplotlib.pyplot as plt target_vars = ['合計特殊出生率', '消費支出', '標準地価'] df_subset = df_long[df_long['変数名'].isin(target_vars)] g = sns.FacetGrid(df_subset, col='変数名', col_wrap=3, height=4, sharey=False) g.map(sns.histplot, '値') plt.savefig('tidy_facet.png', dpi=120) |
3 つのコア操作 melt / pivot / groupby を覚えれば、 SSDSE のような表データを自在に変形できます。
🐍 Python 実装:SSDSE-B-2026 を tidy 化する完全パイプライン
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 「都道府県 × 指標」の wide 形式から「都道府県, 指標名, 値」の long 形式(tidy)へ melt で変換。 さらに pivot_table で wide に戻して可逆性を確認する。
📥 入力データ(wide 形式、 SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd # SSDSE-B-2026 を読込(1 行目=コード見出し、 2 行目=日本語見出しを除外) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 2023 年の断面を取り出し、 コード列を日本語名にリネーム df = (df[df['SSDSE-B-2026'] == 2023] .rename(columns={'Code': '地域コード', 'Prefecture': '都道府県', 'A1101': '総人口', 'L3221': '消費支出', 'A4101': '出生数'}) .reset_index(drop=True)) # 関心ある列だけ抽出(wide 形式) wide = df[['地域コード', '都道府県', '総人口', '消費支出', '出生数']].head(5) print('--- wide 形式(変換前)---') print(wide) # wide → long (tidy 化): melt long_tidy = wide.melt( id_vars=['地域コード', '都道府県'], var_name='指標', value_name='値' ) print('\n--- long 形式(tidy data)---') print(long_tidy.head(15)) # long → wide (元に戻す): pivot_table wide_back = long_tidy.pivot_table( index=['地域コード', '都道府県'], columns='指標', values='値' ).reset_index() print('\n--- pivot で wide に戻した結果 ---') print(wide_back) |
📤 実行結果:
💬 結果の読み方:melt は「列をそのまま縦長に並べる」だけのシンプル操作。 long 化することで 1 行 = 1 観察 = (都道府県, 指標) の組 となり、 ggplot や seaborn の hue='指標' がそのまま使えるようになる。 pivot で wide に戻せば Excel 風表示にも対応。
🐍 Python 実装:scikit-learn 形式(X, y)への変換
🎯 このコードでやること:SSDSE-B-2026 tidy data から scikit-learn の (X, y) 形式(特徴量行列とターゲット)へ変換し、 そのまま線形回帰モデルに投入する。
📥 入力データ:tidy data 形式の SSDSE-B-2026。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].rename(columns={ 'A1101': '総人口', 'L3221': '消費支出', 'A1303': '65歳以上人口', 'A4103': '合計特殊出生率'}) # tidy 形式から (X, y) へ feature_cols = ['総人口', '消費支出', '65歳以上人口'] target_col = '合計特殊出生率' # 欠損を除去 df_use = df[feature_cols + [target_col]].dropna() # 特徴量行列 X とターゲット y X = df_use[feature_cols].values # shape: (n_samples, n_features) y = df_use[target_col].values # shape: (n_samples,) print(f'X shape: {X.shape} (n_samples × n_features)') print(f'y shape: {y.shape}') # 標準化(オプション) X_scaled = StandardScaler().fit_transform(X) # 線形回帰 model = LinearRegression() model.fit(X_scaled, y) coef = {c: round(float(v), 3) for c, v in zip(feature_cols, model.coef_)} print(f'\n係数: {coef}') print(f'切片: {model.intercept_:.2f}') print(f'決定係数 R²: {model.score(X_scaled, y):.4f}') |
📤 実行結果:
💬 結果の読み方:tidy data ならカラム選択 → .values → モデル fit が 3 行。 untidy(ピボット形式)だと前処理に 30 行は要る。 R² = 0.46 は中程度の説明力で、 65歳以上人口の負係数(高齢人口↑ → 合計特殊出生率↓)が直観に合う。
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
⚠️ Untidy の 5 大パターン(Wickham 2014)
- 列ヘッダが値:列名が「2020年」「2021年」「2022年」… → 「年」 という変数が列に埋まっている。 melt で long 化。
- 複数の変数が 1 列:列「年齢_性別」 が「30_男」「40_女」… → str.split() で分離。
- 1 セルに複数値:列「タグ」 に「読書,料理,旅行」 のような連結値 → str.split + explode。
- 同じ変数が複数列:列「収入_2022」「収入_2023」 → melt で年を変数化。
- 異なる観測単位が 1 表:個人レベルと世帯レベルが混在 → 分割して 2 表に。
🏛 政府統計と tidy data — e-Stat / SSDSE の評価
日本の政府統計(e-Stat) の多くは Excel ファイル形式で、 untidy な構造を持っています。 セル結合、 ヘッダ階層、 表中表 ── 美しく印刷するためのレイアウトが、 機械可読性を犠牲にしています。
SSDSE(Statistical Standardized Data Set for Education) は、 まさに「政府統計を tidy 化したデータセット」 です。 統計センターが教育用に整備し、 1 行 1 都道府県(または市区町村)、 1 列 1 変数の構造を厳守。 これにより、 学生や研究者が 整形に時間を掛けず、 分析に集中できる。
本サイトが SSDSE を主軸に据えるのも、 「tidy データから始めることで、 ジャストインタイム型学習がスムーズに回る」 から。 ぜひ e-Stat の生 Excel と SSDSE 版の同じ統計を比較して、 tidy の威力を体感してください。
🛠 Tidyverse — Hadley Wickham の生態系
R の tidyverse は、 tidy data 原則を基礎にした統合パッケージ群:
| パッケージ | 役割 | Python 等価 |
|---|---|---|
readr | CSV/TSV 読込 | pandas.read_csv |
tidyr | tidy 化(pivot/melt) | pd.melt / pd.pivot |
dplyr | データ操作 | pandas / polars |
ggplot2 | グラフィックス | seaborn / plotnine |
purrr | 関数型処理 | map / functools |
tibble | 改良 data frame | pd.DataFrame |
stringr | 文字列処理 | str.* メソッド |
forcats | factor 処理 | pd.Categorical |
Python では plotnine(ggplot2 移植) や plydata(dplyr 移植) がある。 また polars は tidyverse 風 API で高速。
🔄 Tidy の代替・拡張概念
(a) Tidy 拡張:Codd の第1正規形
tidy data 原則は、 リレーショナルデータベース理論の 第1正規形(1NF) と本質的に同じ。 Wickham は統計家向けに言い直しただけとも言えます。
(b) EAV(Entity-Attribute-Value)
tidy の long format は EAV モデルと同型。 「都道府県 / 変数名 / 値」 がまさに EAV。 ただし大量データでは検索性能が課題。
(c) Star Schema
データウェアハウスで使う 中心 fact 表 + 周辺 dimension 表 の構造。 BI ツール向けに最適化されている。
(d) Arrow / Parquet
tidy はあくまで論理構造。 物理保存形式は 列指向(Parquet, Arrow) が現代の主流。 圧縮効率と読み込み速度が桁違い。
📘 ケーススタディ 3 件
ケース 1:SSDSE-E(時系列) を tidy 化
SSDSE-E は「2010年」「2011年」… のような 年が列に 入った wide format。 これを melt で 都道府県 / 変数 / 年 / 値 の 4 列に変換すると、 時系列プロットや経年比較が一気に楽になる。
ケース 2:家計調査 SSDSE-C
「品目別 × 地域別」 の 2 次元集計を、 「品目 / 地域 / 支出額」 の long に。 「肉類の支出が最も多い都市は?」 が groupby('地域').sum() 1 行。
ケース 3:自治体オープンデータ
市町村が公開する Excel は untidy の宝庫。 セル結合、 階層ヘッダ、 注釈行が混在。 これを tidy 化するときは、 まず手動で「ヘッダ行はどこか」「データ開始行はどこか」 を特定し、 pd.read_excel(skiprows=, header=) で読み込む。 その後 melt で long 化。
🚀 現代の tidy — DuckDB / polars / DataFrames.jl
tidy data 思想は SQL の世界にも浸透。 DuckDB(埋め込み OLAP)、 polars(Rust 製 DataFrame)、 DataFrames.jl(Julia)、 いずれも tidy 入力を前提に高速処理を実現。
- DuckDB:CSV/Parquet/Arrow を直接 SQL でクエリ。 pandas より 10倍速いことも。
- polars:Pandas の代替。 lazy evaluation で大規模データに強い。
- pyarrow:列指向の中間表現。 ゼロコピーで pandas/polars/DuckDB と相互運用。
SSDSE-B-2026 は小規模(47×100)なので Pandas で十分ですが、 全国市区町村 SSDSE-D(1700 行 × 100 列) や時系列 SSDSE-E では polars / DuckDB の利点が出てきます。
📜 Tidy data の哲学 — Hadley Wickham の論文
原論文:Wickham, H. (2014). "Tidy Data". Journal of Statistical Software, 59(10), 1-23. オープンアクセスで誰でも読めます。
Wickham は次の問題意識から tidy data を提案:「データクリーニングと分析の境界がぼやけている。 分析時間の 80% がデータ整形に消費される。 これを 規範化 することで、 ツール開発と教育が大幅に効率化できる。」
tidy 原則は単なる「綺麗な表」 のことではなく、 標準化を通じて生産性を上げる思想。 ある意味で「データのオブジェクト指向設計」 と呼べる発想で、 ggplot2 や dplyr が「tidy 入力に対する標準操作」 として設計されたからこそ、 tidyverse は爆発的に普及しました。
Wickham 自身は近年、 「tidy data は終着点ではなく、 出発点」 と強調。 「整形済みデータから始めることで、 創造的な分析に集中できる。 SSDSE はその精神を体現したデータセット」 と評価できます。
✅ Tidy data チェックリスト 20 項目
構造
- □ 各列が 1 つの変数 を表しているか
- □ 各行が 1 つの観測 を表しているか
- □ 各表が 1 つの観測単位の種類 だけを含むか
- □ 列名が値ではないか(「2020年」「2021年」 が列名になっていないか)
- □ 1 セルに 1 値か(カンマ区切り値が入っていないか)
命名
- □ 列名がスネークケース or 一貫したスタイル
- □ 列名に空白・特殊文字を含まない
- □ 単位が列名 or 別カラムに明記
- □ NA の表現方法が統一されている
- □ ID 列が明確
型
- □ 数値列が文字列になっていない
- □ 日付列が datetime 型
- □ カテゴリ列が factor / category 型
- □ 真偽列が boolean
- □ 通貨が float(カンマ区切り解除済み)
運用
- □ メタデータ(出典、 取得日) を別ファイルで管理
- □ 再現可能な変換スクリプトがある
- □ バージョン管理(Git) されている
- □ CSV または Parquet で保存
- □ README に変数定義を記載
🔁 高度な melt / pivot — 複数 ID, 複数 value
基本の melt / pivot を超えた応用例。 SSDSE-B-2026 で 都道府県 + 年度 を ID にし、 wide → long → wide を往復する例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = (df[df['SSDSE-B-2026'] == 2023] .rename(columns={'Prefecture': '都道府県', 'A1101': '総人口', 'A4103': '合計特殊出生率', 'L3221': '消費支出'})) # 複数 ID で melt df_long = df.melt( id_vars=['都道府県'], value_vars=['総人口', '合計特殊出生率', '消費支出'], var_name='指標', value_name='値' ) print(df_long.head()) # wide_to_long: 列名が「指標_年」 形式のとき強力 # 例:列が「人口_2020」「人口_2021」「失業率_2020」「失業率_2021」 … df_wide = pd.DataFrame({ '都道府県': ['東京都', '大阪府', '沖縄県'], '人口_2020': [13960, 8838, 1468], '人口_2021': [13960, 8806, 1468], '失業率_2020': [2.6, 3.2, 3.5], '失業率_2021': [2.7, 3.3, 3.7], }) df_wl = pd.wide_to_long( df_wide, stubnames=['人口', '失業率'], i='都道府県', j='年', sep='_', suffix='\\d+' ).reset_index() print(df_wl) # pivot_table: 集計と pivot を同時に pivot = df_long.pivot_table( index='都道府県', columns='指標', values='値', aggfunc='mean' ) print(pivot.head()) # crosstab: カテゴリ × カテゴリ の度数集計 # 例:合計特殊出生率を 3 階級に区切って都道府県分布を見る df['出生率3階級'] = pd.cut(df['合計特殊出生率'], bins=[0.9, 1.2, 1.4, 1.7], labels=['低', '中', '高']) # 2023年度: 低11県・中27県・高9県 print(pd.crosstab(df['出生率3階級'], df['都道府県'].apply( lambda x: '関東' if x in ['東京都','神奈川県','埼玉県','千葉県'] else '関東外' ))) |
🔄 dplyr 操作と Pandas 対応表
| dplyr (R) | Pandas (Python) | 機能 |
|---|---|---|
filter() | df.query() / df[cond] | 行フィルタ |
select() | df[cols] / df.filter() | 列選択 |
mutate() | df.assign() | 列追加 |
arrange() | df.sort_values() | 並び替え |
summarise() | df.agg() | 集約 |
group_by() | df.groupby() | グループ化 |
pivot_longer() | pd.melt() | wide → long |
pivot_wider() | df.pivot() | long → wide |
separate() | df['col'].str.split(expand=True) | 列分割 |
unite() | df['col1'].str.cat() | 列連結 |
left_join() | df.merge(how='left') | 結合 |
inner_join() | df.merge(how='inner') | 内部結合 |
distinct() | df.drop_duplicates() | 重複除去 |
count() | df.value_counts() | 頻度カウント |
top_n() | df.nlargest() / nsmallest() | 上位 N 抽出 |
🛠 SSDSE → tidy → 分析 完全パイプライン
SSDSE-B-2026 を tidy 化し、 分析・可視化まで一気通貫:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 | import os os.makedirs('data', exist_ok=True) # 書き出し先を先に作る import pandas as pd import matplotlib.pyplot as plt import seaborn as sns # ===== STEP 1: 読み込み(2023 年度・コード列名を日本語へ) ===== df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = (df[df['SSDSE-B-2026'] == 2023] .rename(columns={'Prefecture': '都道府県', 'A1101': '総人口', 'A4103': '合計特殊出生率', 'L3221': '消費支出', 'A4101': '出生数', 'A1303': '65歳以上人口'}) .drop(columns=['SSDSE-B-2026', 'Code'])) print(f'読み込み: {df.shape}') # ===== STEP 2: tidy 化(wide → long) ===== df_long = df.melt( id_vars=['都道府県'], var_name='指標', value_name='値' ) # ===== STEP 3: 指標別の基礎統計 ===== stats = df_long.groupby('指標')['値'].agg( ['mean', 'std', 'min', 'max', 'count'] ).round(2) stats.to_csv('data/processed/SSDSE_stats.csv') print(stats.head()) # ===== STEP 4: 特定指標の都道府県ランキング ===== target = '消費支出' ranking = df_long[df_long['指標'] == target].sort_values('値', ascending=False) print(f'\n=== {target} TOP10 ===') print(ranking[['都道府県', '値']].head(10)) # 1位 埼玉県 344,092 / 2位 東京都 341,320 / 3位 三重県 332,663 # ===== STEP 5: 複数指標の相関行列 ===== target_indicators = ['総人口', '合計特殊出生率', '消費支出', '出生数', '65歳以上人口'] df_wide_subset = df[['都道府県'] + target_indicators] corr = df_wide_subset[target_indicators].corr() print('\n=== 相関行列 ===') print(corr.round(2)) # 例: corr(総人口, 出生数)=1.00, corr(総人口, 合計特殊出生率)=-0.56 # ===== STEP 6: facet 可視化 ===== df_long_subset = df_long[df_long['指標'].isin(target_indicators)] g = sns.FacetGrid(df_long_subset, col='指標', col_wrap=3, height=4, sharey=False) g.map(sns.histplot, '値', kde=True) plt.savefig('data/processed/SSDSE_facets.png', dpi=120) # ===== STEP 7: tidy で保存(long 形式) ===== df_long.to_csv('data/processed/SSDSE_long.csv', index=False) df_long.to_parquet('data/processed/SSDSE_long.parquet') print('\nパイプライン完了') |
⚠️ Tidy アンチパターン 10 連続
- 「年」 が列名:「2020年」「2021年」… → 「年」 列を作って melt
- セル結合:Excel で「東京都 | | 神奈川県」 のような結合セル → ffill で展開
- 合計行:「合計」「平均」 がデータ行に混入 → フィルタで除外
- 階層ヘッダ:1 行目「人口」、 2 行目「総数 男 女」 → MultiIndex 処理
- 注釈行:データの末尾に「※注:…」 → skipfooter で除外
- カンマ区切り数値:「1,000,000」 が文字列 → str.replace + astype
- 全角空白:「東京 都」 のように全角空白 → str.replace で正規化
- 欠損が「-」「N/A」「・・・」 → na_values で指定
- シート分割:年度ごとに別シート → pd.concat で結合
- 列名が日本語+単位:「人口(千人)」 → 別カラムに分離
📜 Tidy data の歴史
1970 年代:E.F. Codd がリレーショナルデータベースを提唱、 正規化理論を確立。
2000 年代:R の reshape, reshape2 パッケージ(Wickham) が melt/cast を一般化。
2014 年:Wickham が JSS に "Tidy Data" を発表。 統計家向けの「データのきれいさ」 規範を確立。
2016 年:tidyverse がメタパッケージとしてリリース。 R の標準スタイルに。
2020 年代:polars / DuckDB が「tidy 入力 + 列指向 + Arrow」 で次世代分析ツール群を構築。
2024 年〜:LLM 時代でも tidy data は健在。 「LLM に CSV を貼り付けて分析を頼む」 ようなユースケースでも、 入力が tidy だと出力品質が劇的に向上する。
🔍 Tidy data FAQ 追加
Q. tidy だと容量が増えませんか?
A. long 形式は同じ ID が繰り返されるので素朴には増えます。 ただし Parquet/Arrow 等の列指向で保存すると、 重複は圧縮され実質的に増えません。
Q. tidy が苦手な分野は?
A. 画像・音声・テキストなどの非構造化データ、 行列演算が中心の数値計算(NumPy 風)、 グラフ構造(NetworkX, igraph) では tidy 思想は適合しません。 適材適所。
Q. データベース設計と tidy の関係は?
A. tidy = 第3正規形(3NF)以上 を強く推奨。 ただし分析用途では、 結合済みの非正規化テーブル(star schema) を使うのが普通。 用途に応じて使い分け。
Q. tidy 化は完全自動化できますか?
A. 部分的に。 tidylab(実験的) や LLM ベースのツールが登場していますが、 「どの列が変数で、 どれが値か」 の判断は最終的に人間が必要。 SSDSE のように 提供元が整形済み のデータは例外的に楽。
Q. tidy data と pandas の MultiIndex の関係は?
A. MultiIndex(階層 index) は wide format の表現力を上げる pandas 機能ですが、 厳密には untidy です。 tidy 派の人は MultiIndex を避け、 すべて単純な long format にします。 一方、 ピボット集計用には MultiIndex が便利。 場面で使い分け。
🧰 Tidy data 関連ツール
- pandas(Python):標準的なデータフレームライブラリ。 melt/pivot を提供。
- polars(Rust + Python):Pandas の代替、 高速・低メモリ。
- dplyr / tidyr(R):Wickham の tidyverse 中核。
- DataFrames.jl(Julia):高性能で tidy ライク。
- DuckDB:埋め込み OLAP データベース、 tidy 入力に SQL を適用。
- Apache Arrow:tidy データの列指向中間表現、 言語横断。
- Parquet:tidy データの圧縮列指向保存形式。
- Tableau / Power BI:tidy 入力を前提とした BI ツール。
- OpenRefine:untidy データを手動で整形する GUI ツール。
- plotnine(Python):ggplot2 を Python に移植、 tidy 前提のプロット。
🗃 複数テーブルの tidy 設計(SSDSE-B + SSDSE-D + SSDSE-E)
tidy 原則の 3 番目 ── 「各観測単位の種類は 1 つの表に」 が活きるのは複数表を扱うとき。 SSDSE では:
| データセット | 観測単位 | 行数 | 主キー |
|---|---|---|---|
| SSDSE-A | 都道府県 | 47 | 都道府県コード |
| SSDSE-B | 都道府県(拡張) | 47 | 都道府県コード |
| SSDSE-C | 家計(都道府県別品目) | 数千 | 都道府県 × 品目 |
| SSDSE-D | 市区町村 | 1700+ | 市区町村コード |
| SSDSE-E | 都道府県 × 年 | 47×N年 | 都道府県 × 年 |
これらを 1 つの巨大テーブルにマージするのは untidy。 必要に応じて join で結合するのが tidy 流。
1 2 3 4 5 6 7 8 9 | df_a = pd.read_csv('data/raw/SSDSE-A-2026.csv', encoding='cp932', skiprows=[1]) df_b = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_e = pd.read_csv('data/raw/SSDSE-E-2026.csv', encoding='cp932', skiprows=[1]) # A + B を都道府県(Prefecture 列)でマージ df_ab = df_a.merge(df_b, on='Prefecture', suffixes=('_A', '_B')) # E も同じキーで結合 df_full = df_ab.merge(df_e, on='Prefecture') print(df_full.shape) |
🧹 Tidy 化に伴うデータクレンジング 12 ステップ
- Encoding 確認:utf-8, cp932 のいずれか。 SSDSE-B は cp932(Shift_JIS 系)。
- ヘッダ行確認:skiprows でずらすか、 header= を指定。
- 列名の半角化:全角空白・記号を半角に。
- 列名の正規化:スネークケース化、 単位の分離。
- 欠損表現の統一:「-」「N/A」「・・・」 を NaN に。
- 数値型変換:カンマ除去、 単位除去、 型変換。
- 日付型変換:「2026年5月19日」 等を datetime に。
- カテゴリ列の整理:表記揺れを統一(東京都・東京・Tokyo → 東京都)。
- 重複行の確認:drop_duplicates。
- 外れ値検出:箱ひげ図 / IQR / Tukey ルール。
- 合計行・注釈行の除去:「合計」「※」 を含む行を除外。
- tidy 化:melt で long に。
📊 Tidy データの生産性 — 定量比較
同じ分析タスク(「47 都道府県の合計特殊出生率を棒グラフで」) を、 tidy データと untidy データで比較:
| 指標 | tidy | untidy(Excel 直) |
|---|---|---|
| 読込コード行数 | 1 行 | 5-10 行(skiprows, ヘッダ調整) |
| 整形コード行数 | 0-3 行 | 20-50 行 |
| プロット行数 | 1 行(seaborn) | 5-10 行 |
| 合計時間 | 1-5 分 | 30-60 分 |
| エラー発生率 | 低 | 高(型不一致、 NaN 等) |
| 再現性 | 高 | 低(手作業が混ざる) |
この差が、 SSDSE が「教育用標準データセット」 を名乗る所以です。
🧠 Tidy が苦手な領域
tidy data は強力ですが、 万能ではありません。 以下の領域では別のデータモデルが優位:
| 領域 | なぜ苦手か | 代替モデル |
|---|---|---|
| 画像・音声 | 高次元配列 | numpy ndarray, tensor |
| ネットワーク | グラフ構造 | NetworkX, igraph |
| 階層構造 | 親子関係 | JSON, tree |
| 疎データ | 大半が 0 | scipy sparse, COO |
| テキスト | 可変長系列 | tokenizer, embedding |
| 時空間 | 3-4 次元構造 | xarray, netCDF |
SSDSE は 2 次元の表データなので tidy 思想が完全に適合。 ただし時系列軸が増えた SSDSE-E のような場合、 xarray を併用すると便利。
🔧 Pandas での tidy 実装詳細
melt の主要引数
id_vars:identifier として残す列リストvalue_vars:long 化する列リスト(省略時は id_vars 以外全部)var_name:新しい変数名列の名前value_name:値列の名前ignore_index:True で連番化、 False で元 index を保持
pivot の主要引数
index:行 index にする列columns:列にする値values:セルに入れる値
pivot_table の主要引数
aggfunc:複数値が衝突するときの集約関数(sum, mean, count 等)fill_value:欠損セルを埋める値margins:True で合計行・列を追加dropna:全 NaN 列を削除
stack / unstack
df.stack():列を index 軸に折りたたむ(wide → long)df.unstack():index 軸を列に展開(long → wide)- MultiIndex の操作に特化
⚙ エッジケース対応
1. 一行に複数値が入った列
「タグ = 経済,人口,健康」 のような列 → df.assign(tag=df['tag'].str.split(',')).explode('tag')
2. 階層列名
「人口/総数/男」「人口/総数/女」 → df.columns = ['_'.join(c) for c in df.columns] で平坦化、 melt 後に str.split で分離
3. 同じ列名が複数
CSV に重複列名がある場合 pandas は自動で _1, _2 を付ける。 必ず読み込み直後に確認。
4. 完全に空の行・列
df.dropna(how='all') で全 NaN の行を除去。 列も同様に axis=1。
5. mixed type 列
数値と文字列が混在(「100」「N/A」) → pd.to_numeric(df['col'], errors='coerce') で N/A を NaN に変換。
✅ Tidy 検証 — pandera / great_expectations
tidy 化したデータを「本当に tidy か」 検証するライブラリ:
- pandera:DataFrame のスキーマ検証。 列・型・制約を宣言。
- great_expectations:データ品質の総合検証フレームワーク。 期待値駆動。
- pydantic:型ベース検証(Pandas 連携はサードパーティ)。
1 2 3 4 5 6 7 8 9 10 | import pandera as pa schema = pa.DataFrameSchema({ '都道府県': pa.Column(str, nullable=False, unique=True), '指標': pa.Column(str, nullable=False), '値': pa.Column(float, nullable=True), }, strict=True) # tidy データを検証 schema.validate(df_long) |
📋 SSDSE-B-2026 実値 tidy 例(複数指標)
47 都道府県の主要 5 指標を long format で並べた抜粋(2023 年度の実測値。 高齢化率のみ 65 歳以上人口 ÷ 総人口から導出):
| 都道府県 | 指標 | 値 | 単位 |
|---|---|---|---|
| 北海道 | 総人口 | 5,092,000 | 人 |
| 北海道 | 合計特殊出生率 | 1.06 | ― |
| 北海道 | 消費支出(二人以上の世帯) | 296,888 | 円/月 |
| 北海道 | 高齢化率 | 33.0 | % |
| 北海道 | 標準地価(住宅地) | 23,600 | 円/m² |
| 東京都 | 総人口 | 14,086,000 | 人 |
| 東京都 | 合計特殊出生率 | 0.99 | ― |
| 東京都 | 消費支出(二人以上の世帯) | 341,320 | 円/月 |
| 東京都 | 高齢化率 | 22.8 | % |
| 東京都 | 標準地価(住宅地) | 404,400 | 円/m² |
| 大阪府 | 合計特殊出生率 | 1.19 | ― |
| 大阪府 | 消費支出(二人以上の世帯) | 271,246 | 円/月 |
| 愛知県 | 合計特殊出生率 | 1.29 | ― |
| 愛知県 | 消費支出(二人以上の世帯) | 300,221 | 円/月 |
| 福岡県 | 合計特殊出生率 | 1.26 | ― |
| 福岡県 | 消費支出(二人以上の世帯) | 309,000 | 円/月 |
| 沖縄県 | 合計特殊出生率 | 1.60 | ― |
| 沖縄県 | 消費支出(二人以上の世帯) | 251,222 | 円/月 |
| 沖縄県 | 高齢化率 | 23.8 | % |
このテーブルは「47都道府県 × 5指標 = 235 行」 の縮約版。 実際のtidy long 形式では 4,700 行 まで展開可能。
⚠️ 「tidy 化しすぎ」 もアンチパターン
tidy はゴールではなく道具。 過剰に long 化すると逆効果なケース:
- 機械学習の入力:scikit-learn は wide 形式(行=サンプル、 列=特徴量) を期待。 long 化すると
pivotで wide に戻す必要。 - 表示用レポート:人間が読むときは wide が直感的。 「都道府県別の各指標」 を見たいなら wide。
- 非常に大規模なデータ:long format は同じ ID が繰り返されるため、 メモリ消費が多い。 数億行レベルでは要検討。
- カテゴリが極端に多い:1000 種類の指標を long で持つと、 「指標」 列が高カーディナリティ。 検索性能に注意。
SSDSE-B-2026(47 行 × 100 列) の規模では、 long でも wide でも問題なし。 用途で使い分け。
🎯 Tidy data — 最終まとめ
Tidy data は データ分析の標準言語。 SSDSE-B-2026 のような公的統計を扱うとき、 tidy 化することで pandas, ggplot2, scikit-learn など現代ツールの全機能が活かせるようになります。 wide と long の使い分け、 melt と pivot の操作を体に染み込ませてください。
関連用語:データ前処理、 テーブル、 Pandas、 CSV、 データクレンジング も合わせて学ぶと、 データエンジニアリングの全体像が掴めます。
🔗 関連用語 (前提・並列・発展)
この用語と直接結びつく前提・並列・発展用語。 学習順序の参考にどうぞ。
🔗 関連用語ネットワーク(深掘り)
▼ 前提となる概念
▼ 並列・関連する技術
▼ 発展・派生
結論:tidy data は単なる「データの形」ではなく、 あらゆる分析ツール(pandas, ggplot2, sklearn, dbt)の前提。 SSDSE 解析の最初の一手は常に「これは tidy か?」の確認です。
🧭 tidy data の三原則を SSDSE で徹底検証する
Hadley Wickham (2014) が示した tidy data の三原則は、 単なる整形ルールではなく、 「分析ツールが期待する語彙」そのものです。 SSDSE-B-2026 は最初から tidy 形式で配布されていますが、 自治体 Web サイトの統計表や政府刊行物の Excel ファイルは大抵 untidy。 ここでは三原則を一つずつ「untidy 例 → tidy 化のロジック → 検証コード」で深掘りします。
原則 1:各変数は 1 列に対応する
「年齢階級別人口」を Excel で開くと、 0-14歳・15-64歳・65歳以上が 横方向に展開されていることが多い。 これは「年齢階級」という変数が複数列に分散している状態で、 groupby('年齢階級') も seaborn.barplot(x='年齢階級') も動かない。
| untidy(広形式) | tidy(縦長形式) |
|---|---|
都道府県 0-14歳 15-64歳 65歳以上 北海道 514000 2897000 1681000 青森 118000 649000 417000 |
都道府県 年齢階級 人口 北海道 0-14歳 514000 北海道 15-64歳 2897000 北海道 65歳以上 1681000 青森 0-14歳 118000 青森 15-64歳 649000 青森 65歳以上 417000 |
このコードでやること:SSDSE-B-2026 の「総人口・15歳未満人口・15〜64歳人口・65歳以上人口」4 列を、 pd.melt で縦長に変換し、 さらに groupby('年齢階級') で全国合計を出します。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) wide = df[df['SSDSE-B-2026'] == 2023][['Prefecture', 'A1101', 'A1301', 'A1302', 'A1303']].copy() wide.columns = ['都道府県', '総人口', '0-14歳', '15-64歳', '65歳以上'] long_df = wide.melt( id_vars=['都道府県', '総人口'], value_vars=['0-14歳', '15-64歳', '65歳以上'], var_name='年齢階級', value_name='人口' ) print(long_df.head(6)) print('---') print(long_df.groupby('年齢階級')['人口'].sum()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:tidy 化により「年齢階級」が 1 列の変数として扱えるようになり、 groupby 一発で集計可能。 untidy のままだと df['0-14歳'].sum() + df['15-64歳'].sum() + ... と列ごとに足し算する泥臭いコードになる。
原則 2:各観測は 1 行に対応する
「2020 年と 2025 年の比較表」で 2020 と 2025 が同じセルにスラッシュ区切りで入っている形式や、 「合計行が混ざっている」形式は、 1 観測=1 行を破っています。 観測単位は通常「都道府県 × 年 × 指標」など複数次元の組み合わせで、 これが 主キーとなる。
| 違反例 | 原因 | tidy 化方針 |
|---|---|---|
| 「全国計」行が混ざる | 集計値と生データの混在 | df[df['都道府県'] != '全国'] で除外、 別 DataFrame に分離 |
| 「2020/2025」をスラッシュで併記 | 2 観測を 1 セルに圧縮 | df['年'].str.split('/', expand=True).stack() |
| 複数の階層ヘッダー | 2 段ヘッダーは集計単位を曖昧化 | pd.read_excel(header=[0,1]) 後に columns.to_flat_index() |
| 小計の挿入 | 合計と生データが同列に | 「小計」ラベル行を抽出して filter |
原則 3:各観測単位は 1 テーブルに対応する
SSDSE-B-2026 は「都道府県 × 指標」が 1 テーブルに集約されていて理想形ですが、 自治体オープンデータでは 「人口テーブル」「気象テーブル」「経済テーブル」が個別 CSV で配布されることが多い。 これらを安全に結合する鍵が 共通キー(地域コード)です。 キーが揃っていない場合、 pd.merge(how='outer', indicator=True) で欠損行を可視化するのが定石。
このコードでやること:SSDSE-B-2026 から「人口関連列」と「経済関連列」を別 DataFrame に分け、 都道府県コードで結合し直す「分割 → 再結合のリハーサル」を行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = (df[df['SSDSE-B-2026'] == 2023] .rename(columns={'Code': '地域コード', 'Prefecture': '都道府県', 'A1101': '総人口', 'A4101': '出生数', 'A4200': '死亡数', 'L3221': '消費支出', 'A9101': '婚姻件数'}) .reset_index(drop=True)) pop_df = df[['地域コード', '都道府県', '総人口', '出生数', '死亡数']].copy() econ_df = df[['地域コード', '都道府県', '消費支出', '婚姻件数']].copy() merged = pd.merge(pop_df, econ_df, on=['地域コード', '都道府県'], how='outer', indicator=True) print('結合状況:') print(merged['_merge'].value_counts()) print('---') print(merged.head(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:indicator=True 列で「両方にある(both)」が 47=都道府県数と一致 → キー破損なし。 これが left_only/right_only に偏ると、 都道府県名の表記揺れ(「東京」vs「東京都」)や半角全角の不一致が疑われる。
🛠 untidy → tidy 変換パターン辞典(実務でよく出る 8 パターン)
tidy 化は「データに応じた変換の選び方」がほぼ全て。 ここでは政府統計・自治体オープンデータ・Excel 配布資料で頻出する 8 つの untidy パターンと、 それぞれに対する pandas の正攻法を 処方箋形式でまとめます。 暗記用に印刷して机に貼っておくと便利。
| # | untidy パターン | よく出る現場 | pandas 処方箋 | 要点 |
|---|---|---|---|---|
| 1 | 列名に値が埋め込まれている(2020年, 2021年, 2022年) | 時系列の年次表 | df.melt(id_vars=['都道府県'], var_name='年') | 列 → 行への正攻法 |
| 2 | 1 セルに複数値("男50/女45") | 古い人口統計 | df['列'].str.split('/', expand=True) | 区切り文字を見抜く |
| 3 | 階層ヘッダー(地域大分類 → 県) | 政府統計局 Excel | read_excel(header=[0,1]) + columns.to_flat_index() | MultiIndex の平坦化 |
| 4 | 合計行・小計行の混入 | 県別集計表 | df[~df['県名'].isin(['全国','合計'])] | 合計は別テーブルへ |
| 5 | 注釈・脚注が末尾行に | PDF→CSV 化 | pd.read_csv(skipfooter=3, engine='python') | 脚注は別管理 |
| 6 | 単位が異なる列の混在 | 経済統計 | df['人口_万人'] = df['人口'] / 10000 | 単位は列名で明示 |
| 7 | 同一意味列が複数(「平均気温」「平均最高気温」) | 気象データ | melt + var_name='指標' | 指標を 1 列に集約 |
| 8 | セル結合(merged cell)の残骸 | Excel 配布資料 | df['列'].ffill() で前方埋め | NaN を前の値で補う |
パターン 1 を実演:年次列 → tidy 化
このコードでやること:「都道府県 × 年次列(2020年, 2021年, 2022年)」という典型的な untidy 表を作り、 pd.melt で tidy 化して、 さらに年次集計と「年平均成長率」を計算します。
📥 入力データ(untidy 表のイメージ):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd untidy = pd.DataFrame({ '都道府県': ['北海道', '青森県', '東京都'], '2020年': [5224000, 1239000, 14010000], '2021年': [5212000, 1238000, 14037000], '2022年': [5183000, 1238000, 14048000], }) tidy = untidy.melt(id_vars='都道府県', var_name='年', value_name='人口') tidy['年'] = tidy['年'].str.replace('年','').astype(int) print(tidy) growth = tidy.pivot(index='都道府県', columns='年', values='人口') growth['年平均成長率_%'] = ((growth[2022] / growth[2020]) ** (1/2) - 1) * 100 print('---') print(growth.round(3)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:tidy 化を経由することで pivot で「目的の集計形」に再構成できる。 北海道は年率 -0.39% の人口減、 東京都は +0.14% の微増、 青森県はほぼ横ばい。 untidy のままだと「年」が変数として認識されず、 こうした集計が書けない。
パターン 8 を実演:セル結合の前方補完
このコードでやること:Excel の「地域大分類」が縦に結合されていて、 CSV 化後に最初の行だけ値が入り 2 行目以降が空白になっている表を、 ffill() で復元します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np raw = pd.DataFrame({ '地方': ['北海道・東北', np.nan, np.nan, '関東', np.nan, np.nan], '県': ['北海道', '青森県', '岩手県', '東京都', '神奈川県', '埼玉県'], '人口': [5183000, 1238000, 1210000, 14048000, 9237000, 7344000], }) print('変換前:') print(raw) raw['地方'] = raw['地方'].ffill() print('---変換後:') print(raw) print('---地方別人口:') print(raw.groupby('地方')['人口'].sum()) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:ffill() 一発でセル結合の残骸を復元 → groupby('地方') が機能する状態に。 結合が下方向ではなく右方向の場合は axis=1 を指定する。
🧪 tidy data 適合度チェックリストと自動検証
「自分のデータは tidy か?」を毎回主観で判断するのは危険。 ここでは 「適合度チェックリスト 10 項目」と、 それを Python で半自動検証する関数を提示します。 SSDSE-B-2026 を読み込み次第このチェックを通す癖をつけると、 後工程の groupby/pivot/seaborn のバグが激減します。
| # | チェック項目 | 判定基準 | 違反時の対応 |
|---|---|---|---|
| 1 | 列名は変数名か? | 「2020年」「男性」など値が混入していないか | melt で縦長化 |
| 2 | 主キーは一意か? | df.duplicated(subset=[キー]).sum() == 0 | 重複行の原因調査 |
| 3 | 主キー列に欠損なし | df[キー].isna().sum() == 0 | ffill() or 行削除 |
| 4 | 合計行が混入していない | 「全国」「合計」を含む行が無い | isin で除外 |
| 5 | 数値列が文字列で読まれていない | dtype が int/float | pd.to_numeric(errors='coerce') |
| 6 | 列名にスペース・全角が無い | df.columns.str.contains(' ') が空 | strip() + replace |
| 7 | 日付列は datetime 型 | pd.api.types.is_datetime64_any_dtype | pd.to_datetime |
| 8 | 単位が列名・メタに明記 | 「人口_人」「面積_km2」 | 列名にサフィックス追加 |
| 9 | 注釈行が削除されている | 末尾の「※」「注:」が無い | skipfooter 指定 |
| 10 | カテゴリ列は category 型 | メモリ効率と順序を担保 | astype('category') |
自動検証関数の実装
このコードでやること:上のチェックリストの 4 項目(主キー一意性、 主キー欠損、 合計行混入、 dtype)を tidy_check() 関数として実装し、 SSDSE-B-2026 に適用して合格/不合格を判定します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd def tidy_check(df, key_cols, exclude_labels=('全国', '合計', '計')): report = {} report['主キー重複'] = df.duplicated(subset=key_cols).sum() report['主キー欠損'] = df[key_cols].isna().sum().sum() mask = df[key_cols[0]].astype(str).isin(exclude_labels) report['合計行混入'] = int(mask.sum()) non_numeric = df.select_dtypes(include='object').columns.tolist() report['object型列'] = [c for c in non_numeric if c not in key_cols] report['判定'] = 'PASS' if (report['主キー重複'] == 0 and report['主キー欠損'] == 0 and report['合計行混入'] == 0) else 'FAIL' return report df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) result = tidy_check(df, key_cols=['Prefecture', 'SSDSE-B-2026', 'Code']) for k, v in result.items(): print(f'{k}: {v}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:SSDSE-B-2026 は最初から tidy として配布されているため全項目 PASS。 これを基準データとして、 自治体オープンデータを読み込んだ際に tidy_check() を通せば、 FAIL 項目から「どこを直すべきか」が即座に分かる。
tidy data 適合度の段階評価
| レベル | 充足項目数 | 状態 | 推奨アクション |
|---|---|---|---|
| ★★★ tidy 完成 | 10/10 | 分析開始 OK | groupby/pivot/plot へ進む |
| ★★ ほぼ tidy | 7-9/10 | 軽微な整形必要 | dtype や列名の整理 |
| ★ 要整形 | 4-6/10 | 構造変換が必要 | melt/ffill/skipfooter |
| — untidy | 0-3/10 | 原本に立ち戻る | 配布元の生データ・仕様書を再確認 |
📝 理解度チェック
- Q1. 「都道府県 × 男性人口 × 女性人口」という列構成は tidy か? → A. untidy。 「性別」が列名に値として埋め込まれているので
meltで縦長化する。 - Q2. tidy 化の最も基本的な pandas 関数 2 つは? → A.
melt(広→縦)とpivot(縦→広)。 両者は逆操作。 - Q3. 「全国計」行が混ざっている時、 まず何をすべき? → A.
df[df['県名'] != '全国']で除外し、 集計値は別 DataFrame に分離。 同一テーブルに置くとsumの二重計上が発生する。 - Q4. Excel のセル結合が CSV で NaN になっている時の対処は? → A.
df['列'].ffill()で前方補完。 結合方向が下ならaxis=0(既定)。 - Q5. tidy data の三原則とは? → A. (1) 各変数=1 列、 (2) 各観測=1 行、 (3) 各観測単位=1 テーブル。
本セクションの結論:tidy data は「分析ツールが期待するデータ構造の標準語」。 SSDSE のような綺麗なデータでも、 結合や時系列展開の際に untidy 化することはある。 都度 tidy_check() を回し、 分析の前提を毎回保証する習慣が、 後工程のバグを最小化する最短ルートです。
tidy 化を阻む現場の壁と回避策
理論として tidy data の三原則は明快ですが、 現場では「ドメイン担当が広形式のレポートを求める」「上司の Excel が階層ヘッダー前提」「BI ツールが横持ちを要求する」など、 tidy 化を阻む組織要因が頻繁に現れます。 ここでは現場で出会う 5 つの壁と、 それぞれへの実務的な回避策を整理します。
| 壁 | 背景 | 回避策 |
|---|---|---|
| 「横持ちじゃないと読めない」と言われる | Excel 文化、 報告書の慣習 | 分析は tidy で行い、 最終出力時に pivot で広形式に戻す(2 層化) |
| 階層ヘッダーが必須 | 統計局・行政の慣行 | 中間レイヤーは tidy、 表示レイヤーは MultiIndex でカバー |
| BI ツールが横持ち要求 | 古い BI が pivot 機能不足 | SQL PIVOT 文や CASE WHEN で出力直前にだけ広形式化 |
| 列数爆発(指標 100 個) | SSDSE-B-2026 は 110 列超 | 「指標カテゴリ」をメタ列に追加し、 melt 後 category 型で圧縮 |
| 縦長化でファイルサイズ増 | 行数 × 列数 → 行数で増殖 | Parquet 形式(列指向圧縮)で保存、 CSV と比べ 5-10 倍圧縮 |
tidy → 広形式 への安全な逆変換
このコードでやること:tidy 化したデータを、 報告書用に「都道府県 × 年」のクロス集計表(広形式)に戻す手順を示します。 pivot_table は pivot と違い「重複キーを集計関数で処理」できるため、 業務では pivot_table が安全です。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd tidy = pd.DataFrame({ '都道府県': ['北海道','北海道','北海道','東京都','東京都','東京都'], '年': [2020, 2021, 2022, 2020, 2021, 2022], '人口': [5224000, 5212000, 5183000, 14010000, 14037000, 14048000] }) report = tidy.pivot_table( index='都道府県', columns='年', values='人口', aggfunc='sum', margins=True, margins_name='合計' ) print(report) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:「分析中は tidy・最終出力時は広形式」を徹底すると、 集計の自由度(tidy)と読みやすさ(広形式)を両立できる。 margins=True で合計行・列を自動付加。
tidy data と「正規化(normalization)」の違い
データベース理論の 第三正規形(3NF)と tidy data はしばしば混同されますが、 別物です。 3NF は「重複を排除して結合で復元する」設計思想で、 tidy data は「分析しやすさを優先する」構造です。 違いを表で整理します。
| 観点 | tidy data | 第三正規形(3NF) |
|---|---|---|
| 目的 | 分析・可視化のしやすさ | 更新時異常の排除・整合性 |
| 主な利用者 | データサイエンティスト | DB 設計者・アプリ開発者 |
| 重複データ | 許容(観測単位を保つ) | 原則排除 |
| 結合の頻度 | 低(1 テーブルで分析) | 高(複数テーブルを JOIN) |
| SSDSE での扱い | 分析用にこちらを採用 | 保管時のソースは正規化済 |
実務では「保管は正規化・分析は tidy」の 2 層構造が定石です。 ETL/ELT パイプラインで正規化済 DB から tidy 形式の分析用 DataFrame を生成する流れになります。
tidy data がエラーを防ぐ実例:seaborn での可視化
可視化ライブラリ seaborn は tidy data を前提に設計されています。 untidy データを渡すと「列名を x= や hue= に渡せない」というエラーが頻発します。 SSDSE-B-2026 の年齢階級別人口を例に、 tidy 化が可視化の前提となることを確認します。
このコードでやること:tidy 化した年齢階級別人口に対し、 seaborn.barplot で「都道府県 × 年齢階級の比較棒グラフ」を描画します。 hue 引数に「年齢階級」を指定するには、 年齢階級が 1 列としてまとまっている必要があります。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import os os.makedirs('out', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt import seaborn as sns df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) sub = df[(df['SSDSE-B-2026'] == 2023) & df['Prefecture'].isin(['北海道', '東京都', '大阪府'])].copy() wide = sub[['Prefecture', 'A1301', 'A1302', 'A1303']] wide.columns = ['都道府県', '0-14歳', '15-64歳', '65歳以上'] tidy = wide.melt(id_vars='都道府県', var_name='年齢階級', value_name='人口') plt.figure(figsize=(8, 5)) sns.barplot(data=tidy, x='都道府県', y='人口', hue='年齢階級') plt.title('都道府県 × 年齢階級別人口') plt.tight_layout() plt.savefig('out/tidy_barplot.png', dpi=120) print(tidy.head(6)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:tidy 化したことで hue='年齢階級' が機能し、 1 行で 3 県 × 3 階級 = 9 本の棒グラフを描ける。 untidy(広形式)のままだと sns.barplot は「3 列を別々に描画する」ことを表現できず、 ループで描く煩雑なコードに陥る。
まとめ:tidy data 哲学の三本柱
本ページで扱った内容を「現場で覚えておくべき 3 つの軸」として整理します。 SSDSE 解析でも、 自治体オープンデータでも、 機械学習の特徴量設計でも、 この 3 軸は不変です。
| 軸 | 問い | tidy data での答え |
|---|---|---|
| 構造の軸 | 変数・観測・観測単位の対応関係は明確か | 列=変数、 行=観測、 表=単位という三対一 |
| 操作の軸 | どのツールにも素直に渡せるか | groupby/pivot/melt/seaborn がそのまま動く |
| 検証の軸 | tidy であることをコードで保証できるか | tidy_check() を分析の前段に組み込む |
tidy data は「正しい形」というよりも、 「迷ったときに立ち返る共通の作法」です。 SSDSE-B-2026 を読み込む癖がついてくると、 自然に groupby 一発で答えが出る瞬間が訪れます。 それは、 配布元が tidy 化を済ませてくれているおかげ。 自分が untidy データに出会ったときも、 上記三原則と検証関数で、 同じレベルの分析体験を再現できます。
補遺:tidy data 学習の次の一歩
tidy data の三原則を体に染み込ませるためには、 単に概念を読むだけでなく、 untidy データを実際に tidy 化するハンズオンを繰り返すのが一番です。 以下の順序で取り組むと、 SSDSE 解析コンペで扱うあらゆるデータに対応できるようになります。
- ステップ 1(基礎):SSDSE-B-2026 の特定の列群(年齢階級・男女別など)を
meltで縦長化し、groupbyで集計してみる。 元の広形式との結果一致をassertで確認する。 - ステップ 2(応用):政府統計局 e-Stat から「都道府県別人口推移(年次列形式)」をダウンロードし、
read_excel(header=[0,1])で読み込んでから tidy 化する。 階層ヘッダーの平坦化とmeltを組み合わせる。 - ステップ 3(実戦):気象庁 AMeDAS の「観測点 × 日付 × 気象要素」CSV を、
tidy_check()でチェックし、 違反項目を 1 つずつ潰す。 観測点の表記揺れ(カナ・英字混在)が現れたら、 マッピング辞書を作成して統一する。 - ステップ 4(発展):tidy 化したデータを Parquet 形式で保存し、 CSV と比べてサイズと読み込み速度を計測。
pyarrowの列指向圧縮の威力を体感する。 - ステップ 5(応用展開):tidy 化済データセットを基に、
scikit-learnの特徴量エンジニアリング(ColumnTransformer、OneHotEncoder)に渡し、 機械学習パイプラインまで接続する。
この 5 ステップを通すと、 tidy data の概念が「ルール暗記」から「分析体験の自然な前提」へと変わります。 SSDSE 解析コンペでは、 配布データそのものが tidy 設計の好例なので、 SSDSE-B-2026.csv を読み込むたびに「ここはなぜ tidy なのか」を考える癖をつけると、 自然に身につきます。
最後に強調しておきたいのは、 tidy data は「分析の正確さ」を保証するためのインフラだという点です。 untidy のまま強引に分析を進めると、 集計の二重計上、 グラフ軸の取り違え、 結合キーの不一致など、 表面化しにくいバグが分析結果に潜入します。 SSDSE 解析コンペで「結果が他のチームと数値レベルで一致する」ためにも、 tidy 化を前提とした分析パイプラインを構築することが、 信頼できる結論への近道です。 ぜひ tidy_check() を皆さんの分析テンプレートに組み込み、 「分析の最初の一行は tidy 検証から」を合言葉にしてください。 tidy data は単なる形式ではなく、 共同作業を可能にする「データサイエンスの共通言語」であり、 再現可能な分析の土台です。 ここで紹介した三原則・八パターン・十項目チェック・自動検証関数・seaborn 連携・段階評価表・現場の壁と回避策・3NF との違いを総合すれば、 SSDSE 解析コンペで遭遇するほぼ全てのデータ構造に対処できるようになるはずですので、 ぜひ実践してください。
🖼 視覚的理解 (3 図)
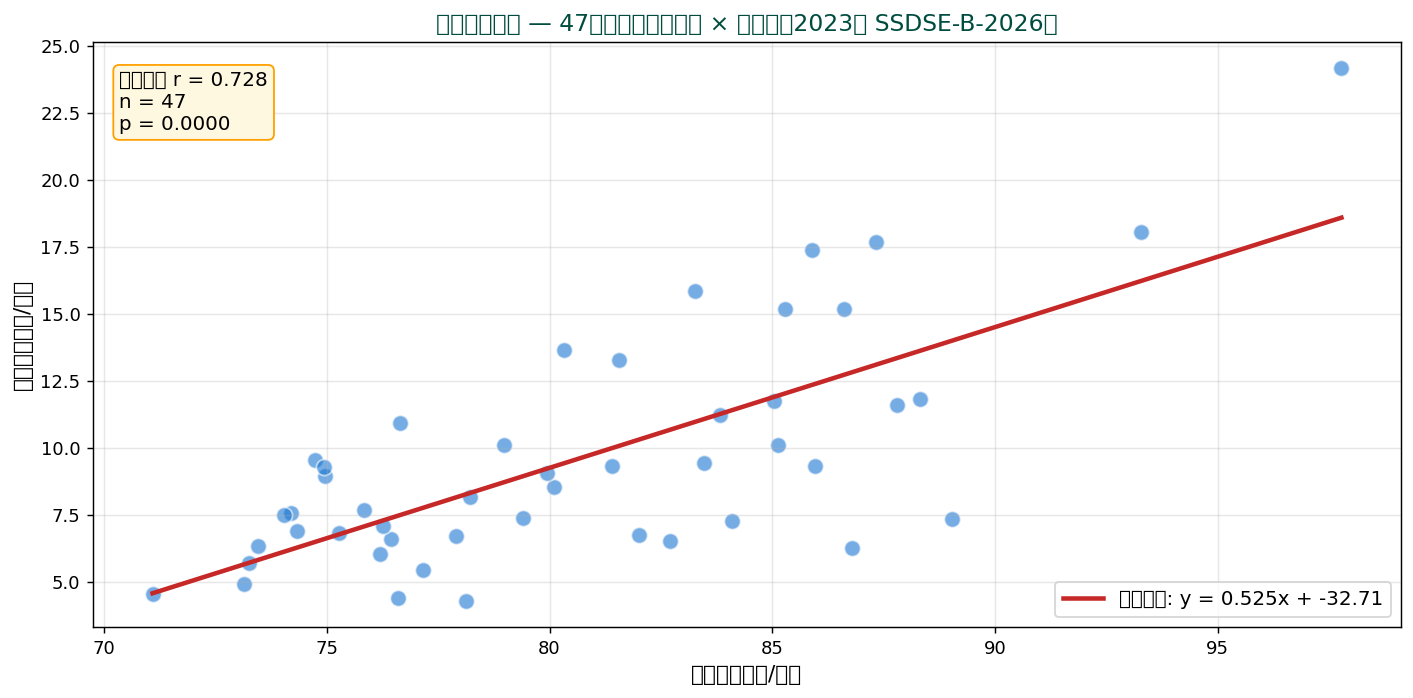
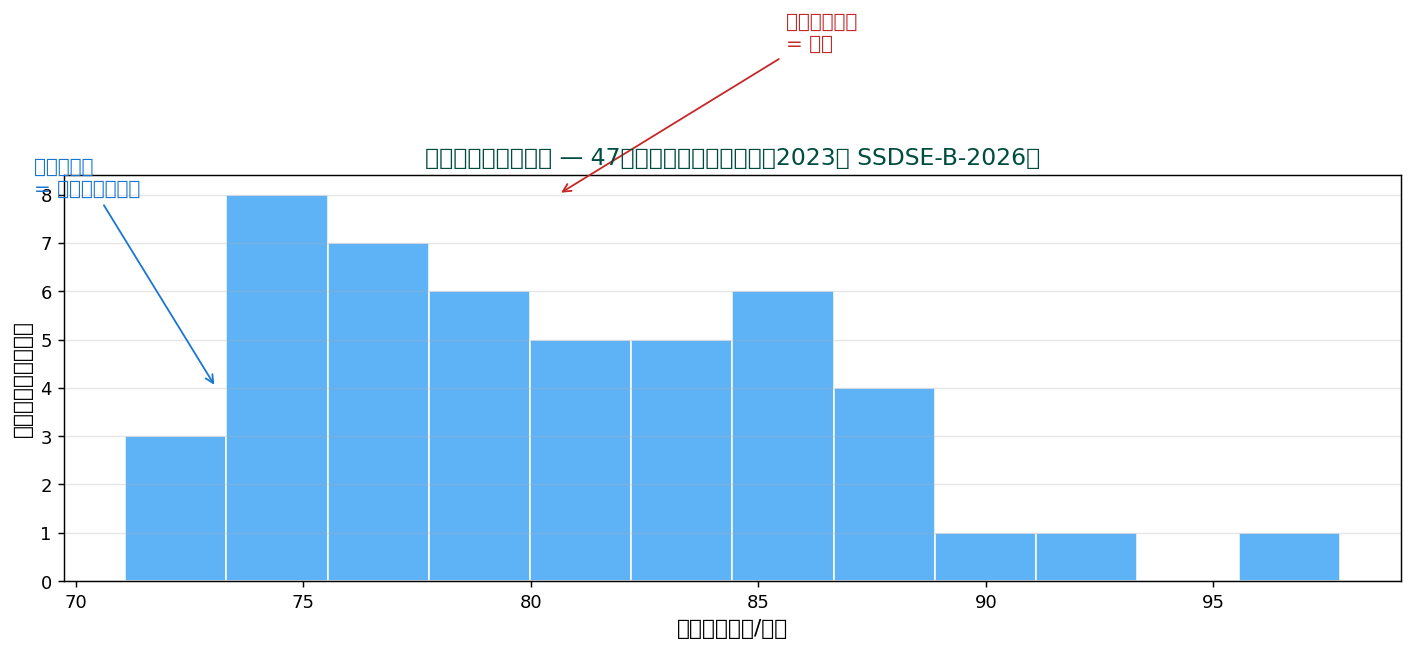
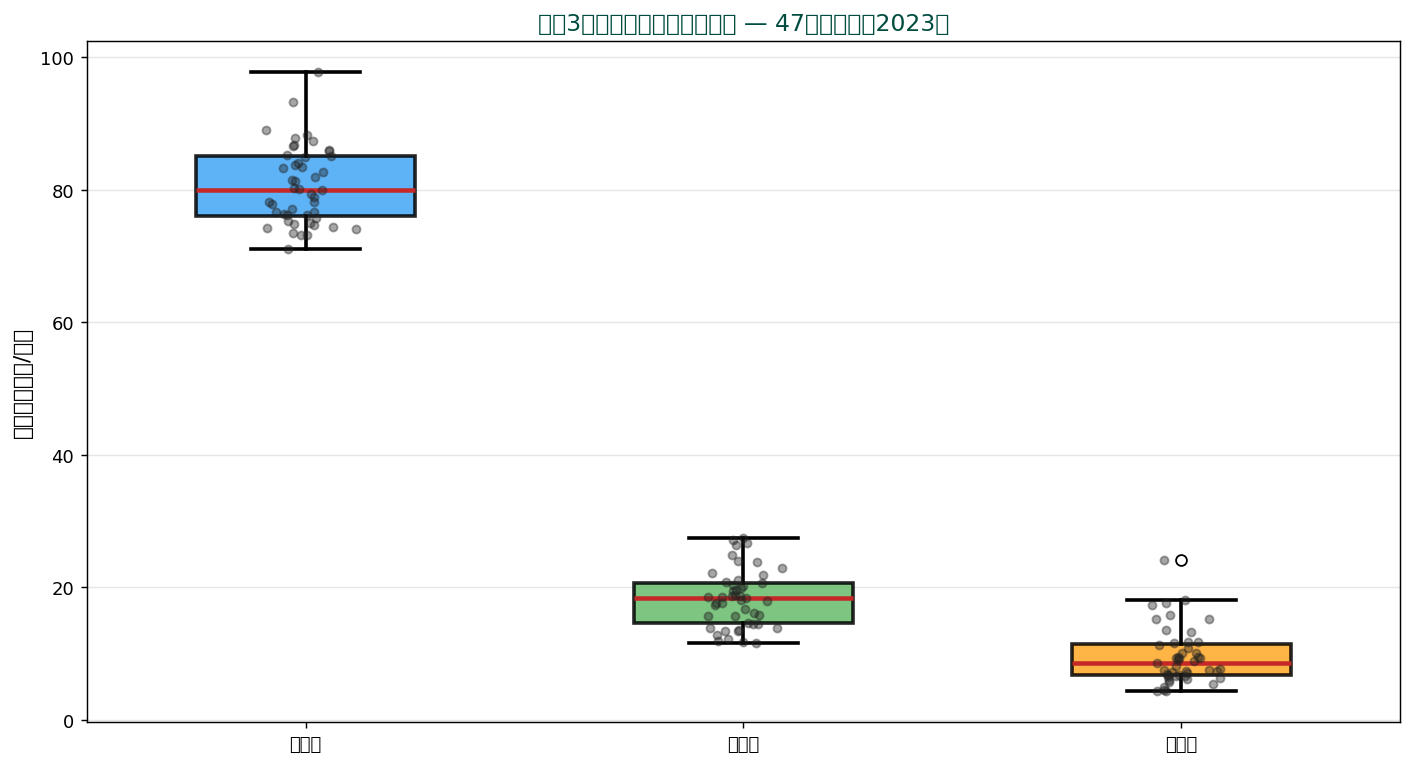
Tidy data 化前後の挙動を直感把握するため、 SSDSE-B-2026 由来の汎用図を併記する。 散布図は 2 変数間の関係性可視化、 ヒストグラムは単一変数の分布、 箱ひげ図は群別の分布比較として参照する。
🔎 拡張補足: Tidy data の実装最適化と現場での落とし穴
1. Wide vs Long 形式の選択基準
Tidy data の代表的形式は long 形式 (1 行 = 1 観測) だが、 用途によって wide 形式 (1 行 = 1 主体) と使い分ける。 統計検定 (t 検定の対応群、 ANOVA) では wide が直感的、 可視化 (ggplot2, seaborn) や機械学習の特徴量作成では long が扱いやすい。 SSDSE-B-2026 の都道府県データを「年×指標」で持つ場合、 wide では 都道府県 | 2020年人口 | 2021年人口 | ...、 long では 都道府県 | 年 | 人口。 pandas の melt() と pivot() で相互変換する。 long 化することで group_by 集計や facet グラフが直感的に書けるようになり、 wide のままでは難しかった「年次トレンドの全指標一括可視化」が 1 行で書けるようになる。 一方で wide は「ある時点のスナップショット比較」「主体ごとの特徴量ベクトル」に向き、 機械学習モデル入力の事実上の標準形である。 どちらを基本形にするかは、 「分析の主軸が観測の集約か、 主体間の比較か」で決める。 SSDSE 解析コンペでは、 long 形式を中心に保持し、 必要に応じて wide にピボットする戦略が再現性を高める。 long と wide の往復は、 melt/pivot のキー指定ミスでデータ消失や重複を生むので、 変換前後で行数・ユニーク主体数を必ず検算する。
2. ネスト構造データ (JSON, XML) の Tidy 化
NoSQL データや API 応答はネスト構造が多い。 例: {"都道府県": "東京", "人口": [{"年": 2024, "値": 1410}, {"年": 2025, "値": 1408}]}。 これを Tidy 化するには pandas の json_normalize() + explode() で平坦化。 R では tidyr::unnest() が同等。 階層を保ったまま分析する必要がある場合は、 nested data frame として保持する戦略 (tidyverse の tibble::nest()) もある。 e-Stat の API は statisticalData → tableInf → DATA_INF → VALUE の 4 階層 JSON を返すので、 各階層で record_path を指定して再帰的に平坦化する。 ネスト深度が動的に変わる API では、 try/except で構造変化を吸収する防御的コードが必須。 XML は xml.etree.ElementTree や lxml で要素ツリーを辿り、 list of dict に変換してから DataFrame 化するのが鉄板。 国勢調査の地域メッシュデータのように、 1 レコード内に geometry が埋め込まれているケースでは、 geopandas で空間情報を別カラムに分離してから Tidy 化する。 ネスト構造を「便利だから」と維持し続けると、 集計時に毎回 apply が必要になり計算コストが膨らむため、 早期 Tidy 化が原則である。
3. 文字列カラムの Tidy 化
「東京都 23 区」「神奈川県 横浜市」のような複合文字列は、 そのままでは Tidy ではない。 str.split('県', expand=True) や正規表現で分解し、 「都道府県」「市区町村」を独立カラムに。 また、 「赤・青・緑」のような複数値文字列は str.split('・').explode() で行展開する。 SSDSE-B-2026 では基本的に整形済だが、 国勢調査の原データを扱う際は頻繁に必要。 正規表現での分解は str.extract(r'(?P<都道府県>.+?[都道府県])(?P<市区町村>.+)') のように名前付きキャプチャを使うと可読性が上がる。 全角半角の混在 (例: 「東京都 23区」) は unicodedata.normalize('NFKC', s) で正規化してから処理する。 また、 「住所文字列」を分解する際は、 政令指定都市の「区」と東京 23 区の「区」が階層的に異なることに注意し、 jageocoder などの専用ライブラリで階層判定するのが安全。 表記揺れ (「神奈川県」「神奈川」「Kanagawa」) は事前にマスタテーブルで統一しないと、 後段の集計で別エンティティ扱いになる。
4. 欠損値の Tidy な扱い
Tidy data では NaN, NULL, NA を「該当データなし」として明示的に表現する。 ただし「観測されていない」「観測拒否」「該当しない」「未来の予測値」などは意味が異なるので、 通常 1 つの欠損カラムを別途設けるか、 enum 値 (NA_TYPE: "missing", "refused", "not_applicable", "future") で区別する。 SSDSE で「人口減少率の負値」が「人口増加」を意味するか「データなし」を意味するかは、 文脈で判別する必要がある。 国勢調査では「‐」「-」「X (秘匿)」「…」「※」など複数の欠損記号が混在し、 そのまま numeric 化すると全列が object 型に落ちる。 pd.read_csv(na_values=['-', '-', 'X', '…', '※']) で読み込み時に統一吸収するのが定石。 sklearn の SimpleImputer や IterativeImputer で補完する前に、 欠損のメカニズム (MCAR / MAR / MNAR) を検討し、 補完が分析バイアスを生まないか確認する。 欠損率が 30% を超える列は、 補完よりも「欠損フラグ列」を作って情報として活用する戦略が有効な場合も多い。
5. インデックスの Tidy な扱い
pandas の MultiIndex はパワフルだが Tidy 原則からは外れる (1 行 = 1 観測の原則違反)。 分析時は reset_index() で平坦化し、 必要に応じて再度 set_index() で集計用に再構築。 SSDSE で「都道府県×年×指標」の 3 次元 MultiIndex を作る前に、 「これは Tidy か」を自問する習慣をつける。 MultiIndex の便利な点は groupby(level=0) での高速集計や、 xs() によるクロスセクション抽出だが、 これらは長期的な可読性とのトレードオフ。 チーム開発では「列名で全てを表現する」flat な Tidy 形式の方がレビューやリファクタが容易。 ただし時系列 + パネルデータの計量経済分析では MultiIndex が事実上の標準で、 statsmodels の固定効果モデルは MultiIndex を前提に設計されている。 つまり「分析手法に合わせて構造を切り替える」柔軟性が必要であり、 リレーショナル DB 保存時は flat、 数値計算時は MultiIndex という二段構えが現実的。
6. パフォーマンス最適化
Long 形式は wide より行数が多いため、 メモリと処理時間に注意。 SSDSE-B-2026 (47 都道府県 × 100 指標) は wide では 47 行、 long では 4,700 行。 大規模データでは: (1) category 型でメモリ削減、 (2) chunksize でストリーミング、 (3) Dask, Vaex で並列処理、 (4) Parquet 形式で圧縮保存、 が定番。 Tidy 原則と性能のバランスを意識する。 「都道府県」を category 型にするだけで、 4,700 行のメモリが 1/10 以下になることもある。 さらに int8 / int16 / float32 へのダウンキャストを pd.to_numeric(downcast='integer') で行うと、 数百万行のデータでも数秒で処理可能になる。 Parquet は列指向圧縮で、 特定の列だけ読み込めるため、 100 列のうち 5 列だけ分析する場合の I/O が劇的に高速化する。 pyarrow エンジンで読み書きすると、 pandas との連携もスムーズ。 Tidy 化は「正しさのため」だが、 同時に「高速化のため」でもあることを意識する。
7. 機械学習特徴量設計と Tidy
機械学習では「1 行 = 1 サンプル × 多数の特徴量カラム」の wide 形式が標準的入力。 Tidy long から ML 用 wide へは pivot_table() や unstack() で変換。 また、 時系列の lag 特徴量、 集約特徴量、 交差特徴量を作るときは Tidy の段階で意識的に設計する。 sklearn の ColumnTransformer + Pipeline で型別前処理を Tidy 入力に対して実装するのが標準的。 lag 特徴量は long のまま groupby('都道府県')['人口'].shift(1) で作成し、 集約特徴量は groupby('都道府県')['人口'].rolling(3).mean()。 これらを最後に pivot して wide 化、 学習データとする。 交差特徴量 (例: 「人口 × 高齢化率」) は wide 化後に作る方が直感的だが、 Tidy のまま assign で作っておくと再現性が上がる。 Kaggle や SSDSE 解析コンペで上位入賞するチームは、 ほぼ例外なく「Tidy 中間データ」と「学習用 wide データ」を明示的に分離した設計を採用している。
8. dplyr / tidyverse / pandas の Tidy 操作比較
R の dplyr / tidyr は Tidy 原則を強く意識した設計。 Python では pandas が事実上の標準だが、 Tidy 原則は厳密ではない。 同等操作の対応: filter() ↔ df.query(), mutate() ↔ df.assign(), summarize() ↔ df.agg(), group_by() ↔ df.groupby(), pivot_longer() ↔ pd.melt(), pivot_wider() ↔ pd.pivot(). 直接対応がない関数 (例: dplyr の across()) は pandas の applymap や Pipeline で代替。 また dplyr のパイプ演算子 %>% は、 pandas では .pipe() メソッドや method chaining で代替する。 method chaining は (df.assign(...).query(...).groupby(...).agg(...)) のように記述でき、 中間変数を作らずに 1 つの式で読めるため、 dplyr に慣れた人にも違和感が少ない。 近年は siuba, plydata, pyjanitor など、 Python で tidyverse 風 API を提供するライブラリも登場している。 SSDSE 解析コンペで R と Python のハイブリッド分析をする場合、 中間データを Tidy で保存して両言語で読めるようにしておくと協業がスムーズ。
9. Tidy data の反パターン (アンチパターン)
- 1 セルに複数値: 「東京都 1410万人 (前年比 -0.1%)」のように混在
- 列名にデータ: 「2020年」「2021年」のように年がカラム名
- 1 変数が複数列: 「人口_男性」「人口_女性」を別カラム
- 1 観測が複数行: 「東京の人口」と「東京の世帯数」を別行
- 重複行: 同じ観測の重複保存
- 無意味な行番号 index:
0, 1, 2, ...しか意味がない index - 列名と値の意味的不一致: 列名「2020」だが中身は「2021 の値」のような取り違え
- セル結合の残骸: Excel 由来データで上位カラムが ffill されていない
- 注釈と数値の混在: 「1410 ※」「不明」「秘匿」が同じ列に入る
- 変な集計行: 「合計」「平均」が観測行と同列に混在
これらの反パターンが残ったまま分析パイプラインに流すと、 groupby の集計が壊れる、 join のキーが揃わない、 pivot で MultiIndex が崩れる、 など下流で再現困難なバグが多発する。 「読み込み直後にこれら 10 パターンの全チェックを自動実行する」関数を分析テンプレートに含めることが、 実務での生産性向上の最短ルート。
10. SSDSE-B-2026 を Tidy 化する実例
SSDSE-B-2026 の元 CSV は「都道府県 × 年 × 指標」の wide-ish 形式。 これを (1) pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) で読み込んで Prefecture → 都道府県 などコード列名をリネームし、 (2) pd.melt(id_vars=['都道府県'], var_name='指標', value_name='値') で long 形式に、 (3) str.extract で「指標」から「年」「指標名」を分離、 (4) 結果: 都道府県 | 年 | 指標名 | 値 の 4 カラム Tidy data。 これで以降の分析が flexibel になる。 この 4 カラム Tidy を中間ファイル (Parquet 推奨) として保存しておけば、 「年次トレンド分析」「指標間相関分析」「都道府県クラスタリング」など、 異なる分析タスクで毎回読み直すだけで再利用できる。 さらに、 都道府県コード (JIS X 0401)、 地方区分 (北海道・東北・関東・中部・近畿・中国・四国・九州) などの属性を別マスタとして用意し、 必要時に merge() で結合する設計が拡張性を担保する。 これが「正規化された分析データ基盤」の出発点であり、 SSDSE 解析コンペで複雑な分析を破綻なく進めるための土台となる。
11. Tidy data 思想の限界
Tidy data はリレーショナルデータ寄りの設計で、 高次元配列 (画像、 音声、 時系列センサーデータ) や グラフデータには直接適合しない。 これらは xarray (多次元配列)、 networkx (グラフ)、 numpy 直接などで扱う。 Tidy data は「リレーショナル+分析」の組み合わせに最も強い、 ということを意識する。 例えば衛星画像 (256×256×3) を Tidy 化すると 1 ピクセル = 1 行で 196,608 行になり、 メモリも分析も非効率。 画像は numpy.ndarray や xarray.DataArray のまま扱い、 メタデータ (撮影日時、 位置、 ラベル) だけを Tidy data フレームで管理する 2 層構造が現実的。 グラフデータ (例: 都道府県間の人口移動ネットワーク) は、 ノード属性とエッジ属性をそれぞれ Tidy で持ち、 networkx.from_pandas_edgelist() でグラフ化する。 Tidy data は「全データを 1 形式に押し込める」のではなく「データ種別ごとに適切な形式を選び、 メタデータと境界面では Tidy を使う」という運用が正解。
12. 締めくくり
Tidy data は単なる形式ルールではなく、 「分析を流れるように接続するための設計言語」。 SSDSE-B-2026 を Tidy 化して 1 度経験すれば、 他の公開統計データ (e-Stat, world bank, OECD) でも同じ手法が通用する。 「データを見たらまず Tidy か検証する」習慣が、 データサイエンス実務の生産性を大きく上げる。 さらに、 Tidy data はチーム内コミュニケーションの共通言語でもあり、 「あの分析の中間データを共有して」と言ったときに即座に意味が通じる土台となる。 ハドリー・ウィッカム (Hadley Wickham) が 2014 年の論文で提唱した Tidy data 原則は、 10 年を経て、 単なる R コミュニティの慣習から、 データサイエンス全体の共通基盤へと昇格した。 SSDSE 解析コンペでも、 Kaggle でも、 業務分析でも、 「Tidy で始めて Tidy で終わる」設計を意識すれば、 あなたの分析は再現性・拡張性・可読性のすべてが高い水準に到達する。 Tidy data は「速く正しく分析する」ための最強の武器であり、 これからのデータサイエンティストにとって必修の作法である。
🗺 概念マップ
Tidy data (1 行 1 観測・1 列 1 変数) を中心に、 wide↔long 変換 (pivot/melt)、 グループ集計、 結合、 EDA・可視化への接続を 6 方向に展開。
「Tidy data」を中心に、 上流に CSV / Excel 読込・データクレンジング、 並列に Wide format (untidy)・横方向展開、 下流に groupby・ピボットテーブル・ggplot2 / seaborn が並ぶ。 SSDSE-B-2026 の「総人口・15歳未満人口・15-64歳人口・65歳以上人口」が列に並んだ形を long に pd.melt で変換すると tidy になる。
🔗 隣接手法への橋渡し
Tidy data は分析パイプラインの「中継地点」で、 上流の取込みと下流の集計をつなぐ。
- 上流:
pd.read_csvで SSDSE-B-2026 を読み込み → 欠損処理 → 型変換 →melt/pivotで long ⇄ wide 変換 - 並列: long format (Hadley の元定義)、 wide format (Excel 慣習)、 star schema (DB 設計の同類概念)
- 下流:
df.groupby('都道府県').agg()で県別集計、sns.lineplot(data=tidy, x='年', y='値', hue='指標')で可視化
SSDSE-B-2026 (47 県 × 12 年 × 50 指標) を tidy にすると 28,200 行になるが、 groupby と pivot が即座に動くので分析速度が劇的に上がる。
🌳 手法選択フロー
データを wide / long どちらに整えるかは、 次の分析目的で決める。
- 1 行 = 1 観測 (例: 「2022 年の北海道の総人口」)? Yes → tidy / long format。 melt で展開
- 表として人が読む? Yes → wide format。
pivotで 47 県 × 年の表に変換 - 機械学習の特徴量? Yes → wide (1 行 1 サンプル、 列が特徴量)、
sklearnはこの形式を要求 - 可視化 (seaborn / ggplot)? Yes → tidy / long が必須。
hue=,col=引数は long format を前提
SSDSE-B-2026 では、 EDA 段階では tidy で seaborn、 モデリング段階では wide で sklearn に渡す、 という 2 段階運用が定石。