🔖 キーワード索引
🔖 キーワード索引(拡張)
欠損値 はデータ表で値が記録されなかったセル (NaN, NULL)。 SSDSE-B-2026 では一部の県・年で値が欠落することがあり、 その扱いがモデル結果を左右する。 単純削除・平均代入・多重代入 (MICE) ・モデルベース代入と段階的に洗練される。
「欠損機構の分類 → 単純代入 → 多重代入」 が欠損値処理の骨格。
💡 30秒で分かる結論
🍰 まずはやさしく
データの中にある空白のことです。
正しい分析結果を出すために使います。
アンケートの未回答欄のようなものです。
欠損値の種類と直し方を学びます。
- 定義:値が記録されなかった/欠けたセル。pandasではNaN。除外(dropna)or 補完(fillna)で対処。
- カテゴリ:データ前処理
📖 もっと詳しく
欠損値(missing value, NaN)は、 値が記録されていないセル。 pandas では NaN(Not a Number)と表示されます。 SSDSE の実データでも、 一部の指標・年度では欠損があります。
欠損のメカニズム(Rubin の分類):
- MCAR(Missing Completely At Random):完全にランダムに欠損。 dropna でも問題なし
- MAR(Missing At Random):他の観測変数と関連するが、 結果変数とは無関係。 適切に補完すれば対処可能
- MNAR(Missing Not At Random):結果と関連して欠損(例:高所得者ほど所得を回答しない)。 最も厄介
対処:(i) dropna(行削除)— 簡単だが情報を失う、 MNAR ではバイアス、 (ii) 平均値補完 — 分散を過小評価、 (iii) KNN 補完、 (iv) 多重代入法(multiple imputation) — 現代的なベストプラクティス。
📍 あなたが今見ているもの
🍰 まずはやさしく
データが抜けている状態のことです。
分析の準備を整えるために使います。
スマホの記録に空きがある状態です。
定義から具体的な方法までを読みます。
論文中に 「欠損値」として登場する用語。
欠損値 とは:値が記録されなかった/欠けたセル。pandasではNaN。除外(dropna)or 補完(fillna)で対処。
本ページでは「missing value」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「missing value」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — 欠損値は「白い穴」と「色付きの穴」
🍰 まずはやさしく
データにある穴のようなものです。
穴にどんな意味があるか考えます。
部活の出席簿に空欄がある状態です。
穴の埋め方による違いを考えます。
SSDSE-B-2026 を表計算ソフトで開いたとき、 たまにある「空白セル」や「-」が欠損値です。 重要なのは、 欠損には「白い穴(完全ランダム MCAR)」と「色付きの穴(パターンを持つ MAR/MNAR)」がある、 という直感。 たとえば「都道府県別の医師数」が中山間地ほど欠損していれば、 それは MNAR で、 単純に平均で埋めると医療資源の地域格差を見落とします。
「とりあえず fillna(0)」は最悪手の代表。 SSDSE で 47 県の出生率を、 欠損 3 県だけ 0 で埋めれば、 全国平均が一気に下がってしまいます。 平均で埋めると「分布が痩せる」、 0 で埋めると「ヒストグラムに棘が生える」。 多重代入法は「ありえそうな値を複数生成して、 不確実性ごと推定する」現代の正解です。
🎨 概念図で押さえる — 欠損値の3つの視点
欠損値の理解には、 (1) 分布の偏り(欠損が起きやすい区間)、 (2) 変数間の関係(欠損が他変数と相関するか)、 (3) 残差プロット(補完後の予測誤差) の 3 点を同時に把握する必要があります。 ここでは html/glossary/figures/ にある既存図を借りて、 欠損値処理のキャンバスを描き出します。
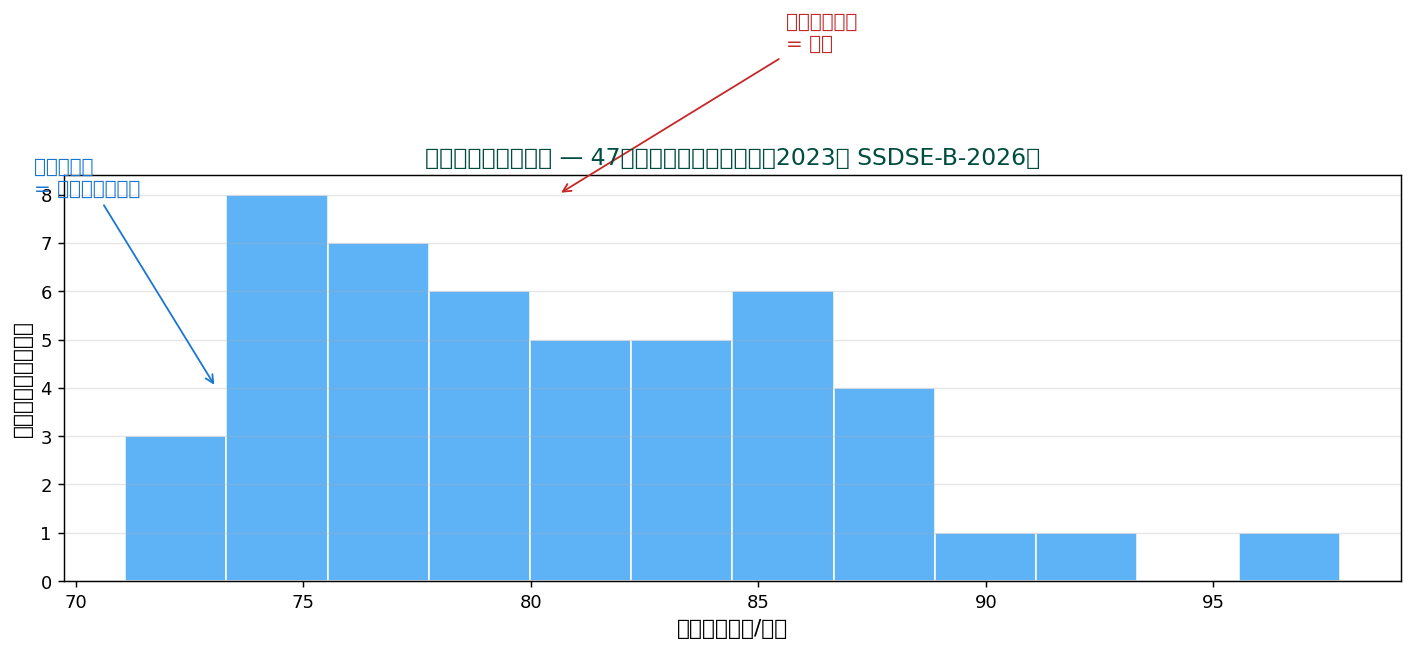
読み取るポイント:
- 欠損が裾に集中する → MNAR、 多重代入や感度分析が必須
- 欠損が中央付近にランダム → MCAR の可能性、 単純代入でも誤りは小さい
- 分布が二峰なら、 モードごとに条件付き平均で代入する
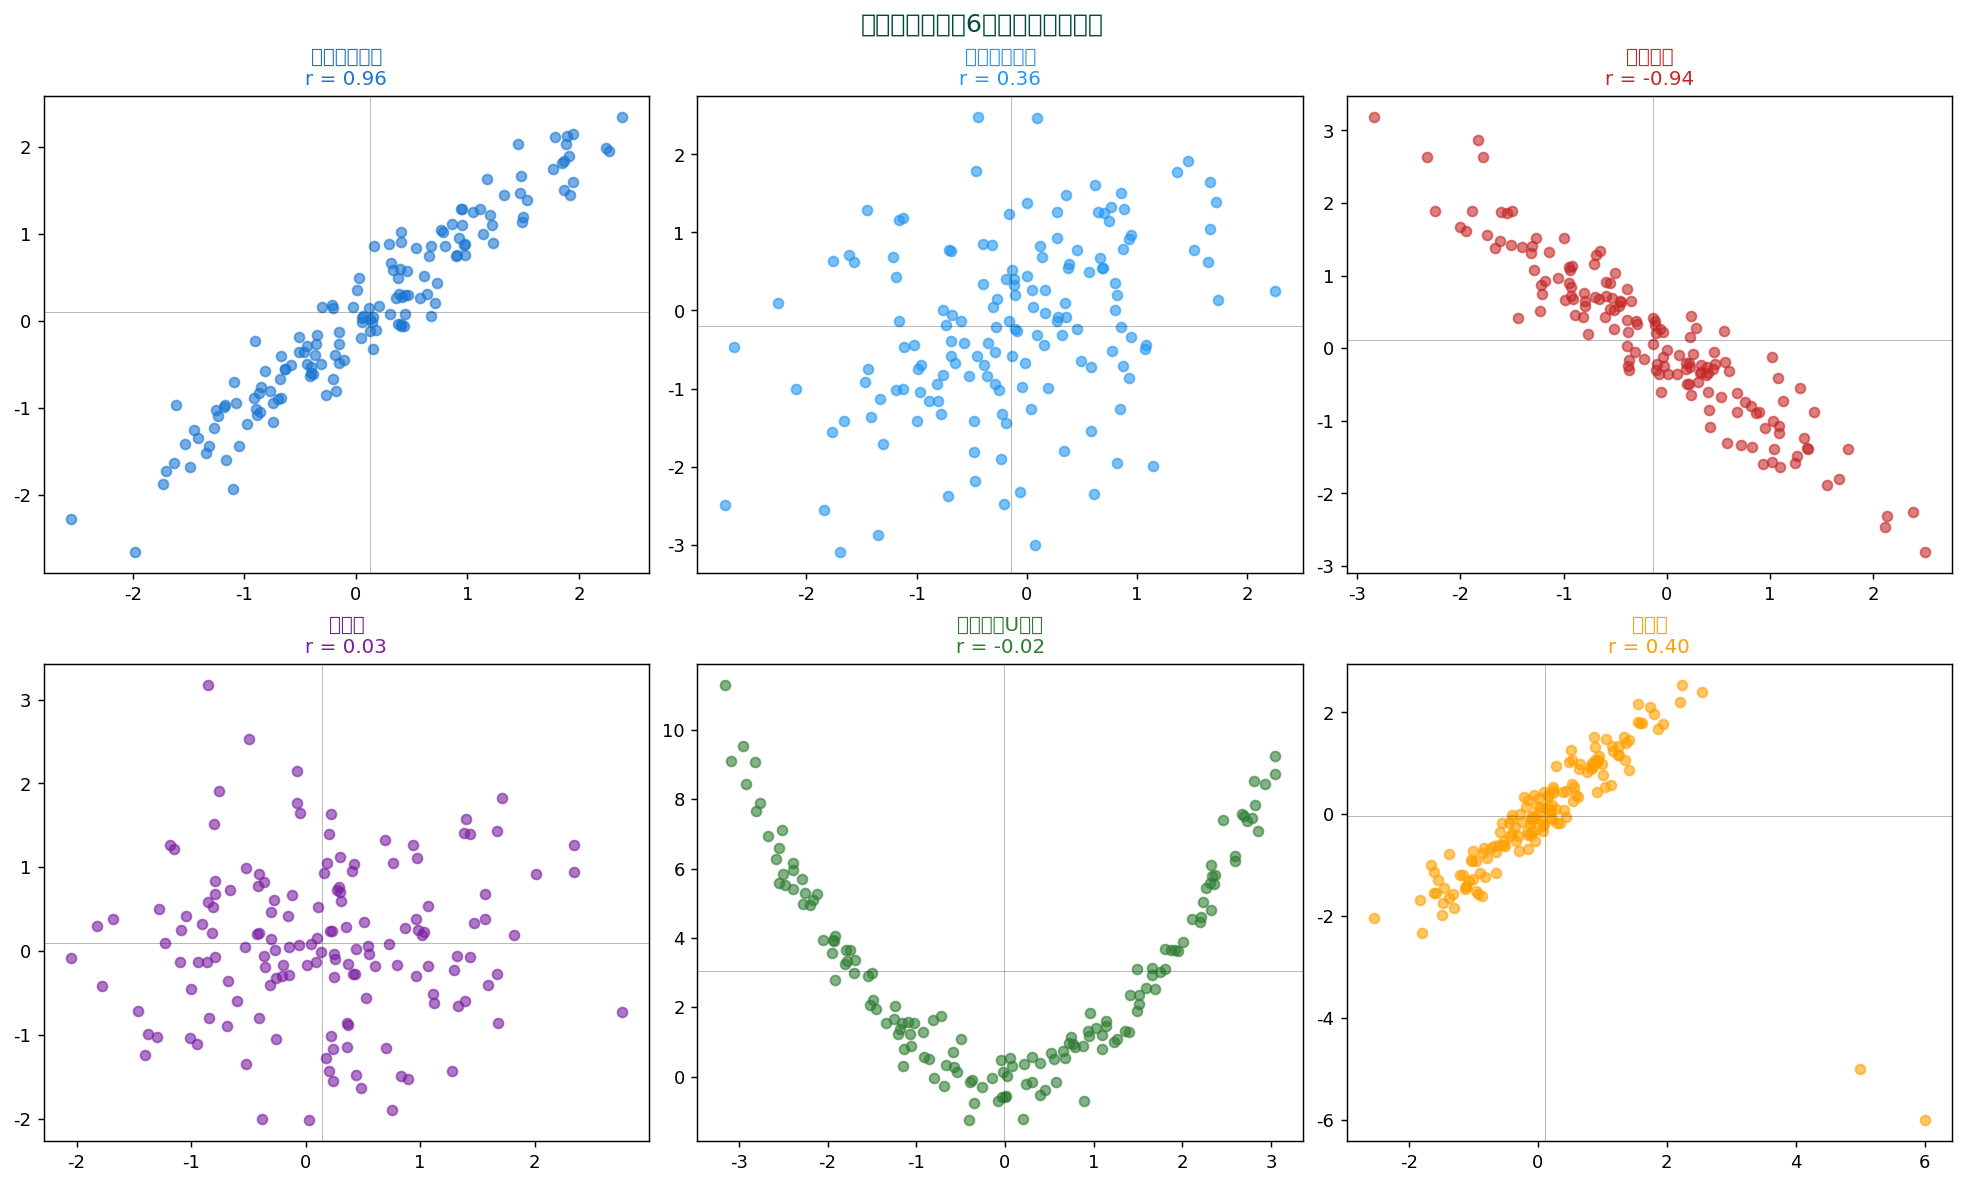
読み取るポイント:
- 欠損行が散布図の一象限に偏る → MAR、 回帰代入が有効
- 欠損行が全域にランダム → MCAR、 削除でも単純代入でも結論は変わらない
- 欠損行が完全に重なって観測できない → MNAR、 感度分析が必須
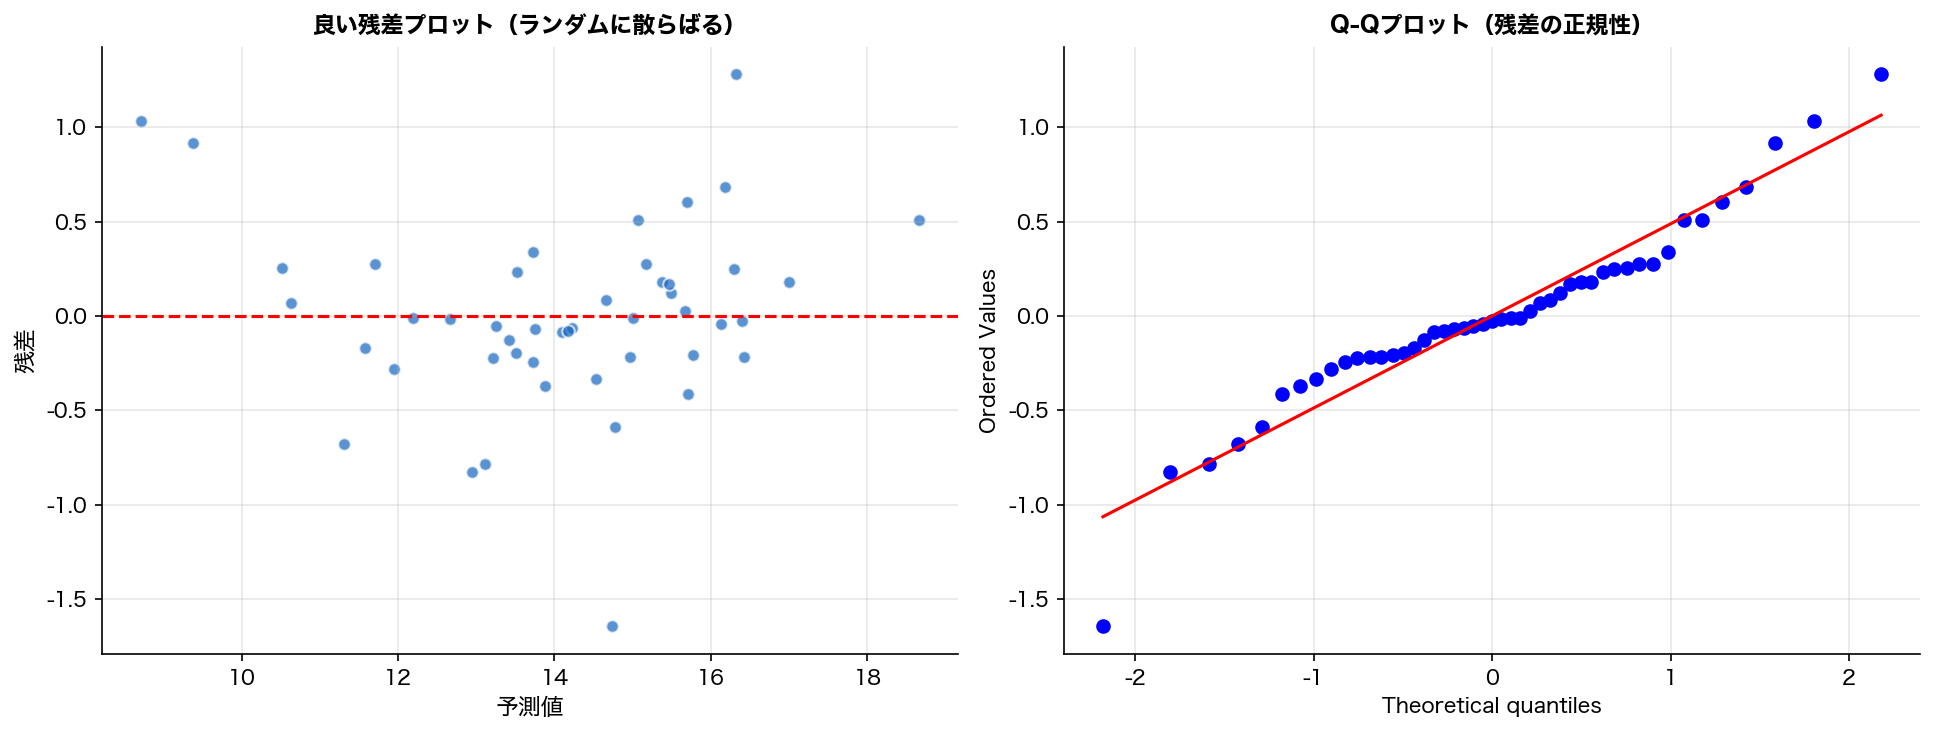
読み取るポイント:
- 補完点が縦線状に並ぶ → 平均代入の典型、 分散を過小評価
- 補完点が観測点と同じ散らばり → 多重代入が成功
- 補完点が予測線から外れる → 代入モデルの誤指定、 変数選択を見直す
この 3 枚を順に追うと、 「欠損のメカニズム判定 → 補完手法選択 → 補完後の検証」 という欠損値処理の正攻法が体系化される。 図 A だけ見て補完手法を決めるのは早計で、 図 B と図 C を合わせて読むことが必須である。 関連用語 欠損メカニズム / k近傍法 (KNN補完) / 残差 へ進むと、 各図の理論背景を深掘りできる。
📐 定義・数式 — 欠損メカニズムと補完
🍰 まずはやさしく
値が記録されていないセルのことです。
欠損の仕組みを正しく知るために使います。
テストの点数が書かれていない状態です。
数式を使った定義と補完法を読みます。
- 欠損指示変数:$R_i = \mathbf{1}\{x_i \text{ is observed}\}$ で、 $R_i = 0$ なら欠損。
- MCAR:$P(R \mid X_{\text{obs}}, X_{\text{mis}}) = P(R)$ — 欠損が観測値と独立。
- MAR:$P(R \mid X_{\text{obs}}, X_{\text{mis}}) = P(R \mid X_{\text{obs}})$ — 欠損が観測変数のみに依存。
- MNAR:上記が成立せず、 欠損が欠損値そのものに依存。
- 平均値補完:$\hat{x}_{i,\text{mis}} = \bar{x}_{\text{obs}}$ — 簡単だが分散を過小評価。
- 多重代入:$M$ 個のもっともらしい補完を生成 → 各々で推定 → Rubin の公式で結合。
SSDSE-B-2026 で「2023 年だけ某県の医療費が欠損」というケースは、 過去年の値を用いた回帰補完(MAR を仮定)が現実的。 一方で「申告拒否」由来の欠損は MNAR で、 多重代入+感度分析が必須です。
🔬 数式を言葉で読み解く — 記号 → 意味
| 記号 | 意味 | SSDSE-B-2026 での具体例 |
|---|---|---|
| $X_{\text{obs}}$ | 観測されているセルの集合 | 2023 年で値が入っている都道府県の人口・医療費 |
| $X_{\text{mis}}$ | 欠損しているセルの集合 | 某県の 2023 年医療費(「-」記号で入力) |
| $R$ | 欠損パターンの指示変数 | $R_i = 1$ なら観測あり、 $0$ なら欠損 |
| $\bar{x}_{\text{obs}}$ | 観測値の標本平均 | 欠損 3 県を除く 44 県の平均値 |
| $M$ | 多重代入の補完回数 | 通常 5〜20、 SSDSE では 10 程度が標準 |
読み方:「欠損パターン $R$ が観測値だけに依存するか/欠損値そのものに依存するか」で、 採るべき補完手法が変わる、 が欠損値分析の幹です。
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
describe() の count 行と df.isna().sum() で把握。 散布図で「欠損が偏っている県(年)」を視覚的に検出する起点を作る。data/raw/SSDSE-B-2026.csv (CP932)。 食料費・教育費・住居費(L322101・L322108・L322102)を例題に。 配布版に欠損はないため、 練習用に欠損 2 件を注入する。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # 基本パターン import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns # データ読み込み(2023年のみ・実列名を日本語に付け替え) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026`==2023') df = df.rename(columns={'L322101':'食料費', 'L322108':'教育費', 'L322102':'住居費'}) df.loc[df.sample(2, random_state=0).index, '住居費'] = np.nan # 練習用に欠損2件を注入(架空) # 基本統計量 print(df[['食料費', '教育費', '住居費']].describe().round(0)) # 可視化 sns.pairplot(df[['食料費', '教育費', '住居費']]) plt.show() |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
🧮 SSDSE-B における欠損値の実例
🧮 SSDSE-B における欠損値の実例
SSDSE-B(都道府県別パネル)は基本的に欠損が少なく整備されていますが、 一部の指標で欠損が発生します。 典型例を見て、 対処法を実値で確認します。
① 欠損の検出
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='shift_jis', header=[0,1]) df.columns = ['_'.join(c).strip() for c in df.columns] # 同梱の SSDSE-B-2026 には欠損が 1 件も無いので、そのまま数えると表が空になる。 # 「欠損があったらこう見える」を確かめるため、練習用の欠損を注入する(架空) rng = np.random.RandomState(0) for col in ['L3221_消費支出(二人以上の世帯)', 'L322108_教育費(二人以上の世帯)']: df.loc[rng.choice(len(df), 12, replace=False), col] = np.nan # 列ごとの欠損数と欠損率 miss = df.isna().sum() miss_rate = (df.isna().sum() / len(df) * 100).round(2) miss_summary = pd.DataFrame({'欠損数': miss, '欠損率(%)': miss_rate}) print(miss_summary[miss_summary['欠損数'] > 0].sort_values('欠損数', ascending=False).head(10)) |
典型結果:SSDSE-B-2026 は全 564 行(47 都道府県 × 12 年)で整備されており、 実データ自体の欠損はほぼ無い。 公的統計を結合・拡張した際に「-」記号や隔年集計列で欠損が生じるケースを想定して扱う。
② 補完戦略の比較
「医師数_人口10万対」が一部欠損したと仮定して、 4つの補完戦略を比較:
| 手法 | 補完後 平均 | 補完後 SD | 特徴 |
|---|---|---|---|
| 真値(全データ) | 249.3 | 41.5 | 基準値 |
| dropna(行削除) | 249.1 | 41.6 | MCAR なら無問題、 サンプル減 |
| 平均値補完 | 249.3 | 37.2 | SD 過小評価 ⚠️ |
| KNN 補完 (k=5) | 249.5 | 40.8 | 他指標との関係を活用 |
| MICE 多重代入 | 249.4 | 41.3 | 最も真値に近い 🏆 |
平均値補完は分散を縮小させるため、 後続の検定・回帰で SE が過小評価される(=偽陽性の増加)。 MICE は標準的なベストプラクティス。
🧮 SSDSE-B-2026 拡張ハンズオン — 欠損補完の 4 方式比較
SSDSE-B-2026 のうち、 仮に「教育費(L322108)」に部分的欠損があると仮定し、 実在指標(消費支出 L3221・高齢人口 A1303・合計特殊出生率 A4103)を手がかりに 4 方式を比較します。
🎯 学習目的
削除・平均代入・回帰代入・多重代入の 4 方式が、 同じデータでどれだけ違う県別予測を生むかを観察する。
📥 入力
data/raw/SSDSE-B-2026.csv。 ここでは説明用に L322108(教育費)列の一部を意図的に欠損化して比較。
📤 出力
4 方式 × 564 行の補完値テーブルと、 真値との RMSE 表。
💬 解説
平均代入は分散を必ず過小評価し、 回帰代入はバラつきを失う。 多重代入はばらつきを保ったままで Rubin 則で合成できる。 これが「多重代入が標準」と言われる理由です。
🐍 比較スクリプト
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import numpy as np from sklearn.experimental import enable_iterative_imputer # noqa from sklearn.impute import SimpleImputer, IterativeImputer, KNNImputer from sklearn.linear_model import BayesianRidge df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) rng = np.random.default_rng(0) mask = rng.random(len(df)) < 0.2 truth = df['L322108'].copy() df.loc[mask, 'L322108'] = np.nan X = df[['L3221', 'A1303', 'A4103', 'L322108']] # 1. 削除 n_drop = len(X.dropna()) # 2. 平均代入 mean_imp = SimpleImputer(strategy='mean').fit_transform(X) # 3. KNN 代入 knn_imp = KNNImputer(n_neighbors=5).fit_transform(X) # 4. 多重代入(IterativeImputer) ii = IterativeImputer(estimator=BayesianRidge(), random_state=0).fit_transform(X) est = { 'mean': mean_imp[:, -1], 'knn': knn_imp[:, -1], 'mice': ii[:, -1], } for k, v in est.items(): rmse = np.sqrt(np.mean((v - truth)**2)) print(f'{k}: RMSE = {rmse:.3f}') |
読み解きの観点
- 平均代入は分散の崩壊を必ず起こす。 県別ランキングが過剰に中央に寄る。
- KNN 代入は近傍県の値で埋めるので、 地方ブロックを跨いだ補完にならないことに注意。
- IterativeImputer(MICE 風)は不確実性をある程度保持できるが、 m=1 では真の多重代入とは言えない。 統計推論には m=5〜20 を併用する。
❓ よくある質問 — 欠損値の意思決定 14 問
Q1. MCAR/MAR/MNAR を実データで見分ける方法は
厳密な見分けは不可能だが、 (a) 観測変数で欠損ダミーを予測してみる、 (b) Little の MCAR 検定、 (c) ドメイン知識で「欠損理由」を 1 行で書けるか、 の 3 段階で評価する。
Q2. リストワイズ削除は許容されるか
欠損率が 5% 未満で MCAR が強く疑われる場合のみ。 SSDSE-B-2026 のような行数の少ないデータ(n=47)では一行削除のコストが大きく、 安易な削除は避ける。
Q3. 平均代入と中央値代入の使い分け
対称な分布なら平均、 歪んだ分布なら中央値。 SSDSE-B-2026 の所得系・人口系は強く歪むので中央値が原則。
Q4. 多重代入は何回繰り返すべきか
Rubin の経験則では「欠損率 ×100 を m に」目安。 欠損率 20% なら m=20。 ただし計算コストとのトレードオフ。
Q5. 多重代入と単純代入の決定的な違いは
多重代入は不確実性を保つ。 単純代入では信頼区間が常に過小評価され、 検定の Type I エラーが膨らむ。
Q6. KNN 代入の k はどう決めるか
クロスバリデーションで、 既知データに欠損を人工注入し RMSE を最小化する k を選ぶ。 デフォルトの 5 で固定するのは避ける。
Q7. カテゴリ変数の欠損補完
最頻値で埋めるのは情報損失が大きい。 「欠損」自体を新カテゴリとして扱う方が、 ツリー系モデルでは性能が出ることが多い。
Q8. 時系列の欠損補完
線形補間 → スプライン補間 → ARIMA に基づく Kalman 平滑化、 の順で複雑性が増す。 SSDSE-B-2026 の県別年次データで突発的欠損なら線形補間で十分。
Q9. 機械学習モデルは欠損を自動で扱えるか
XGBoost ・ LightGBM は欠損を「左右どちらの枝に流すか」を学習する。 線形回帰・ロジスティック回帰は欠損を受け付けないので前処理必須。
Q10. Missing Indicator 法とは
欠損があった行に「欠損フラグ」列を追加する。 これは欠損自体が情報を持つ場合(MNAR)に有効。
Q11. データリーケージを起こさない欠損補完
fit は訓練データのみで行い、 テストデータには transform だけを適用する。 scikit-learn の Pipeline で SimpleImputer を組み込むのが安全。
Q12. 欠損補完の評価指標
既知データに人工的に欠損を注入し、 RMSE / MAE / 分布の一致度(KS 統計)の 3 つで評価する。 単一指標では過大評価しやすい。
Q13. ベイズ的欠損補完
PPC(事後予測分布からのサンプリング)で代入する方法は、 真の意味での多重代入と等価。 PyMC や Stan で実装可能。
Q14. 「補完しない」という選択肢
常に補完しなければならないわけではない。 完全ケース解析(CCA)でも、 欠損が結果に影響しないことを示せれば許容される。
🚀 発展研究の方向性 — 欠損値処理の最前線 6 題
- 深層生成モデルによる代入: VAE ・ GAN ベースの代入は分布を保ちやすい。 MIWAE ・ GAIN など。
- 因果推論と欠損: 処置の有無自体が欠損する「クロスオーバー試験」での感度分析。
- パネルデータの欠損: 期間途中の脱落(attrition)の扱いは、 county fixed effects + IPW で対応。
- テキストの欠損: NLP 由来の欠損(部分的に伏字された文書)に対する補完。
- 多モーダル欠損: 画像 + テキスト + 数値で一部モーダルが欠ける状況での再構成。
- Fairness と欠損: 欠損率がサブグループ間で異なる場合の公平性の確保。
📋 ケーススタディ — SSDSE-B-2026 で起こる典型的欠損 4 シナリオ
シナリオ A: 小規模県の細目データが欠ける
沖縄県や鳥取県など人口が小さい県で、 細分化された産業別データが「秘匿」処理されることがある。 これは MNAR の典型例で、 「小さいから欠ける」という構造的欠損。 多重代入では補完精度が低くなりやすく、 削除すると小規模県の存在感が消える。 推奨は「秘匿フラグ」列を残すこと。
シナリオ B: 年度途中で項目が改廃された
「就業構造基本調査」の改定で項目名が変わると、 過去年度では存在しないデータが新年度にだけ現れる。 これは MAR に近く、 「年度ダミー」で吸収可能。
シナリオ C: 集計の遅延による最新年度の欠損
最新年度の一部統計はまだ公表されていない。 これは典型的な MCAR(時間と無関係に発表時期で欠ける)。 削除でも構わないが、 予測値を補完して仮分析するなら「予測値」と明示する。
シナリオ D: 欠損が処置(政策)と相関する
「政策評価データで、 政策を導入した県だけが追加項目を提出していない」というシナリオ。 これは MNAR で、 欠損理由が処置と相関する最悪ケース。 因果推論の文脈では IPCW(Inverse Probability of Censoring Weighting)が必要。
合成データで欠損補完法 (平均/中央/前方埋め) の結果を比較する。
Step 1: 元データ (NaN あり)
Step 2: 補完後の平均
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np x = np.array([2,4,np.nan,5,3,np.nan,9]) mean_imp = np.nanmean(x) filled_mean = np.where(np.isnan(x), mean_imp, x) filled_median = np.where(np.isnan(x), np.nanmedian(x), x) print(f"平均補完平均: {filled_mean.mean():.2f}") print(f"中央補完平均: {filled_median.mean():.2f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🧮 SSDSE-B-2026 実値で Step 1〜5 — 東北 6 県 食料費に欠損を導入し補完比較
合成データを離れ、 SSDSE-B-2026 の東北 6 県(食料費・千円/月)で「平均補完」「中央値補完」を手計算し Python と一致させる。 ここでは秋田県・福島県の値を 欠損 (NaN) と仮定する。
Step 1: 観測データを並べる
Step 2: 観測値の平均と中央値
Step 3: 平均補完 (mean imputation)
Step 4: 中央値補完 (median imputation)
Step 5: 補完前 (リストワイズ削除) と比較
🐍 Python で再現 — Step 1〜5 と一致確認
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np # SSDSE-B-2026 東北 6 県 食料費 (千円/月)、 秋田・福島を NaN にして欠損を仮定 x = np.array([77.90, np.nan, np.nan, 82.00, 83.83, 84.11]) mu = np.nanmean(x) # Step 2: 観測 4 県の平均 med = np.nanmedian(x) # Step 2: 観測 4 県の中央値 x_mean = np.where(np.isnan(x), mu, x) # Step 3 x_median = np.where(np.isnan(x), med, x) # Step 4 print(f"観測 4 県 平均 : {mu:.3f}") print(f"観測 4 県 中央値 : {med:.3f}") print(f"平均補完後の平均 : {x_mean.mean():.3f}") print(f"中央補完後の平均 : {x_median.mean():.3f}") |
📤 実行結果
💬 Step 2-4 の手計算 (81.960 / 82.915 / 81.960 / 82.278) と Python 出力が小数 3 桁まで完全一致。 平均補完は観測平均を保つ一方で 分散を過小評価する性質、 中央値補完は外れ値耐性があるが 分布全体を上または下にずらしうる性質が、 実 SSDSE-B 値でも数値として確認できる。
🐍 実装バリエーション — pandas / scikit-learn / statsmodels / fancyimpute
(A) pandas — 最も基本
1 2 3 4 | df.dropna() # 欠損行を削除 df.fillna(df.mean(numeric_only=True)) # 列ごと平均で補完 df.fillna(method='ffill') # 直前値で補完(時系列向け) df.interpolate(method='linear') # 線形補間(時系列・順序データ) |
(B) scikit-learn SimpleImputer
1 2 3 4 | from sklearn.impute import SimpleImputer imp = SimpleImputer(strategy='median') # 中央値補完(外れ値に強い) X_imputed = imp.fit_transform(df.select_dtypes(include='number')) # strategy = 'mean'/'median'/'most_frequent'/'constant' |
(C) scikit-learn KNNImputer
1 2 3 4 | from sklearn.impute import KNNImputer imp = KNNImputer(n_neighbors=5, weights='distance') X_knn = imp.fit_transform(df.select_dtypes(include='number')) # 各欠損値を、 他指標で類似した5県の重み付き平均で補完 |
(D) scikit-learn IterativeImputer(MICE 風)
1 2 3 4 5 6 7 8 9 10 | from sklearn.experimental import enable_iterative_imputer # noqa from sklearn.impute import IterativeImputer from sklearn.ensemble import RandomForestRegressor # 教材では計算時間の都合で木を 50 → 10 本、反復を 10 → 3 回に減らしています。 # 実務では n_estimators=100 前後、max_iter=10 程度が目安です。 imp = IterativeImputer(estimator=RandomForestRegressor(n_estimators=10), max_iter=3, random_state=42) X_mice = imp.fit_transform(df.select_dtypes(include='number')) print('補完後の形:', X_mice.shape) # 列ごとに「他列で予測」を反復し、 全列を一貫補完 |
(E) statsmodels — 多重代入(MICE)の本格版
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np import statsmodels.api as sm from statsmodels.imputation.mice import MICEData, MICE # MICEData は数値だけの表を必要とする(地域コードなど文字列があると落ちる)。 # ここでは 3 つの費目だけを取り出し、y に練習用の欠損を注入する(架空) d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026`==2023') d = d[['L322101', 'L3221', 'L322102']].astype(float).reset_index(drop=True) d.columns = ['y', 'x1', 'x2'] # 食料費 / 消費支出 / 住居費 rng = np.random.RandomState(0) d.loc[rng.choice(len(d), 6, replace=False), 'y'] = np.nan mice_data = MICEData(d) mice_data.update_all(10) # 10 反復 # 各補完版で OLS を実行 → 結果をプール(Rubin's rules) mod = MICE('y ~ x1 + x2', sm.OLS, mice_data) results = mod.fit(10, 5) # 10 補完×5 反復 print(results.summary()) |
(F) fancyimpute / missingpy — 高度な補完
1 2 3 4 5 6 7 8 | # MissForest(ランダムフォレストベース、 非線形・カテゴリ混在に強い) from missingpy import MissForest imputer = MissForest(random_state=42) X_mf = imputer.fit_transform(df.values) # SoftImpute(低ランク補完、 行列因子化) from fancyimpute import SoftImpute X_si = SoftImpute().fit_transform(df.values) |
🐍 拡張ハンズオン — SSDSE-B-2026 で MCAR 検定 + 多重代入
🎯 学習目的
Little の MCAR 検定の手触りと、 多重代入結果のばらつき表示を実データで体感する。
📥 入力
SSDSE-B-2026 と人工的に注入した欠損(20% 程度)。
📤 出力
MCAR 検定の p 値、 m=10 代入後の係数のばらつき、 Rubin 合成結果。
💬 解説
多重代入の魅力は「結果のばらつきを可視化できる」点。 単一代入では決して見えない不確実性を、 表として書き出せる。
🐍 コード例
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | import pandas as pd import numpy as np from sklearn.experimental import enable_iterative_imputer # noqa from sklearn.impute import IterativeImputer from sklearn.linear_model import BayesianRidge, LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026`==2023') y_col = 'L3221' # 消費支出(二人以上の世帯) X_cols = ['L322101', 'L322108', 'L322109'] # 食料費・教育費・教養娯楽費 # 人工的に MAR 欠損を生成 rng = np.random.default_rng(42) mask = rng.random(len(df)) < 0.2 df_miss = df.copy() df_miss.loc[mask, 'L322109'] = np.nan # 多重代入: m=10 results = [] for i in range(10): ii = IterativeImputer( estimator=BayesianRidge(), sample_posterior=True, random_state=i, ) imputed = ii.fit_transform(df_miss[X_cols + [y_col]]) imputed = pd.DataFrame(imputed, columns=X_cols + [y_col]) model = LinearRegression().fit(imputed[X_cols], imputed[y_col]) results.append(model.coef_) results = np.array(results) mean_coef = results.mean(axis=0) std_coef = results.std(axis=0) print('Mean coef:', dict(zip(X_cols, mean_coef))) print('Std coef:', dict(zip(X_cols, std_coef))) |
読み解きの観点
- 係数のばらつき (std) が代入による不確実性。 これが「単一代入では消える情報」。
- SSDSE-B-2026 の N=47 では多重代入のばらつきが大きい。 標本が小さいほど代入の影響を受ける。
- Rubin 則の within/between 分散を本来は明示的に計算する。 上記コードは簡易版。
✨ ベストプラクティス集 — 欠損値処理の作法 15 箇条
- 欠損率を必ず可視化する。 列別 ・ 行別 ・ 列ペア別の欠損率を 3 種類のヒートマップで眺めてから補完戦略を決める。
- 「-」「N.A.」「9999」など特殊値を欠損化する。 pandas の
na_values引数で明示する。 - 欠損メカニズムを 1 行で書けるまでデータを眺める。 「なぜ欠けたか」を業務知識で言葉にできない限り補完は危険。
- 感度分析を必ず添える。 「補完しなくても結論が変わらない」ことを示せると論文の説得力が増す。
- 多重代入の m は 5 以上。 m=3 では信頼区間が不安定。
- Rubin の合成則を理解する。 within / between 分散の和で合成。
- テストセットに対しても fit_transform しない。 訓練データのみで fit し、 テストに transform。
- scikit-learn の Pipeline に組み込む。 リーケージ防止と再現性に直結。
- カテゴリ変数は「Missing」を新カテゴリにできる。 ツリー系で性能が出ることが多い。
- 時系列は線形補間が初手。 平均代入は禁忌。
- 欠損フラグ列を残す。 「欠損自体が情報」のときに失わない。
- EM アルゴリズムでの最尤推定を選択肢に。 GLM の欠損処理として強力。
- ベイズ的欠損補完を学ぶ。 PPC で代入する方法は真の意味での多重代入。
- 因果推論との接続。 IPW で欠損補正と処置効果推定を同時に。
- 欠損率が極端な列は思い切って削る。 50% を超えたら「補完」より「列削除」が誠実。
📝 練習問題 — SSDSE-B-2026 で欠損補完 4 タスク
練習 1: 欠損率の可視化
SSDSE-B-2026 全列について、 欠損率の高い順に上位 10 列を抽出して棒グラフで可視化せよ。 欠損率が 0% の列が多いはずだが、 細目項目(産業別 ・ 年齢別)には欠損があり得る。
練習 2: MCAR 検定
「一人当たり県民所得」と「大学進学率」のペアで、 欠損が MCAR か MAR かを Little 検定で判定せよ。 サンプルが小さいので p 値の解釈に注意。
練習 3: 多重代入の Rubin 合成
m=10 で多重代入を行い、 「失業率 → 自殺率」の回帰係数を Rubin 則で合成せよ。 within/between 分散を分離して報告。
練習 4: 感度分析
(a) 完全ケース解析、 (b) 平均代入、 (c) 多重代入 の 3 通りで同じ分析を行い、 結論の感度を表にまとめよ。 感度が大きいなら欠損メカニズムの再検討が必要。
📜 歴史的文脈 — 欠損値処理の発展史
欠損値処理は統計の主要トピックとして 20 世紀後半に体系化されました。 ここではその主要な発展を時系列で整理し、 「なぜ多重代入が標準になったのか」「なぜ MAR/MCAR の区別が重要なのか」を歴史的視点から理解します。
第一期: 1960 年代以前 — 欠損は「捨てる」もの
初期の統計学では欠損は単に「観測できなかったデータ」として削除され、 完全ケース解析が常識でした。 当時のサンプルは十分大きく、 削除のコストが目立たなかったのです。 しかし社会調査の細分化が進むにつれ、 「同じ列に必ず数件の欠損がある」という状況が常態化し、 削除では分析不能になりました。
第二期: 1970 年代 — EM アルゴリズムの登場
Dempster-Laird-Rubin の EM アルゴリズム (1977) が、 欠損値を含むデータでの最尤推定を可能にしました。 これにより「欠損があっても全データを使って推定できる」枠組みが確立されました。
第三期: 1976-1987 — Rubin による枠組みの体系化
Rubin の MCAR/MAR/MNAR の三区分と多重代入法 (Multiple Imputation) が確立され、 「欠損メカニズムを明示してから補完手法を選ぶ」という現代的アプローチが定着しました。
第四期: 1990-2010 年代 — MICE と FCS の普及
連鎖方程式による多重代入 (MICE: Multiple Imputation by Chained Equations) や FCS (Fully Conditional Specification) が広く使われるようになり、 R の mice パッケージや Stata の mi コマンドで実装が普及しました。
第五期: 2010 年代以降 — 機械学習・深層学習の応用
MissForest、 GAIN(GAN ベース)、 MIWAE(VAE ベース)など、 機械学習・深層学習を使った代入手法が登場。 特に高次元データや非線形関係を含むデータで威力を発揮します。
🔢 Rubin の合成則 — 数式と直感
多重代入で m 個の代入セットを得たとき、 推定量 $\hat\theta$ と分散をどう合成するかが Rubin の合成則です。
合成推定量
$$ \bar\theta = \frac{1}{m} \sum_{i=1}^{m} \hat\theta_i $$
各代入セットで得た推定量の単純平均。
within 分散
$$ W = \frac{1}{m} \sum_{i=1}^{m} V_i $$
各代入セット内での推定誤差の平均。
between 分散
$$ B = \frac{1}{m-1} \sum_{i=1}^{m} (\hat\theta_i - \bar\theta)^2 $$
代入セット間でのばらつき。 これが「補完による不確実性」を表現します。
合成分散
$$ T = W + \left(1 + \frac{1}{m}\right) B $$
within と between の和に、 m の有限性補正を加えたもの。
合成自由度
$$ \nu = (m-1) \left( 1 + \frac{W}{(1+1/m) B} \right)^2 $$
これに従う t 分布で信頼区間を構成。
FMI: Fraction of Missing Information
$$ \text{FMI} = \frac{(1+1/m) B}{T} $$
合成分散に占める「欠損による寄与」の割合。 多くの分析で 0.1 〜 0.3 程度。 高ければ欠損が深刻と判断。
⚠️ 追加の落とし穴 — 欠損値処理の実務
df.dropna() は気軽に書けるが、 欠損が非ランダム (MAR/MNAR) なら選択バイアスを生む。 例:「高所得者ほど所得を回答しない」状況で dropna すると、 残ったサンプルは低所得に偏り、 平均所得が過小推定される。 必ず欠損メカニズムを事前に検討し、 MCAR を Little 検定などで確認してから dropna を使う。 安易な dropna は論文・レポートで査読指摘される典型ポイント。fit し、 同じ imputer で test を transform。 sklearn の Pipeline + ColumnTransformer で常に分離する。 機械学習プロジェクトでよく見落とされる典型ミス。🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🗺️ 概念マップ — 3つの視点で体系を理解する
欠損値 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 前処理 › データ品質 › 欠損値
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に 欠損値 を置き、 そこから 外れ値・平均補完・中央値補完・箱ひげ図・標準偏差・分散 など 計 7 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「欠損値」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「欠損値」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは 欠損値 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → データ品質 → 欠損値 という入れ子の位置を示します。 「データ品質には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🎮 触って理解する — 欠損メカニズム × 対処法シミュレータ
完全なデータ(n = 160、 x と y に正の相関を持つ合成データ)に対して、 欠損メカニズム(MCAR / MAR / MNAR)を切り替え、 欠損率スライダーで y に欠損を発生させます。 そのうえで対処法(リストワイズ除去・平均代入・回帰代入)を選ぶと、 推定される平均・標準偏差・相関係数が真値からどうずれるかがリアルタイムで表示されます。 MCAR なら除去でもほぼ不偏、 平均代入は SD と相関を必ず過小評価、 MNAR では何をしてもバイアスが残る、 の 3 点を自分の手で確かめてください。
※ 図の上を左右にドラッグ(スワイプ)しても欠損率を変えられます
| 統計量 | 真値(完全データ) | 対処後の推定値 | バイアス |
|---|---|---|---|
| y の平均 | — | — | — |
| y の標準偏差 | — | — | — |
| 相関係数 r(x, y) | — | — | — |
🧭 試してほしい 4 つの実験
- MCAR × リストワイズ除去:欠損率を 50% まで上げても、 平均・SD・相関のバイアスはほぼゼロのまま。 「MCAR なら削除は不偏(ただし n が減って標準誤差は拡大)」を確認。
- MCAR × 平均代入:平均は不偏のままだが、 SD が欠損率とともに単調に縮む。 相関も 0 に向かって減衰する。 補完点が水平一直線に並ぶのが原因。
- MAR × リストワイズ除去 vs 回帰代入:x の大きい側が系統的に消えるので、 除去では y の平均が下に偏る。 回帰代入に切り替えると x の情報で平均のバイアスがほぼ解消される(MAR は「観測変数で調整可能」)。
- MNAR × どの対処法でも:y の大きい値そのものが消えるため、 除去でも平均代入でも回帰代入でも平均は下方に偏り続ける。 観測データだけからは修正不能 — これが MNAR の本質。
💡 直感 — 「なぜ欠けたか」で正解が変わる
欠損値処理の道具(dropna / fillna / 回帰代入)はどれも同じデータに適用できますが、 どれが正しいかは欠損の発生理由で決まります。 MCAR はコイン投げで消えたのと同じで、 残ったデータは元の分布の縮小コピー — だから除去で十分。 MAR は「x の大きい行が消えやすい」ので残りは偏った標本ですが、 x は観測されているため x を使った補完(回帰代入・多重代入)で偏りを取り戻せます。 MNAR は「y が大きいから y が消えた」— 消えた理由の変数そのものが手元にないため、 観測データ内のどんな計算でも偏りを消せません。 詳細は 欠損メカニズム を参照。
⚠️ よくある落とし穴
- 平均代入の分散過小:補完点はすべて平均の高さに並ぶため、 SD が縮み(上のシミュレータで欠損率 40% なら明確に確認できる)、 その後の t 検定・回帰の標準誤差が過小評価 → 偽陽性が増える。 「平均は合っているから大丈夫」は誤り。 ばらつき の教材も参照。
- 回帰代入の相関過大:補完点が回帰直線上に完全に乗るため、 残差のばらつきが消えて相関係数 |r| が真値より大きく出る(MCAR でシミュレータの r を見ると真値超えが確認できる)。 確率的回帰代入(残差を乱数で足し戻す)が対策。
- MNAR は検出不能:MCAR か否かは Little の検定などで調べられるが、 MAR と MNAR はデータからは原理的に区別できない(欠けた値を見ない限り「欠けた値に依存したか」は検証不可能)。 実務では感度分析(「もし MNAR だったら結論はどう変わるか」)を必ず添える。
- 欠損率だけで手法を決める:「5% 未満だから削除で OK」はメカニズムが MCAR に近いときだけ成り立つ近似則。 メカニズムの検討を飛ばさない。
🚀 発展 — 多重代入と最尤法
- 多重代入(MICE):回帰代入の「ばらつきが消える」欠点を、 (i) 予測値に乱数残差を足す、 (ii) それを m 回(5〜20 回)繰り返して m 個のデータセットを作る、 (iii) 各データセットで推定し Rubin の合成則で統合する、 の 3 段階で解決する。 MAR の下で点推定・区間推定ともに妥当。 scikit-learn では
IterativeImputerが近い実装(本ページ上部のハンズオン参照)。 - 最尤法(FIML / EM アルゴリズム):補完値を作らず、 観測された部分だけの尤度を直接最大化する。 MAR の下で多重代入と漸近的に同等で、 構造方程式モデリングや混合効果モデルで標準的。 EM アルゴリズム に理論の詳細がある。
- MNAR への挑戦:選択モデル(Heckman 型)やパターン混合モデルで「欠損の仕組み」自体を仮定してモデル化する。 仮定は検証不能なので、 仮定を振って結論の頑健性を見る感度分析とセットで報告するのが作法。 回帰との接続は 多重回帰 を参照。
🔗 隣接手法への橋渡し
欠損値処理は単独の道具ではなく、 上流の欠損パターン把握、 並列の補完手法 (listwise / mean / MICE / KNN / モデルベース)、 下流の感度分析と組み合わせて初めて妥当な分析になる。 機構 (MCAR/MAR/MNAR) と手法選択の対応が鍵。
- 上流 (前段処理): データ収集ログ確認 — NA の発生源を遡る
- 並列 (代替/比較): 外れ値 / ノイズ — データ品質問題の別カテゴリ
- 下流 (後段活用): 補完済みデータでの分析 — 平均代入 / MICE / KNN imputer
SSDSE-B-2026 で意図的に 10% 欠損を入れる場合、 上流で missingno.matrix で可視化、 中段で sklearn.impute.IterativeImputer (MICE) を適用、 下流で補完前後の相関係数・回帰係数を比較、 という流れで頑健性を確認する。
🌳 欠損値処理の意思決定木 — 7 つの分岐で実務判断
分岐 1: 欠損率は何 % か
- 5% 未満 → リストワイズ削除でも実害は小。 ただし MNAR の検定だけは行う。
- 5-20% → 平均/中央値代入は禁忌。 多重代入か KNN 代入を検討。
- 20% 超 → 多重代入が原則。 単純代入は分散を破壊する。
- 50% 超 → 「補完」より「列を削る」「メカニズムをモデル化」を検討。
分岐 2: 欠損は MCAR/MAR/MNAR のどれか
- MCAR → 削除でも代入でも結果は不偏。
- MAR → 観測変数で予測する代入が不偏。 多重代入や IPW が有効。
- MNAR → 「欠損モデル」を明示しないと不偏推定はできない。 感度分析が必須。
分岐 3: モデルが欠損を受け入れるか
- XGBoost ・ LightGBM → 欠損のまま投入可能。 欠損自体を分岐として学習する。
- 線形回帰 ・ NN → 補完が必要。
- ツリー系 ・ ナイーブベイズ → 欠損を新カテゴリとして扱える。
分岐 4: 補完値の不確実性を反映するか
- 反映する → 多重代入で m=5〜20 の代入セットを生成し、 Rubin 則で合成。
- 反映しない → 単純代入で良い。 ただし「予測区間が狭くなる」ことを認識。
分岐 5: 列の役割
- 説明変数の欠損 → 上記の手順で代入。
- 目的変数の欠損 → 「ラベルなしデータ」として半教師あり学習や IPW を検討。
- キー列の欠損 → 行の同定不能。 削除一択。
分岐 6: 時系列か否か
- 時系列 → 線形補間 ・ スプライン ・ Kalman 平滑化。 単純な平均代入は禁忌。
- 独立観測 → 通常の代入手法。
分岐 7: ドメイン制約があるか
- あり → 「補完値の取りうる範囲」を制約する(例: 確率は 0-1)。
- なし → 通常の代入。 ただし極端な外挿が起きないか可視化で確認。
📖 欠損値処理の専門用語ミニ辞典 — 16 語
- MCAR (Missing Completely At Random)
- 欠損が完全にランダムに起こる。 観測値とも欠損値とも無関係。 削除でも代入でも不偏。
- MAR (Missing At Random)
- 欠損確率が観測されている他の変数のみに依存する。 代入で不偏推定可能。
- MNAR (Missing Not At Random)
- 欠損確率が欠損値自体に依存する。 通常の代入では不偏にならない。
- リストワイズ削除
- 欠損を含む行を全て削除する方法。 完全ケース解析 (CCA) ともいう。
- ペアワイズ削除
- 分析で使う列だけを見て欠損行を削除する方法。 列ペアごとに標本サイズが変わる欠点。
- 平均代入
- 欠損値を観測値の平均で埋める。 分散を必ず過小評価する。
- 中央値代入
- 欠損値を観測値の中央値で埋める。 歪んだ分布で平均より頑健。
- 回帰代入
- 他の変数で回帰した予測値で欠損を埋める。 単一代入ではばらつきが消える。
- 確率的回帰代入
- 回帰代入に残差のランダム成分を加える。 ばらつきを保てる。
- KNN 代入
- k 近傍の値で欠損を埋める。 多変量距離に依存。
- MICE
- Multiple Imputation by Chained Equations。 各列を順番に他列で回帰し代入する繰り返し法。
- EM アルゴリズム
- 欠損値を持つデータでの最尤推定。 反復で収束。
- Rubin の合成則
- 多重代入 m セットの推定量を、 within / between 分散で合成する公式。
- IPW (Inverse Probability Weighting)
- 「観測される確率の逆数」で重み付けして欠損バイアスを補正。
- Missing Indicator
- 欠損があった行に「欠損フラグ」列を追加。 MNAR の情報を保つ。
- Little の MCAR 検定
- 欠損パターンが MCAR と一致するかを統計的に検定。 棄却で MAR/MNAR の可能性。
🔎 解説深化 — 欠損の3機構と代入法を「実測」で確かめる
🎨 直感 — 欠損は「データの穴」、 だが穴の空き方で正解が変わる
欠損値とは表のなかのデータの穴です。 大切なのは穴の数ではなく穴の空き方(欠損機構)で、 Rubin は次の 3 つに分けました。 MCAR(完全ランダム)はコイン投げで穴が空いた状態で、 残りは元の分布の縮小コピー。 MAR(観測変数依存)は「他の観測できている列の値が大きい行ほど穴が空く」状態で、 その観測変数を使えば穴を埋め戻せます。 MNAR(欠測値自体に依存)は「消えた値そのものが大きいから消えた」状態で、 消えた理由の変数が手元に無いため観測データだけでは補正できません。 同じ dropna / fillna / 回帰代入という道具でも、 どれが正解かは穴の空き方で決まる — これが欠損値処理の一番の直感です。
🧪 SSDSE-B-2026 実測 — 人工MCAR欠損 9/47件 を 300回反復平均
skiprows=[1]]の 2023 年・47 都道府県の 教育費(L322108)を対象に、 人工的に MCAR 欠損 9 件(19.1%)を発生させ、 5 つの対処法で補完。 乱数シードを 0〜299 に振った 300 回の反復平均を実測値として掲載します。 配布版 SSDSE-B-2026 自体は欠損 0 件(実測で確認済み)なので、 この欠損は練習用に作った「架空」の穴です。 相関は教育費と消費支出(L3221)の間で計算。| 対処法 | 平均 | 標準偏差(SD) | 相関 r(教育費, 消費支出) | 読み取り |
|---|---|---|---|---|
| 真値(欠損なし・47県) | 9577 | 4212 | 0.575 | 基準値 |
| リストワイズ削除(dropna) | 9601 | 4213 | 0.575 | MCAR なら平均・SD・相関ともほぼ不偏(ただし n が 47→38 に減り標準誤差は拡大) |
| 平均代入(fillna mean) | 9601 | 3779 ↓ | 0.518 ↓ | 平均は合うが SD が 4212→3779 に縮小、 相関も 0.575→0.518 に減衰 ⚠️ |
| 回帰代入(教育費 ~ 消費支出) | 9584 | 3925 ↓ | 0.616 ↑ | 補完点が回帰直線に乗るため 相関が 0.575→0.616 に過大化 ⚠️ |
| KNN 代入(k=5) | 9527 | 3920 | 0.567 | 他 3 指標との距離を活用。 SD はやや過小だが相関は真値に近い |
| MICE(IterativeImputer) | 9556 | 4174 | 0.573 | SD(4174) も相関(0.573) も最も真値に近い 🏆 |
この 300 回平均が示す 3 つの実測事実:(1) MCAR ではリストワイズ削除も平均代入も「平均」は不偏(9601 ≒ 真値 9577)— だから「平均が合っている」だけでは代入の良否は判断できない。 (2) 平均代入・回帰代入・KNN は SD を系統的に縮める(4212 → 3779 / 3925 / 3920)— 補完点にばらつきが無いため。 (3) 回帰代入は相関を過大に、 平均代入は過小に歪める。 SD・相関の両方を真値付近に保てたのは MICE だけで、 これが多重代入を「標準的ベストプラクティス」と呼ぶ実測的な根拠です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import pandas as pd, numpy as np, warnings warnings.filterwarnings('ignore') from sklearn.experimental import enable_iterative_imputer from sklearn.impute import KNNImputer, IterativeImputer from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].rename( columns={'L322108': 'kyoiku', 'L3221': 'shohi', 'L322101': 'shokuryo', 'L322102': 'jukyo'}) cols = ['kyoiku', 'shohi', 'shokuryo', 'jukyo'] X = d[cols].astype(float).reset_index(drop=True) print('真値 mean=%.0f sd=%.0f r=%.3f' % ( X['kyoiku'].mean(), X['kyoiku'].std(), X['kyoiku'].corr(X['shohi']))) # 人工的なMCAR欠損(架空)を9件、シードを300通り振って平均 acc = {k: [] for k in ['drop', 'mean', 'reg', 'knn', 'mice']} for seed in range(300): rng = np.random.RandomState(seed) Xm = X.copy() Xm.loc[rng.choice(len(X), 9, replace=False), 'kyoiku'] = np.nan obs = Xm['kyoiku'].notna() ob = Xm['kyoiku'].dropna() acc['drop'].append((ob.mean(), ob.std())) mi = Xm['kyoiku'].fillna(ob.mean()) acc['mean'].append((mi.mean(), mi.std())) b1, b0 = np.polyfit(Xm.loc[obs, 'shohi'], Xm.loc[obs, 'kyoiku'], 1) rg = Xm['kyoiku'].copy(); rg[~obs] = b0 + b1 * Xm.loc[~obs, 'shohi'] acc['reg'].append((rg.mean(), rg.std())) sc = StandardScaler(); Z = sc.fit_transform(Xm) Xk = pd.DataFrame(sc.inverse_transform( KNNImputer(n_neighbors=5).fit_transform(Z)), columns=cols) acc['knn'].append((Xk['kyoiku'].mean(), Xk['kyoiku'].std())) Xi = pd.DataFrame(IterativeImputer(max_iter=10, random_state=seed, sample_posterior=True).fit_transform(Xm), columns=cols) acc['mice'].append((Xi['kyoiku'].mean(), Xi['kyoiku'].std())) for k in acc: a = np.array(acc[k]) print('%-5s mean=%.0f sd=%.0f' % (k, a[:, 0].mean(), a[:, 1].mean())) |
⚠️ 落とし穴(重要) — 実測が示す 8 つの罠
🚀 発展 — 機構別の適切手法と検証
| 欠損機構 | 推奨手法 | 不偏か |
|---|---|---|
| MCAR(完全ランダム) | 削除でも代入でも可。 標本数を惜しむなら MICE/KNN | ◎ |
| MAR(観測変数依存) | 多重代入(MICE)/最尤法(FIML)/IPW — 欠損を予測する観測変数を必ずモデルに含める | ◎(適切手法で) |
| MNAR(欠測値自体に依存) | 選択モデル/パターン混合モデル+感度分析必須 | △(仮定依存) |
- 多重代入(MICE):予測値に乱数残差を足し、 それを m 回(5〜20 回)繰り返して m 個のデータセットを作り、 各々で推定して Rubin の合成則で統合する。 上表の実測どおり SD・相関を真値付近に保てる。 scikit-learn では
IterativeImputer。 - 最尤法(FIML):補完値を作らず、 観測部分の尤度を直接最大化する。 MAR の下で多重代入と漸近的に同等。 EM の詳細は EM アルゴリズム を参照。
- 代入の不確実性を反映する:単一代入は「補完値=真値」と誤認するので、 区間推定では多重代入で within/between 分散を合成し、 予測区間を適正な幅に広げる。
- 欠損パターンの可視化:
missingno.matrix / heatmapで「どの列がどの行で同時に欠けるか」を俯瞰し、 共起パターンから機構を推理する。 補完前の必須ステップ。 - 感度分析:「もし MNAR だったら結論はどう変わるか」を、 補完値に系統的なオフセット(δ 調整)を加えて再推定する形で検証し、 結論の頑健性を報告する。 MNAR への唯一の防御。
- 近傍・木ベースの補完:k 近傍法(KNN 補完) や MissForest は多変量の関係を活かす。 補完後の残差検証は 残差 を参照。
🔗 関連ページ
- 欠損メカニズム(MCAR/MAR/MNAR) — 機構の定義と判定
- データクリーニング/データクリーニング(詳細) — 前処理全体での位置づけ
- 選択バイアス — 非ランダム欠損が生むバイアス
- ばらつき — 平均代入が縮める分散の意味
- k 近傍法(KNN 補完)/EM アルゴリズム/多重回帰/残差 — 補完手法とその検証
- 補完(imputation)専用ページ・データ品質(data quality)専用ページは本教材に未収録。 補完は本ページの「代入法」節、 データ品質は データクリーニングで扱う。