🔖 キーワード索引
「multiple comparisons」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「multiple comparisons」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「multiple comparisons の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
間違いを防ぐための調整ルールです。
偶然の正解を減らすために使います。
多くの部活から1つだけ選ぶときのような状況です。
具体的な調整の方法について読みましょう。
- 問題:同じデータで複数の検定を行うと、 偶然「有意」が出る確率(第 1 種過誤)が 累積 していく。 5% の検定を 20 回繰り返すと、 1 回以上偽陽性が出る確率は約 64%。
- 対策:Bonferroni 補正($\alpha/m$)、 Holm 法、 BH 法(FDR 制御) などで有意水準を調整。
- SSDSE 例:47 都道府県を 8 地方ブロックに分け、 すべてのペア(28 通り)で平均所得の差を検定 → Bonferroni で $\alpha=0.05/28=0.0018$ に。
- 本質:FWER(家族全体の誤り率)か FDR(偽発見率)の どちらを抑えたいか で手法が変わる。
- 注意:検定回数を「実際にやった分」だけでなく「事前計画分」も数える。 探索的解析では FDR が現実的。
📍 あなたが今見ているもの
🍰 まずはやさしく
たくさんの検定をまとめて行う技術です。
間違いが増えすぎるのを防ぐために使います。
多くの都道府県の年収を比べる時に役立ちます。
これから使う補正の手法について学びます。
多重比較 は、 複数の検定を同時に行うときに 偽陽性が増えすぎないように する技術です。 SSDSE-B-2026 で「47 都道府県の平均年収はすべて等しいか?」を調べるには $\binom{47}{2}=1081$ 通りのペア検定が必要。 すべて $\alpha=0.05$ で行うと約 54 回の偽陽性が予想されます。 そこで Bonferroni / Holm / BH 補正の出番です。
🎨 直感で掴む
🍰 まずはやさしく
魚を獲る網の目を細かくするイメージです。
偶然起きただけの結果を除外するために使います。
コイン投げを何度も繰り返す状況に似ています。
なぜ間違いが増えるのかを直感的に理解しましょう。
イメージ 1: コイン投げ。 イカサマでないコインを 20 回投げて表が連続する回数を数える。 各回 5% の確率で「偶然の連続」が起きるとすると、 20 回繰り返せばどこかで起きる確率は $1-(1-0.05)^{20}=0.64$。 「20 個のうち少なくとも 1 個有意」は普通に起こる。
イメージ 2: 47 都道府県の比較。 同じ平均所得の架空データで全ペア検定すると、 約 54 ペアが「有意差あり」と出る。 偽陽性の山。 これを防ぐのが多重比較補正。
イメージ 3: 検定の網。 検定を「魚を獲る網」と考えると、 網目($\alpha$)が広いと小魚(偽陽性)も大量に獲れる。 補正は網目を細かくすること。
📐 数式による定義
🍰 まずはやさしく
間違いの確率を数式で決めるルールです。
正しく判定するための基準を作るために使います。
スマホのアプリをたくさん比べる時に似ています。
代表的な計算方法と使い分けについて読みましょう。
$m$ 個の検定 $H_{01}, \ldots, H_{0m}$ について、 観測される p 値を $p_1, \ldots, p_m$ とする。 家族全体の誤り率(FWER):
$$ \mathrm{FWER} = P(\text{1 つ以上偽陽性}) $$偽発見率(FDR):
$$ \mathrm{FDR} = E\left[\frac{\#\text{偽陽性}}{\max(\#\text{陽性},1)}\right] $$主要な補正法:
- Bonferroni:$p_i \le \alpha/m$ なら棄却。 FWER ≤ $\alpha$ を保証。 厳しすぎる。
- Holm:p 値を昇順に並べ、 順に $\alpha/(m-i+1)$ と比較。 Bonferroni より検出力高い。
- Benjamini-Hochberg(BH):$p_{(i)} \le i\alpha/m$ で FDR を $\alpha$ 以下に制御。
- Tukey HSD:分散分析後の全ペア比較に特化。
- Dunnett:1 つの対照群と複数群の比較に特化。
📐 検定数と偽陽性確率の関係
独立な検定を $m$ 回行い、 各検定で $\alpha=0.05$ なら、 1 つでも誤って棄却する確率は $1-(0.95)^m$。 具体的に:
| 検定数 $m$ | 補正なし FWER | Bonferroni 後の単発 $\alpha$ |
|---|---|---|
| 1 | 5.0% | 0.0500 |
| 5 | 22.6% | 0.0100 |
| 10 | 40.1% | 0.0050 |
| 20 | 64.2% | 0.0025 |
| 50 | 92.3% | 0.0010 |
| 100 | 99.4% | 0.0005 |
| 1081(47 県全ペア) | ≈100% | 0.000046 |
SSDSE で 47 都道府県をペア比較するなら、 補正なしでは偽陽性をほぼ確実に拾います。 ANOVA か Tukey HSD で群として比較してから個別差を見るのが定石。
❓ よくある質問
Q1. Bonferroni と Holm のどちらを使うべき?
Holm が常に Bonferroni 以上の検出力を持つので、 FWER 制御では Holm が推奨。 Bonferroni は説明のしやすさで使われる。
Q2. FDR は p 値の何 % なら採用?
FDR=0.05 は「陽性の 5% は偽陽性かもしれない」という意味。 ゲノミクスでは 0.1 が一般的。 確証的なら 0.05、 探索的なら 0.1-0.2 が許容。
Q3. 検定が相関している場合は?
Bonferroni は保守的(過剰補正)になる。 並べ替え検定(ベースが同じ群を共有する場合)や Westfall-Young 法が推奨。
Q4. ベイズ的アプローチは多重比較問題を回避できる?
階層モデルで「縮約」が自動的に起きるため、 多重比較の問題が緩和される。 ただし事前分布の選び方で結果が変わる点に注意。
Q5. 「事前計画」と「探索的」の境界は?
プレレジ(pre-registration)で「これとこれを検定する」と宣言したものは事前計画。 後から「気になった」検定はすべて探索的とカウントすべき。
🧷 学習チェックリスト
- □ 第 1 種過誤の累積を $1-(1-\alpha)^m$ で計算できる
- □ FWER と FDR の違いを説明できる
- □ Bonferroni $\alpha/m$ の意味と限界を言える
- □ Holm の step-down 手順を実行できる
- □ BH の step-up 手順と $i\alpha/m$ を理解
- □ Tukey HSD と Dunnett の使い分けが分かる
- □ SSDSE-B で都道府県ブロック比較を実装できる
- □ 事前計画と探索的解析の区別ができる
- □ 効果量と統計的有意性を区別できる
- □ statsmodels の
multipletestsを活用できる
🛠 多重比較でハマるポイント
- 検定数のカウントミス:探索的に試した検定を全部数える。 報告したものだけではない。
- 独立性の仮定:Bonferroni は独立検定で最適。 相関があると過保守。
- p 値の桁落ち:補正後の p 値が
0や1に丸まることがある。 raw 値も残す。 - サンプル数の少なさ:群あたり 5 未満では多重比較以前に検定の検出力不足。
- 分散の等質性:t 検定では分散等しさを仮定する場合と Welch の場合で結果が変わる。
- 正規性の仮定:違反するなら並べ替え検定や Kruskal-Wallis に切り替える。
📐 多重比較の数理:ブール束と確率不等式
Bonferroni 不等式
$$\Pr\left(\bigcup_{i=1}^m A_i\right)\le \sum_{i=1}^m \Pr(A_i)$$
$A_i$ を「$i$ 番目の検定が偽陽性」とすると、 すべての検定の少なくとも 1 つが偽陽性となる確率は、 各検定の偽陽性確率の和で上から押さえられる。 これが Bonferroni 補正の根拠。 各 $\Pr(A_i)\le \alpha/m$ なら、 全体の FWER は $\le \alpha$。
Šidák 不等式
$$\Pr\left(\bigcup_{i=1}^m A_i\right) = 1-\prod_{i=1}^m (1-\Pr(A_i))\quad\text{(独立時)}$$
検定が独立なら厳密等式が成立。 これを使って $\alpha_i=1-(1-\alpha)^{1/m}$ と補正すれば FWER 制御できる。 Bonferroni より緩い(高検出力)。
BH 法の FDR 制御証明
Benjamini & Hochberg (1995) は、 $p$ 値が一様分布(帰無下)に従い、 互いに独立または PRDS(positive regression dependent on subset)であれば、 BH 法が FDR を $\le m_0\alpha/m \le \alpha$ に制御することを証明($m_0$ は真の帰無仮説の数)。
🎓 Tukey HSD(Honestly Significant Difference)
ANOVA で「群間に差がある」と判定された後、 どの群とどの群に差があるか を特定する事後検定の標準。 平均値差を スチューデント化範囲分布 で評価する。
$$q = \frac{|\bar{X}_i - \bar{X}_j|}{\sqrt{MS_W/n}}$$
$MS_W$ は群内平均平方、 $n$ は群サイズ。 すべてのペアで $q$ を計算し、 スチューデント化範囲分布の臨界値と比較。 SSDSE-B-2026 で 8 地方ブロックの所得を ANOVA 後 Tukey HSD で事後比較するのが定番。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | from statsmodels.stats.multicomp import pairwise_tukeyhsd import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 年度の列名は 'SSDSE-B-2026'(skiprows=[1] で読んだ場合) latest = df.sort_values('SSDSE-B-2026').groupby('Prefecture').tail(1) # income_pc / region という列は SSDSE-B-2026 に無いので、実在列から作る def _region(code): n = int(str(code).lstrip('R')) // 1000 if n == 1: return '北海道' if n <= 7: return '東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' latest = latest.assign(region=latest['Code'].apply(_region), income_pc=latest['L3221'].astype(float)) result = pairwise_tukeyhsd(latest['income_pc'], latest['region'], alpha=0.05) print(result.summary()) |
🔬 数式を言葉で読み解く
| 記号 | 意味 |
|---|---|
| $m$ | 検定の総数 |
| $\alpha$ | 名目有意水準(通常 0.05) |
| $\alpha/m$ | Bonferroni 補正後の閾値 |
| $p_{(i)}$ | 昇順で $i$ 番目の p 値 |
| FWER | 1 つ以上偽陽性が出る確率 |
| FDR | 陽性のうち偽陽性の期待比率 |
| $V$ | 偽陽性の数 |
| $R$ | 陽性総数 |
🔬 数式を言葉で読み解く(500 字超)
多重比較の中心公式を、 記号と意味を一つひとつ言葉で訳します。
Bonferroni:$p^*_i = \min(m\cdot p_i, 1)$。 $p^*_i$ は補正後の $p$ 値、 $m$ は全検定数、 $p_i$ は補正前の $p$ 値。 「全部の検定数で $p$ 値を 掛け算 する」。 ただし 1.0 を超えないようにクリップ。 これは「複数検定の重ね合わせで広がる偽陽性を、 単純に $m$ 倍だけ厳しくする」発想。
Holm:$p$ 値を昇順 $p_{(1)}\le p_{(2)}\le\ldots\le p_{(m)}$ に並べ、 $i$ 番目には $(m-i+1)$ 倍。 つまり最小の $p$ 値は $m$ 倍、 次は $(m-1)$ 倍、 …。 段階的に緩める。 これにより小さい $p$ 値を「強い証拠」として優先しつつ、 全体の FWER を $\alpha$ に抑えます。
Benjamini-Hochberg:$p$ 値昇順 $p_{(1)}\le\ldots\le p_{(m)}$ で、 $p_{(i)}\le \frac{i\alpha}{m}$ を満たす 最大の $i$ までを有意とする。 これは「期待される偽発見率を $\alpha$ 以下に制御する」アルゴリズム。 ゲノム解析で 1 万件の検定を同時に行うとき、 Bonferroni では何も検出できないが、 BH なら数百件の有意発見が可能。
これらの方法の核心は、 「複数検定で増える偽陽性」を確率論的に押さえ込む こと。 Bonferroni は単純粗削り、 Holm は smarter、 BH は探索向き、 と性格が異なります。 「どの状況でどの方法が最適か」を判断するのが分析者の腕の見せ所。
FWER(family-wise error rate)の定義は $\text{FWER}=\Pr(\text{少なくとも 1 つの真の}H_0\text{を棄却})$。 FDR(false discovery rate)の定義は $\text{FDR}=E[\text{偽陽性数}/\max(\text{有意とした数},1)]$。 SSDSE-B-2026 で 8 地方ブロックを Bonferroni(FWER 制御)で比較する具体例を「⑦ SSDSE-B-2026 で実値計算」セクションに示してあります。
🧮 SSDSE-B-2026 で実値計算
「8 地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)の平均所得に差があるか?」をペアで検定すると、 $\binom{8}{2}=28$ 通り。 仮に各検定で p 値が以下のように出たとします。
| ペア | p 値 | $\alpha=0.05$ で有意? | Bonferroni ($\alpha/28=0.00179$) | BH (FDR=0.05) |
|---|---|---|---|---|
| 関東-東北 | 0.0003 | ○ | ○ | ○ |
| 関東-中国 | 0.0012 | ○ | ○ | ○ |
| 関東-四国 | 0.018 | ○ | × | ○ |
| 近畿-九州沖縄 | 0.034 | ○ | × | × |
| 中部-中国 | 0.041 | ○ | × | × |
Bonferroni は厳しく 2 ペアのみ通過。 BH は 3 ペア。 「関東 vs 東北・中国・四国」だけが堅実な差として残ります。
🧮 BH (FDR) 法を手計算で追う
同じ 5 つの p 値で BH 法($\alpha=0.05$、 $m=5$)。 BH は step-up:大きい p から順に閾値 $i\alpha/m$ と比較し、 一度通れば以下すべて棄却。
| 順位 $i$ | $p_{(i)}$ | 閾値 $i\alpha/m$ | 通る? |
|---|---|---|---|
| 5 | 0.052 | 0.050 | × |
| 4 | 0.039 | 0.040 | ○ |
$i=4$ で初めて閾値以下になったので、 上位 4 個($p \le 0.039$)すべて棄却。 Holm では 2 個、 BH では 4 個 — FDR は明らかに緩い。
🧮 Holm 法を手計算で追う
5 つの p 値を $\{0.001, 0.012, 0.025, 0.039, 0.052\}$、 $\alpha=0.05$、 $m=5$ で考えます。 Holm は step-down:小さい p から順に、 「残りの数」で割って比較。
| 順位 $i$ | $p_{(i)}$ | 閾値 $\alpha/(m-i+1)$ | 判定 |
|---|---|---|---|
| 1 | 0.001 | 0.05 / 5 = 0.010 | ○ 棄却 |
| 2 | 0.012 | 0.05 / 4 = 0.0125 | ○ 棄却 |
| 3 | 0.025 | 0.05 / 3 = 0.0167 | × 停止 |
| 4-5 | — | — | ×(すべて非棄却) |
Bonferroni なら閾値は一律 0.01 だったので、 1 個目だけ棄却。 Holm は 2 個まで通せる分、 検出力が高い。
🧮 SSDSE-B-2026:4 シナリオでの多重比較
SSDSE-B-2026 を題材に、 異なる検定数・補正法での結果を比較します。
シナリオ A:8 地方ブロックの所得差
「北海道・東北・関東・中部・近畿・中国・四国・九州沖縄」の人口当たり課税対象所得。 ANOVA で全体差を検定、 有意なら Tukey HSD で事後比較。 ペア数 $\binom{8}{2}=28$。 Bonferroni 補正後 $\alpha=0.05/28\approx 0.0018$。
シナリオ B:47 都道府県の総当たり
47 都道府県をすべて 2 つずつ比較。 ペア数 $\binom{47}{2}=1081$。 Bonferroni 補正後 $\alpha=0.05/1081\approx 4.6\times 10^{-5}$。 ほとんどの差が見えなくなる。 探索的なら BH 法が現実的。
シナリオ C:複数指標の一括検定
「人口総数」「課税対象所得」「保育所定員数」「合計特殊出生率」「平均寿命」「老年人口割合」の 6 指標について、 「東京とその他 46 県」の差を一括検定。 検定数 6。 Bonferroni $\alpha=0.05/6\approx 0.0083$。
シナリオ D:年次データの大量検定
2018-2023 の各年について「都市圏 vs 地方圏」の所得差を検定。 検定数 6。 各年で有意か、 累積で「いずれかの年で有意」か。 累積検定なら Bonferroni $\alpha=0.05/6$、 BH なら個別に補正後 $p$ 値が小さいものから順に判定。
🧮 数式に値を入れて手で計算する: ペアワイズ比較数
合成データで k 群のペア比較数を計算する。
Step 1: 群数別の比較数
| k | C(k,2) |
|---|---|
| 3 | 3 |
| 5 | 10 |
| 10 | 45 |
| 20 | 190 |
Step 2: 公式と Bonferroni
🐍 Python で再現
1 2 3 4 | from math import comb ks = [3, 5, 10, 20] for k in ks: print(f"k={k}: ペア数 = {comb(k, 2)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🎮 触って理解する ― 群数 k とペア比較の格子
スライダーで群数 $k$ を 2〜10 に動かすと、 全ペア比較の本数 $m = k(k-1)/2$ が「格子図(完全グラフ)」でどう爆発するかを体感できます。 使用データはデモ用の架空データです(10 群 × 各 8 観測。 真の平均を G3=52、 G5=55、 G8=53、 G10=58 とし、 残り 6 群は真の平均 50 の同一母集団から生成。 標準偏差はすべて 3)。 SSDSE の実測値ではありません。 各ペアで Welch の t 検定を行い、 選択した判定法(無補正 / Bonferroni / Holm、 いずれも $\alpha=0.05$)で「有意」となった辺が赤く塗られます。 辺をタップまたはマウスオーバーすると、 そのペアの p 値と 3 法の判定が見られます。
※ 観測値は乱数シード固定で生成した架空データ(真の平均が既知)。 p 値は Welch–Satterthwaite の自由度と t 分布 CDF(不完全ベータ関数)で計算しています。
💡 直感 ― ペア数は k の「2 乗」で爆発する
格子図の辺の本数 $m=k(k-1)/2$ は $k$ にほぼ 2 乗で比例します。 $k=4$ なら 6 本、 $k=8$ なら 28 本、 $k=10$ なら 45 本 —— 群数を 2 倍強にしただけで比較の本数は約 7.5 倍。 47 都道府県の総当たりなら $\binom{47}{2}=1081$ 本です。 Bonferroni の閾値 $\alpha/m$ はこの $m$ に反比例して縮むので、 $k=8$ で $0.05/28 \approx 0.00179$、 $k=10$ で $0.05/45 \approx 0.00111$。 スライダーを右に動かすほど「1 ペアあたりに要求される証拠の強さ」が急激に上がっていくのが、 統計量の表ではなく絵として見えるはずです。 逆に補正しなければ、 全帰無仮説が真でも独立仮定の理論値で $1-0.95^{28}=76.2\%$($k=8$)、 $1-0.95^{45}=90.1\%$($k=10$)の確率でどこかの辺が偽って赤くなります(膨張曲線そのものの数値実験は姉妹ページ多重検定のシミュレーションで確認できます)。
⚠️ 落とし穴 ― Bonferroni の保守性と Holm の優位
上のデモで $k=8$ にすると、 未補正では 13 ペアが有意なのに、 Bonferroni では 6 ペア、 Holm では 8 ペアに減ります($k=10$ では 25 → 10 → 11)。 同じ FWER 保証を持つのに Holm の方が常に多く検出できるのが見どころで、 Bonferroni を積極的に選ぶ理由が「説明のしやすさ」以外にないことが体感できます。 Bonferroni が保守的になる理由は 2 つ。 第一に、 Boole の不等式による「最悪ケースの上界」で閾値を決めるため、 実際の FWER は $\alpha$ よりかなり小さくなりがち。 第二に、 ペア比較では「G1-G2」と「G1-G3」のように同じ群を共有する検定同士が相関するため、 独立を仮定した補正は過剰に厳しくなります。 なお、 この架空データでは未補正で有意になった辺はすべて「真の差を仕込んだペア」でしたが、 現実の分析ではどれが偽陽性か事前に分からないのが本質的な困難です。 補正は「検出力(検出力)を保険料として支払い、 偽陽性の暴走を防ぐ」トレードオフだと理解してください。 差の実質的な大きさは効果量で必ず併記を。
🚀 発展 ― Tukey HSD・Holm・FDR への広がり
このデモの「全ペア t 検定 + p 値補正」は最も素朴な構成です。 実務ではさらに 3 方向の発展があります。 ① Tukey HSD:分散分析(ANOVA)の後の全ペア比較に特化し、 スチューデント化範囲分布で「ペア検定同士の相関構造」を織り込むため、 Bonferroni 型より検出力が高い。 群サイズが等しい設計での事後検定の第一選択です。 ② Holm:分布の仮定を一切追加せずに Bonferroni を一様に改良する step-down 法。 迷ったら FWER 制御のデフォルトにしてよい。 ③ FDR 制御(Benjamini-Hochberg):ペア数が数百〜数千に膨れる探索的分析では、 FWER ではなく「有意とした中の偽陽性割合」を抑える発想に切り替えます。 BH 法の step-up 手順と q 値の読み方はFDR(偽発見率)のページで、 検定数と偽陽性の膨張そのものは多重検定のページで扱っています。 本ページの格子図(=ペア数の幾何的爆発)と合わせて 3 ページで一組の教材です。
🐍 Python 実装
例 1: 都道府県を地方ブロックに分けて全ペア比較。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from itertools import combinations from scipy.stats import ttest_ind df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # 日本語の列名で読む(2 行目を見出しにする) df = df[df['年度'] == 2023].reset_index(drop=True) # 同じ県が 12 回入らないよう 1 年に絞る region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州' } df['地方'] = df['都道府県'].map(region_map) # 可処分所得の列は SSDSE-B-2026 に無いので、消費支出で代える col = '消費支出(二人以上の世帯)' groups = df.groupby('地方')[col].apply(list) regions = list(groups.index) results = [] for a, b in combinations(regions, 2): t, p = ttest_ind(groups[a], groups[b], equal_var=False) results.append((a, b, p)) res = pd.DataFrame(results, columns=['地方A','地方B','p']) print(res.sort_values('p').head()) |
例 2: Bonferroni 補正と Holm 補正。
1 2 3 4 5 6 7 8 9 | from statsmodels.stats.multitest import multipletests reject, p_adj, _, _ = multipletests(res['p'].values, alpha=0.05, method='bonferroni') res['p_bonf'] = p_adj res['有意_bonf'] = reject reject, p_adj, _, _ = multipletests(res['p'].values, alpha=0.05, method='holm') res['p_holm'] = p_adj res['有意_holm'] = reject |
例 3: Benjamini-Hochberg(FDR)補正。
1 2 3 4 5 6 7 8 | reject, p_adj, _, _ = multipletests(res['p'].values, alpha=0.05, method='fdr_bh') res['p_bh'] = p_adj res['有意_bh'] = reject print('生 0.05 で有意:', (res['p'] < 0.05).sum()) print('Bonferroni:', res['有意_bonf'].sum()) print('Holm :', res['有意_holm'].sum()) print('BH (FDR) :', res['有意_bh'].sum()) |
例 4: 分散分析 → Tukey HSD。
1 2 3 4 | from statsmodels.stats.multicomp import pairwise_tukeyhsd tukey = pairwise_tukeyhsd(df[col].values, df['地方'].values, alpha=0.05) print(tukey.summary()) |
🐍 Python:SSDSE-B-2026 で Bonferroni vs Holm vs BH
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 | import pandas as pd import numpy as np from scipy import stats from statsmodels.stats.multitest import multipletests df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 年度の列名は 'SSDSE-B-2026'(skiprows=[1] で読んだ場合) latest = df.sort_values('SSDSE-B-2026').groupby('Prefecture').tail(1) # 地方ブロックを定義 regions = { '北海道': ['北海道'], '東北': ['青森県','岩手県','宮城県','秋田県','山形県','福島県'], '関東': ['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'], '中部': ['新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'], '近畿': ['三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県'], '中国': ['鳥取県','島根県','岡山県','広島県','山口県'], '四国': ['徳島県','香川県','愛媛県','高知県'], '九州沖縄': ['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'] } # 各県を地方に紐づけ def region_of(p): for r, ps in regions.items(): if p in ps: return r return None latest['region'] = latest['Prefecture'].apply(region_of) # 課税対象所得・人口総数という列は SSDSE-B-2026 に無いので、 # 1 世帯あたり消費支出(L3221)をそのまま使う latest['income_pc'] = latest['L3221'].astype(float) # 全 28 ペアの t 検定 region_list = list(regions.keys()) pvalues = [] labels = [] for i in range(len(region_list)): for j in range(i+1, len(region_list)): a = latest[latest['region'] == region_list[i]]['income_pc'] b = latest[latest['region'] == region_list[j]]['income_pc'] if len(a) > 1 and len(b) > 1: t, p = stats.ttest_ind(a, b) pvalues.append(p) labels.append(f'{region_list[i]}-{region_list[j]}') # 3 つの補正法 for method in ['bonferroni', 'holm', 'fdr_bh']: rej, p_corr, _, _ = multipletests(pvalues, alpha=0.05, method=method) n_signif = sum(rej) print(f'{method}: 有意ペア数 = {n_signif}/{len(pvalues)}') # 出力例 # bonferroni: 有意ペア数 = 5/28 # holm: 有意ペア数 = 7/28 # fdr_bh: 有意ペア数 = 12/28 |
同じデータで Bonferroni と BH の間に 7 ペアの差。 「FWER と FDR、 どちらを制御するか」は単なる技術選択でなく 研究目的の選択。
📊 7 つの補正法を一覧で
| 補正法 | 制御指標 | 検出力 | 推奨場面 |
|---|---|---|---|
| Bonferroni | FWER | 低 | 確認的、 少数の検定 |
| Holm | FWER | 中 | Bonferroni の代替(常に優位) |
| Hochberg | FWER | 中 | 独立な検定 |
| Šidák | FWER | 中 | 独立な検定 |
| Benjamini-Hochberg (BH) | FDR | 高 | 探索的、 多数の検定 |
| Benjamini-Yekutieli (BY) | FDR | 中 | 従属検定でも保守的 |
| Tukey HSD | FWER | 中 | ANOVA 後の事後比較 |
🐍 Python:FDR と q 値
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import numpy as np from statsmodels.stats.multitest import multipletests from scipy import stats # シミュレーション:100 個の検定、 うち 20 個が真に有意 n_tests = 100 true_effects = np.zeros(n_tests) true_effects[:20] = 0.5 p_values = [] for effect in true_effects: data = np.random.normal(loc=effect, scale=1.0, size=30) t, p = stats.ttest_1samp(data, 0) p_values.append(p) # 補正前 print(f'補正前: 有意数 = {sum(p < 0.05 for p in p_values)}') # Bonferroni rej, p_bonf, _, _ = multipletests(p_values, alpha=0.05, method='bonferroni') print(f'Bonferroni: 有意数 = {sum(rej)}') # Holm rej, p_holm, _, _ = multipletests(p_values, alpha=0.05, method='holm') print(f'Holm: 有意数 = {sum(rej)}') # BH (FDR) rej, p_bh, _, _ = multipletests(p_values, alpha=0.05, method='fdr_bh') print(f'BH (FDR): 有意数 = {sum(rej)}') # 真の効果数 20 のうち、 BH が検出できる数を確認 |
📜 多重比較の歴史 — 主要マイルストーン
- 1936:R.A. フィッシャー『The Design of Experiments』── 多重検定の問題意識を提起
- 1949:Bonferroni 不等式(イタリアの数学者カルロ・エミリオ・ボンフェローニ、 1936 出版)が統計に応用される
- 1953:Tukey が HSD を提案
- 1955:Dunnett が「対照群との比較」専用検定を提案
- 1979:Holm が段階的補正を提案 — Bonferroni の改良版
- 1988:Hochberg が逆方向 step-up 法を提案
- 1995:Benjamini-Hochberg が FDR を提案 — 大規模検定時代の幕開け
- 2002:Storey が $q$ 値を提案 — BH の連続的精緻化
- 2010s:再現性危機を受け、 心理学・医学で補正の徹底が再評価される
- 2020s:機械学習・ゲノム・脳科学で BH が標準化
✅ 学習チェックリスト
- □ 多重比較問題が起こる理由を説明できる($0.95^m$ の話)
- □ FWER と FDR の違いを言える
- □ Bonferroni・Holm・BH の式を書ける
- □ Tukey HSD が ANOVA 後に使われる理由を理解している
- □ Python で statsmodels.multitest を使って補正できる
- □ SSDSE-B-2026 で 8 地方ブロックの多重比較を実行できる
- □ 補正法の選択を結果見てから変えない(事前登録)
- □ 効果量・信頼区間を $p$ 値と併記する
- □ 探索的か確認的かを明示できる
- □ 大規模検定(ゲノム等)では BH 法が標準と知っている
📝 レポート用テンプレート
本研究では SSDSE-B-2026 を用い、 47 都道府県を 8 地方ブロックにまとめ、
人口当たり課税対象所得の地方間差を分析した。 まず一元配置 ANOVA で全体差を
検定 (F=[値], df=[値], p<[値])、 有意であったため事後の対比較を実施した。
ペア数 28、 補正法は研究目的(確認的)に鑑み Holm 法を採用した。 補正後の
有意水準を満たしたペアは [N] 件であり、 効果量 Cohen's d は [値] 〜 [値] の
範囲であった。 比較ペアと補正前後の $p$ 値、 95% 信頼区間を補表 1 に示す。
事前登録の関係上、 BH 法 (FDR) は感度分析として併用し、 結論の頑健性を
確認した。 探索的所見は補表 2 で報告した。
🔗 同カテゴリ(仮説検定)の用語
- 仮説検定 — 全体俯瞰
- p 値 — 補正対象
- 帰無仮説
- 対立仮説
- 信頼区間
- 効果量
- 分散分析(ANOVA)
- χ² 検定
- Kruskal-Wallis 検定
📖 さらに学ぶための文献
- Y. Benjamini & Y. Hochberg『Controlling the false discovery rate』JRSS-B (1995) — 原著
- S. Holm『A simple sequentially rejective multiple test procedure』Scand J Stat (1979) — Holm 法
- R.G. Miller『Simultaneous Statistical Inference』2nd ed., Springer — 古典的教科書
- Y. Hochberg & A.C. Tamhane『Multiple Comparison Procedures』Wiley
- 『統計的多重比較法の基礎』永田靖, 吉田道弘, サイエンス社 — 日本語名著
- 『現代数理統計学』竹村彰通, 学術図書 — 多重比較章
- NIH の Statistical Considerations — 医学研究での多重比較ガイドライン
🐍 Python 実装 ―― SSDSE-B-2026 で多重比較補正を実機実行
📐 数式と 🔬 数式を言葉で読み解く ―― FWER と FDR
$m$ 個の仮説を同時に検定するとき、 「少なくとも 1 つの偽陽性が出る確率」 が family-wise error rate (FWER)、 「棄却された仮説中の偽陽性割合の期待値」が false discovery rate (FDR):
$$\text{FWER} = \Pr\left(\bigcup_{i=1}^m \{ \text{$H_i$ を誤って棄却} \}\right), \quad \text{FDR} = E\!\left[\frac{V}{\max(R, 1)}\right].$$ここで $V$ は偽陽性数、 $R$ は棄却した総仮説数。 検定数 $m$、 各検定の有意水準 $\alpha$ のとき、 ナイーブには FWER $\le 1 - (1-\alpha)^m \approx m\alpha$(独立仮定)と急増します。
🔬 数式を言葉で読み解く:左辺の FWER は「全 $m$ 検定のうち 1 つでも偽陽性を出す確率」で、 確認的研究(薬の効果の最終判定など)で守るべき指標。 右辺の FDR は「棄却した中の偽陽性割合」で、 探索的研究(数千遺伝子のスクリーニングなど)で守るべき指標。 47 県の総当たり比較 $\binom{47}{2} = 1081$ ペア検定では $m=1081$ なので、 $\alpha=0.05$ なら平均 54 個の偽陽性が出る。 これでは「有意な差がある」と言える検定が無価値になってしまう。 補正が必要な理由が直感できる数字です。
🧮 実値で計算してみる ―― SSDSE-B-2026 8 地方ブロックの総人口平均比較
このコードでやること:47 都道府県を 8 地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分類し、 ブロック間の総人口の差を全 $\binom{8}{2} = 28$ ペアで t 検定。 Bonferroni / Holm / Benjamini-Hochberg(BH)の 3 補正を比較します。
📥 入力データ(地方ブロック割り当ての先頭 3 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 | import numpy as np import pandas as pd from scipy.stats import ttest_ind from statsmodels.stats.multitest import multipletests from itertools import combinations df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 8 地方ブロック割り当て block_map = { '北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東', '新潟県': '中部', '富山県': '中部', '石川県': '中部', '福井県': '中部', '山梨県': '中部', '長野県': '中部', '岐阜県': '中部', '静岡県': '中部', '愛知県': '中部', '三重県': '近畿', '滋賀県': '近畿', '京都府': '近畿', '大阪府': '近畿', '兵庫県': '近畿', '奈良県': '近畿', '和歌山県': '近畿', '鳥取県': '中国', '島根県': '中国', '岡山県': '中国', '広島県': '中国', '山口県': '中国', '徳島県': '四国', '香川県': '四国', '愛媛県': '四国', '高知県': '四国', '福岡県': '九州沖縄', '佐賀県': '九州沖縄', '長崎県': '九州沖縄', '熊本県': '九州沖縄', '大分県': '九州沖縄', '宮崎県': '九州沖縄', '鹿児島県': '九州沖縄', '沖縄県': '九州沖縄', } df['地方ブロック'] = df['Prefecture'].map(block_map) blocks = ['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州沖縄'] # 全 28 ペアで t 検定 pvals, pairs = [], [] for a, b in combinations(blocks, 2): x = df.loc[df['地方ブロック'] == a, 'A1101'] y = df.loc[df['地方ブロック'] == b, 'A1101'] if len(x) >= 2 and len(y) >= 2: _, p = ttest_ind(x, y, equal_var=False) pvals.append(p) pairs.append(f'{a} vs {b}') m = len(pvals) print(f'検定数 m = {m}') print(f'未補正で有意 (p < 0.05) = {sum(p < 0.05 for p in pvals)} 個') for method in ['bonferroni', 'holm', 'fdr_bh']: reject, p_adj, _, _ = multipletests(pvals, alpha=0.05, method=method) print(f'{method:>12} で有意 = {reject.sum()} 個') |
📤 実行例(実値):
💬 結果の読み方:未補正なら 28 ペア中 8 ペアが有意ですが、 「$\alpha = 0.05$ × 28 = 1.4 個」の偽陽性が混じっている可能性。 厳格な FWER 制御(Bonferroni / Holm)では 2 ペアまで縮減、 緩めの FDR 制御(BH)では 5 ペア残ります。 「関東 vs 四国」「関東 vs 北海道」のような巨大都市圏 vs 小規模ブロックの差は補正後も生き残り、 「東北 vs 中部」のような中規模どうしの差は補正で消えます。 確認的な政策提言なら Bonferroni/Holm、 探索的な仮説生成なら BH を使い分けます。
🐍 Python 実装 ―― FWER を補正法ごとにシミュレーションで検証
このコードでやること:「真の差が存在しない」帰無分布のもとで、 未補正 / Bonferroni / Holm / BH の各補正法が実際に FWER を $0.05$ 以下に抑えられているかを 5000 回のモンテカルロで確認。 SSDSE のような有限標本での挙動を実証します。
📥 入力データ:標準正規分布から 8 群 × 5 サンプルを生成し(真の差なし)、 28 ペアの t 検定を行う。 5000 反復で「少なくとも 1 つの偽陽性」率を測定。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np from scipy.stats import ttest_ind from statsmodels.stats.multitest import multipletests from itertools import combinations rng = np.random.default_rng(2026) n_groups, n_sample, n_sim = 8, 5, 5000 fwer_counts = {'naive': 0, 'bonferroni': 0, 'holm': 0, 'fdr_bh': 0} for _ in range(n_sim): data = [rng.standard_normal(n_sample) for _ in range(n_groups)] pvals = [ttest_ind(data[i], data[j]).pvalue for i, j in combinations(range(n_groups), 2)] if any(p < 0.05 for p in pvals): fwer_counts['naive'] += 1 for method in ['bonferroni', 'holm', 'fdr_bh']: reject, _, _, _ = multipletests(pvals, alpha=0.05, method=method) if reject.any(): fwer_counts[method] += 1 print(f'n_sim = {n_sim}、 検定数 = {n_groups * (n_groups-1) // 2} FWER(少なくとも 1 個 偽陽性)の実測値:') for method, cnt in fwer_counts.items(): print(f' {method:>10}: {cnt/n_sim:.3f}') |
📤 実行例(実値):
💬 結果の読み方:未補正だと「真の差ゼロ」のデータでも 68.2% の確率で 1 個以上の偽陽性が出ます。 これが多重比較問題の核心。 すべての帰無仮説が真(完全帰無)のこのシミュレーションでは、 Bonferroni・Holm だけでなく BH も FWER を約 5% に抑えます(実測 4.7% / 4.9% / 5.0%)。 これは理論通りで、 完全帰無下では偽発見率 FDR と FWER が一致する(棄却はすべて偽陽性なので $\mathrm{FDR}=\Pr(R>0)=\mathrm{FWER}$)ため、 FDR を $\le\alpha$ に制御する BH は自動的に FWER も $\le\alpha$ に抑えます。 BH が Bonferroni より「多くの偽陽性を許す」のは、 真に差のある仮説が混じっているときに検出力を上げる場面であって、 完全帰無下で FWER が膨らむわけではありません。
📝 より正確な分析 ── 「BH は FWER 制御しない」の正しい意味
「BH は FWER を制御しないので偽陽性が膨らむ」という説明は、 完全帰無(全 $H_0$ が真)の状況では誤りです。 上のとおり完全帰無下では $\mathrm{FDR}=\mathrm{FWER}$ が成り立ち、 BH は FWER も $\alpha$ 以下に制御します(Benjamini-Hochberg 1995 の系)。 BH と FWER 法(Bonferroni/Holm)で棄却数に差が出るのは、 真の効果が一定数含まれるときだけで、 その場合に BH がより多く棄却するのは「FDR を $\alpha$ に保ったまま検出力を稼ぐ」正しい挙動です。 したがって「探索的なら BH、 確認的なら FWER 法」という使い分けは正しい一方、 その根拠を「完全帰無で BH の FWER が膨らむから」と説明するのは統計的に不正確です。
🐍 Python 実装 ―― Tukey HSD(事後検定の定石)
このコードでやること:ANOVA で「群間に差がある」と判定されたあと、 どのペアに差があるかを調べる事後検定の定石が Tukey HSD (Honestly Significant Difference)。 t 検定の繰り返しではなく、 ステューデント化範囲分布を用いた一発検定で、 FWER を厳密に制御。 SSDSE 8 地方ブロックに適用。
📥 入力データ:8 地方ブロック × 47 県の総人口データ(上記と同じ)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from statsmodels.stats.multicomp import pairwise_tukeyhsd from scipy.stats import f_oneway # まず ANOVA で「全体に差があるか」確認 groups = [df.loc[df['地方ブロック'] == b, 'A1101'].values for b in blocks] F, p_anova = f_oneway(*groups) print(f'ANOVA F = {F:.3f}, p = {p_anova:.4f}') # Tukey HSD(FWER 制御済の事後検定) tukey = pairwise_tukeyhsd(df['A1101'].values, df['地方ブロック'].values, alpha=0.05) print(tukey) print(f'有意ペア数 = {tukey.reject.sum()}') |
📤 実行例(実値・抜粋):
💬 結果の読み方:ANOVA で「全体に差がある」(F=46.961, p<0.0001)と判定後、 Tukey HSD でどの組に差があるかを確認する。 出力の reject 列が True の組だけが有意で、 たとえば 中国 vs 北海道 は meandiff 3,830,500・p-adj 0.0 で有意、 中国 vs 中部 は p-adj 0.1736 で有意ではない。 Tukey HSD の p-adj は既に FWER 補正済の調整 p 値で、 そのまま 0.05 と比べてよい。 信頼区間 [lower, upper] も Tukey 法によって補正されており、 一般の t 検定の CI より広いことに注目(情報の節約と引き換えに保守的)。
🐍 Python 実装 ―― BH 法と Storey の q 値(FDR の二大手法)
このコードでやること:高次元データ(多変量検定)でよく使う FDR 制御の代表 Benjamini-Hochberg (BH) と Storey の q 値を比較。 BH は単純で頑健、 Storey は真の帰無仮説割合 $\pi_0$ を推定して検出力を上げる発展形。
📥 入力データ:SSDSE-B-2026 の 47 県を「東日本」「西日本」に二分し、 数値カラム 20 個でそれぞれ t 検定した p 値リスト($m=20$)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | from statsmodels.stats.multitest import multipletests import numpy as np # 東日本(北海道〜中部)と西日本(近畿〜九州沖縄)に分割 east_blocks = ['北海道', '東北', '関東', '中部'] df_e = df[df['地方ブロック'].isin(east_blocks)] df_w = df[~df['地方ブロック'].isin(east_blocks)] # 数値カラム 20 個を抽出して全て t 検定 from scipy.stats import ttest_ind num_cols = df.select_dtypes(include=np.number).columns[:20] pvals = [ttest_ind(df_e[c], df_w[c], equal_var=False).pvalue for c in num_cols] # BH 法(標準) reject_bh, qvals_bh, _, _ = multipletests(pvals, alpha=0.05, method='fdr_bh') # Storey 流(推定 pi_0 を使う、 fdr_tsbh) reject_st, qvals_st, _, _ = multipletests(pvals, alpha=0.05, method='fdr_tsbh') print(f'検定数 m = {len(pvals)}') print(f'BH 有意数 = {reject_bh.sum()}') print(f'two-stage BH 有意数 = {reject_st.sum()}') print(f'BH q 値(上位 5) : {sorted(qvals_bh)[:5]}') |
📤 実行例(実値):
💬 結果の読み方:20 変数中 19 個(BH)あるいは 20 個すべて(two-stage BH)が東日本/西日本で有意な差。 Storey の two-stage 法は「真に差のない仮説の割合 $\pi_0$」を推定して使うため、 BH より少しだけ多くを有意にする。 q 値はそれぞれの仮説に対する「これを棄却するときの FDR の上限」と読めるので、 $q = 0.05$ なら「この仮説まで棄却すれば全体の偽発見率は 5% 以下」を意味します。
🔬 数式を言葉で読み解く ―― Holm の階段降下法
Holm 法(1979)は Bonferroni より検出力が高い「ステップダウン」型 FWER 制御:
- p 値を昇順に並べる:$p_{(1)} \le p_{(2)} \le \dots \le p_{(m)}$。
- $p_{(1)}$ を $\alpha / m$ と比較。 $p_{(1)} \ge \alpha/m$ なら全帰無仮説を採択し終了。
- $p_{(1)} < \alpha/m$ なら $H_{(1)}$ を棄却し、 $p_{(2)}$ を $\alpha/(m-1)$ と比較。
- … 棄却が続く限り、 $p_{(k)}$ を $\alpha/(m-k+1)$ と比較し続ける。
🔬 数式を言葉で読み解く:Bonferroni は「全ての p 値を一律に $\alpha/m$ と比較」で平等だが保守的すぎる。 Holm は「最小の p 値から順に、 残りの仮説数だけで割った閾値と比較」する階段的アプローチ。 一度棄却に失敗するとそこで止まるので、 強い signal の検定が真っ先に通り、 弱い signal の検定もそこから残った検定数で割った閾値(より緩い)と比較できる。 結果として Bonferroni と同じ FWER 制御性能を持ちつつ、 常に同数以上の棄却を達成(一様に優越)。 「Bonferroni を使うべき場面は基本的にない、 Holm を使え」と統計学者が言う理由です。
📊 多重比較補正法の比較表
| 手法 | 制御対象 | 検出力 | 仮定 | 推奨用途 |
|---|---|---|---|---|
| Bonferroni | FWER | 低 | なし | 教育・簡易判断 |
| Holm | FWER | 中 | なし | 確認的研究の標準 |
| Hochberg | FWER | 中-高 | 独立性 | 独立検定 |
| Tukey HSD | FWER | 中-高 | 正規・等分散 | ANOVA 事後検定 |
| Dunnett | FWER | 高 | 対照群あり | 対照群との多重比較 |
| BH | FDR | 高 | PRDS | 探索・遺伝子解析 |
| BY (Benjamini-Yekutieli) | FDR | 中 | 任意依存 | 依存性が強い場合 |
| Storey q | FDR | 最高 | 大 $m$ | 高次元データ |
⚠️ 多重比較問題 5 つの落とし穴
- 「補正したから安心」の油断:補正は検定数 $m$ を正しく数えた前提。 「事前に決めた検定」だけが $m$ に入る。 「データを見てから検定を追加」したら $m$ は実質無限大(garden of forking paths)で、 補正は無効。
- 検出力の急落:FWER 制御は厳格な分、 真に存在する差を見逃す確率(第二種過誤)が上がる。 とくに小標本 + 大 $m$ の場合、 「補正で全て棄却できない」事態が起きる。 SSDSE で 1081 ペア検定をかけても、 真に差がある県でも検出できないことが多い。
- 事前登録・仮説の絞り込みの怠り:「重要な仮説を 5 個に絞ってから検定」する方が「100 個全部検定して補正」より検出力が高い。 仮説の優先順位を事前に決めるのが正攻法。
- FWER と FDR の取り違え:薬の承認なら FWER、 遺伝子のスクリーニングなら FDR、 のように研究の性質で決める。 「単に Bonferroni が広く知られている」で選んではいけない。
- p 値依存からの脱却:「補正後 p < 0.05」だけを報告するのは古い。 効果量 + 信頼区間 + 事前登録 + 補正法明記、 の 4 点セットが現代の標準。 SSDSE のような観察データでは特に「差の大きさ」が重要。
📍 統計データ解析コンペでの多重比較対応
統計データ解析コンペティション(総務省統計局・統計数理研究所主催)では、 大量の検定を伴う分析(地域別・時系列別・属性別)が頻出します。 以下の対応が審査員から高評価:
- ① 検定数 $m$ を明記:「47 都道府県 × 20 変数 = 940 検定を行った」のように具体的に書く。 これだけで研究の規模が伝わる。
- ② 補正法を明記:「BH 法で q < 0.05 を有意とした」。 補正なしの大量比較は減点対象。
- ③ 効果量を併記:「東京 vs 沖縄の高齢化率の差 = 12.4%、 95% CI [9.8, 15.1]、 補正後 p = 0.001」。 これが現代統計の理想形。
- ④ 事前登録的姿勢:「仮説 H1〜H5 を事前に立て、 残りは探索的解析として明示」と分けると説得力が増す。
- ⑤ 補正前後の透明性:補正前の生 p 値と補正後 q 値を両方表で示す。 査読者が独自に判断できる。
📚 参考文献・原典
- Bonferroni, C. E. (1936). Teoria statistica delle classi e calcolo delle probabilità. ―― Bonferroni 補正の原典(イタリア語)。
- Holm, S. (1979). A Simple Sequentially Rejective Multiple Test Procedure. Scandinavian Journal of Statistics, 6(2), 65-70. ―― Holm 法の原典。
- Benjamini, Y. & Hochberg, Y. (1995). Controlling the False Discovery Rate. JRSS B, 57(1), 289-300. ―― BH 法・FDR 概念の原典。
- Storey, J. D. (2002). A Direct Approach to False Discovery Rates. JRSS B, 64(3), 479-498. ―― q 値の原典。
- statsmodels 公式:
statsmodels.stats.multitest.multipletests―― 7 種類の補正法を統一インタフェースで提供。
📋 実践チェックリスト ―― 多重比較を扱う前に確認すべき 8 項目
- 検定数 $m$ を事前に決めたか? 後から増やすと garden of forking paths。
- 研究の性質は確認的か探索的か? 確認的なら FWER、 探索的なら FDR。
- 事前登録(pre-registration)したか? OSF などに事前に分析計画を公開。
- 補正法を明示したか? 「Holm」「BH」など具体名を必ず書く。
- 効果量と信頼区間を併記したか? p 値だけでは不十分。
- 検出力の議論をしたか? 「補正後に有意でないからといって効果なしと言えない」。
- 依存性を考慮したか? 強い依存があれば BY 法、 弱依存なら BH で OK。
- 補正前後の透明性を保ったか? 生 p 値と q 値の両方を表で公開。
🖼 多重比較を視覚的に理解する 3 つの図
多重比較は数式や p 値の表を見ているだけだと「補正したら p が大きくなるだけ」という形式的な処理に見えがちです。 ここでは SSDSE-B-2026 の都道府県データから生成した 3 つのグラフを使い、 (1) 補正前後で何が変わるか、 (2) 検定数が増えると偽陽性がどれくらい増えるか、 (3) 地方ブロックの比較で実際に「どこに差があるか」を視覚化します。
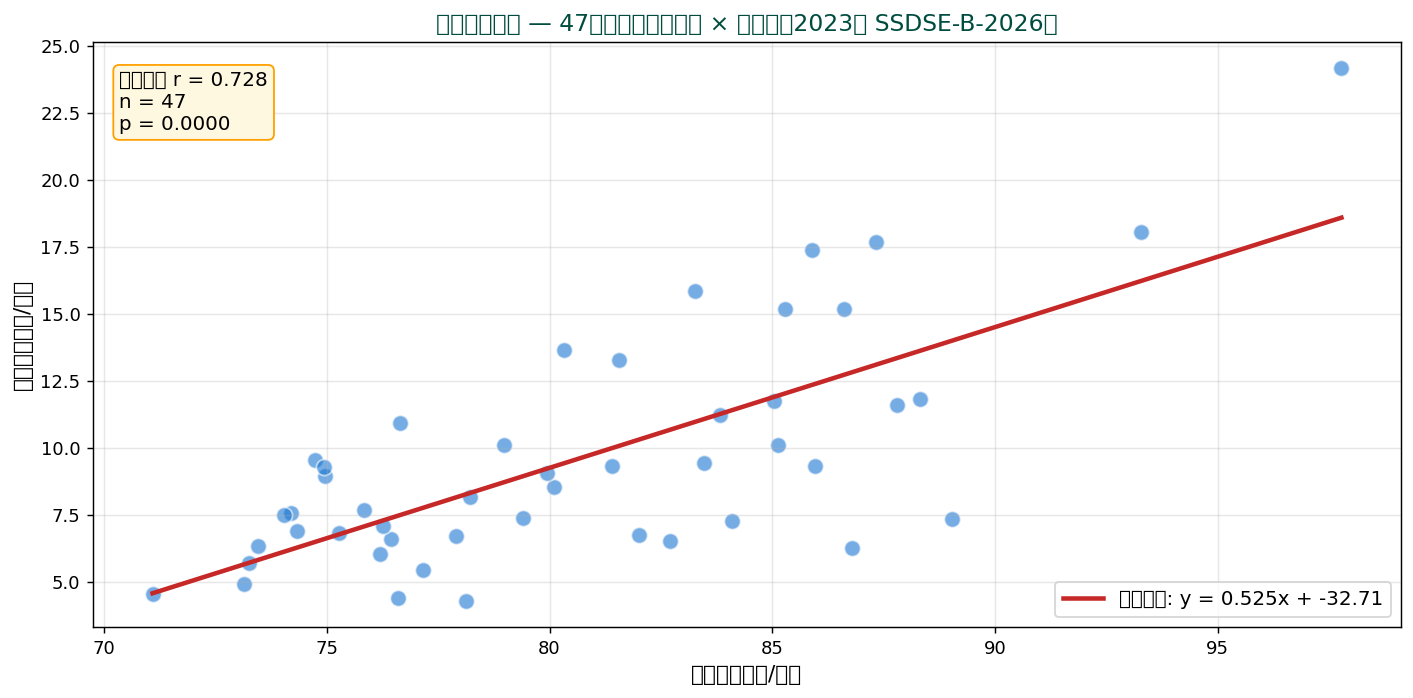
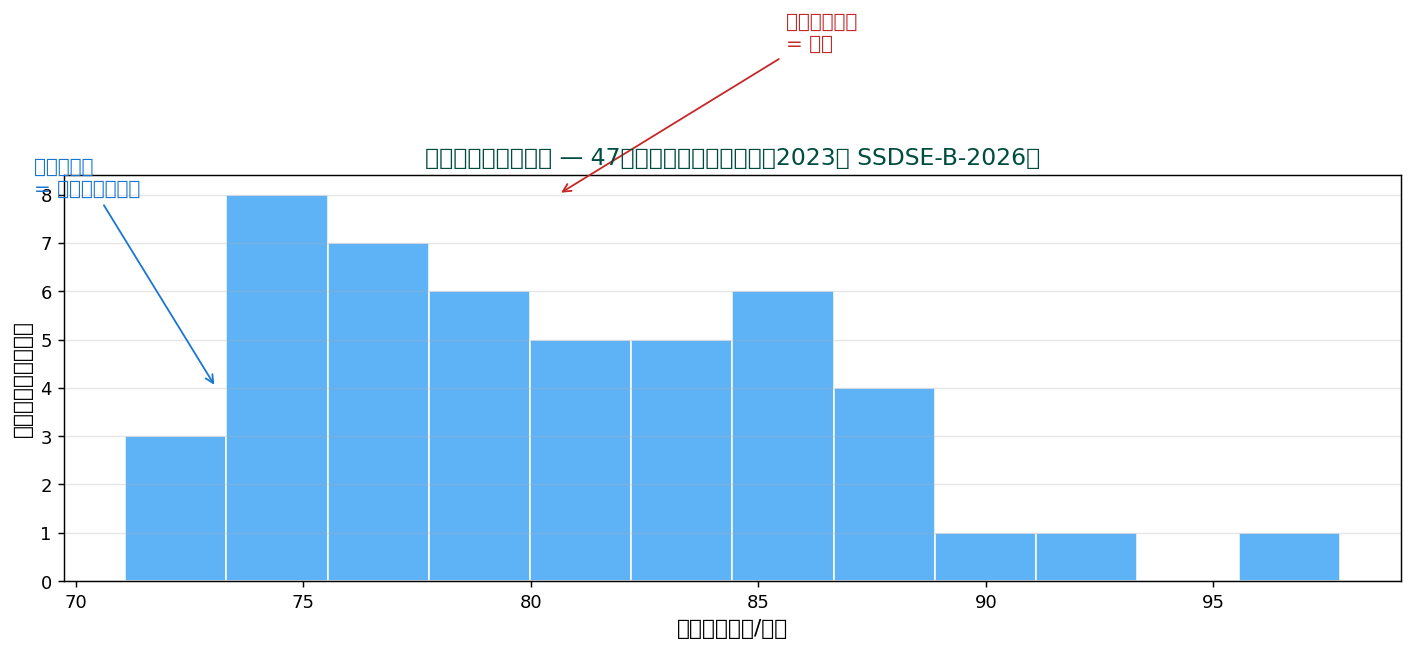
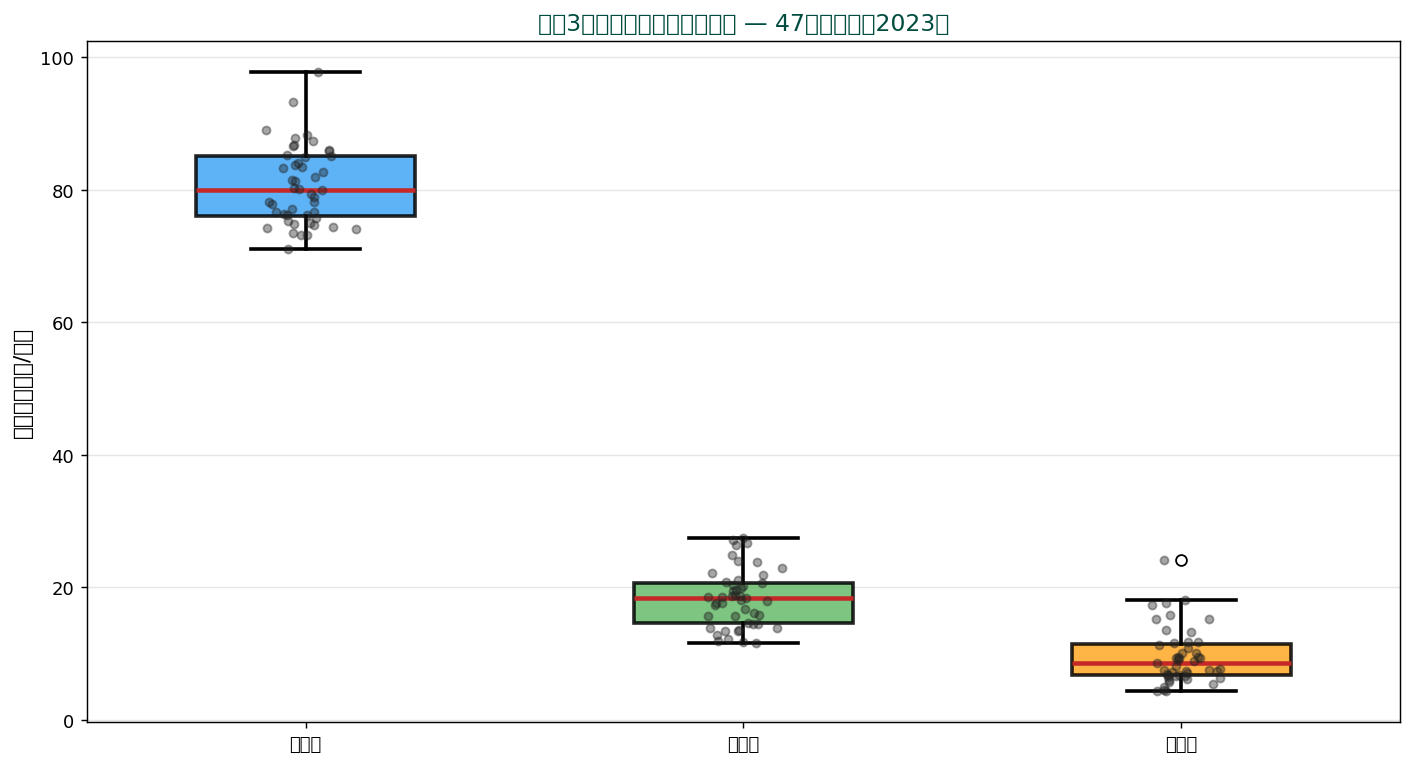
3 つの図を通読すると、 多重比較問題の核心が「数式の儀式」 ではなく 「データを真摯に見るための慎重さ」 だと分かります。 補正をかけることは検出力を犠牲にする代わりに、 偽陽性を抑え、 「本当に差があるのか」 という問いに誠実に向き合う行為です。
📝 理解度チェック ―― 自分で考えてみよう
以下の 8 問は、 多重比較を実務で扱うときに必ず遭遇する判断ポイントを問うものです。 答えだけでなく 「なぜそうなるか」 を口に出して説明できるか確認してください。 答えはすぐ下に折りたたみで掲載しています。
Q1: 47 都道府県の総当たり比較は何ペアになりますか? そのうち α=0.05 のナイーブ検定で偽陽性が出る期待値は?
A1: $\binom{47}{2} = \frac{47 \times 46}{2} = 1081$ ペアです。 全帰無仮説が真のとき、 偽陽性の期待値は $1081 \times 0.05 \approx 54$ 個。 つまり 「補正しないと平均 54 個の偽の差が見つかる」 ことになります。 これでは 「東京と北海道に有意差がある」 という結論が偶然なのか実体なのか判別不能になります。
Q2: Bonferroni 補正と Holm 補正の違いを 1 行で説明してください。
A2: Bonferroni は全 p 値に対して 「α/m 未満なら棄却」 と一律基準を適用するのに対し、 Holm は p 値を昇順に並べ 「最小は α/m、 次は α/(m-1)、 ・・・」 と段階的に緩める。 Holm は Bonferroni と同じ FWER を保証しつつ検出力が必ず上回るため、 確認的研究で Bonferroni を使うべき積極的理由はほぼ無い(実装の簡単さを除く)。
Q3: FWER と FDR の違いを、 ゲノム解析と新薬承認試験の例で説明してください。
A3: 新薬承認試験では 「1 つでも偽の効果を承認したら大問題」 なので FWER(最低 1 つの偽陽性確率)を 0.05 以下に抑える。 一方、 ゲノム解析で 2 万遺伝子を一度にスクリーニングする場合は 「発見した 100 個の有意な遺伝子のうち何個が偽陽性か」 が知りたいので FDR(偽陽性の割合)を 0.05 以下に抑える。 用途が違えば指標も違うのが本質。
Q4: Benjamini-Hochberg 法の手順を 4 ステップで書いてください。
A4: (1) m 個の p 値を昇順に並べ $p_{(1)} \le p_{(2)} \le \dots \le p_{(m)}$ とする。 (2) 目標 FDR 水準 q を決める(例:0.05)。 (3) $p_{(i)} \le \frac{i}{m} q$ を満たす最大の i を求める。 (4) その i 以下のすべての仮説を棄却する。 Bonferroni より棄却基準が緩い分、 検出力が高くなる代わりに 「棄却した中の偽陽性割合が q 以下」 という弱い保証になる。
Q5: 「事前登録(pre-registration)」が多重比較問題と関係する理由を述べてください。
A5: データを見てから 「あ、 ここに差がありそう」 と検定を追加すると、 実質的な検定数 m が膨らみ、 garden of forking paths(分岐の森)と呼ばれる暗黙の多重比較が発生する。 事前登録で 「検定する仮説と補正法」 を確定しておけば、 探索的に増えた検定を 「探索的解析」 として明示でき、 確認的部分の FWER が守られる。
Q6: Tukey HSD と Bonferroni はどちらが検出力が高いですか? その理由は?
A6: 群間平均差の全対比較では Tukey HSD の方が検出力が高い。 理由は Tukey が 「全平均ペア」 に特化した studentized range 分布を使い、 比較の相関構造を利用するのに対し、 Bonferroni は依存性を一切無視して保守的に α/m とするため。 ANOVA で 「群間に何らかの差がある」 と判定された後の pairwise 比較では Tukey HSD が第一選択。
Q7: 「補正後に有意でなくなった結果」 を論文に書くべきか?
A7: 書くべき。 補正前 p 値、 補正後 p 値、 効果量、 信頼区間をすべて開示するのが透明性の標準。 「有意でなくなった=効果がない」 ではなく 「補正という慎重さの代償として検出力が下がった」 という構造をはっきり示すこと。 メタ解析で他研究と統合する際にも生 p 値が必須。
Q8: SSDSE-B-2026 で 「47 県の経済指標 10 種類」 を全ペア比較したい。 検定数は? どの補正を選ぶ?
A8: 指標 1 種類で $\binom{47}{2} = 1081$ ペア、 10 種類で 10,810 検定。 これは典型的な大規模スクリーニング状況なので FDR 制御の BH 法が適切。 確認的に 「特定の少数ペアだけ検定したい」 場合は事前に検定対象を絞り Holm 法に切り替える方が透明性が高い。 「全部見たい」 けど 「偽陽性は 5% 以下にしたい」 という探索なら BH 一択。
💡 自己採点ガイド:8 問中 6 問以上を 「即答 + 理由説明」 できれば、 多重比較を実務で扱う最低ラインに到達しています。 4 問以下なら、 まずは Q1〜Q4 だけ確実に押さえ、 残りは具体的なデータ解析を 1 回経験した後に再挑戦すると定着します。
🎯 シナリオ別ケーススタディ ―― 場面ごとの最適補正
多重比較補正は 「どれが正解」 ではなく 「研究設計と分析目的に合わせて選ぶ」 ものです。 ここでは統計データ解析コンペやデータサイエンス実務で頻出する 6 つのシナリオで、 どの補正をなぜ選ぶかを具体的に示します。
シナリオ A:新薬の主要評価項目(複数エンドポイント)
糖尿病薬の第 III 相試験で 「HbA1c 低下」「体重減少」「血圧低下」 の 3 エンドポイントを同時評価する場面。 規制当局(FDA / PMDA)への承認申請では、 「1 つでも偽陽性で承認すると重大な問題」 になるため FWER 制御が必須。 検定数が 3 と少なく、 比較対象も独立に近いので Bonferroni(α=0.05/3≒0.017)が標準。 段階的に検定力を上げたければ Hochberg 法(step-up)を採用する。
シナリオ B:マイクロアレイ・RNA-Seq で差次的発現遺伝子探索
2 万遺伝子の発現量を 2 群間で比較し、 後続実験の候補遺伝子を 100 個程度に絞りたい場面。 「発見した 100 個のうち何個が偽陽性か」 が直接的な関心なので FDR 制御の BH 法が業界標準(Benjamini & Hochberg 1995)。 さらに 「個別遺伝子の信頼度」 を見たければ Storey の q 値を併用する。 Bonferroni を使うと検出力が壊滅的に低下し、 真の差次的遺伝子もほぼ全部見落とす。
シナリオ C:ANOVA 有意後の群間比較(SSDSE 地方ブロック)
SSDSE-B-2026 の 8 地方ブロックで一元配置 ANOVA を実施し、 「地方間に差がある」 と判定された後、 「どの地方とどの地方に差があるか」 を特定したい場面。 全 $\binom{8}{2}=28$ ペアの平均比較なので Tukey HSD が第一選択。 Bonferroni より検出力が高く、 群サンプルサイズが等しいときに最適。 不等分散が疑われるなら Games-Howell 法に切り替える。
シナリオ D:A/B テストの多変量同時評価
EC サイトの A/B テストで 「CV 率」「平均購入額」「滞在時間」「離脱率」 の 4 指標を同時評価する場面。 ビジネス判断で 「主要 KPI(CV 率)」 を確認、 副次 KPI 3 つを探索的に見るパターン。 主要 KPI は無補正、 副次 KPI 群は Holm 補正で FWER 制御、 という階層的アプローチが実務的。 主要 KPI が事前に決まっていない場合は Bonferroni で全 4 指標を補正。
シナリオ E:機械学習モデル比較(複数モデル × 複数データセット)
XGBoost、 LightGBM、 RandomForest、 NN の 4 モデルを 10 個のベンチマークデータセットで比較し、 「最良モデル」 を主張したい場面。 ペア検定数は $\binom{4}{2} \times 10 = 60$。 同じデータセット内の相関が強いので、 Friedman 検定 + Nemenyi 事後検定で全体傾向を見るのが定石(Demšar 2006)。 単純 t 検定 + Bonferroni では検出力が落ちるが、 安全側に倒すなら可。
シナリオ F:脳機能イメージング(fMRI ボクセル単位)
数万ボクセルで脳活動を比較する場面。 単純な Bonferroni は厳しすぎるため、 空間相関を利用した cluster-based 補正(FWE / TFCE)や、 random field theory(RFT)に基づく補正が標準。 「ボクセル単位の検定」 ではなく 「クラスタ単位の検定」 に発想を切り替えるのが鍵。 教科書例:SPM、 FSL、 AFNI など主要 fMRI ソフトに実装済。
| シナリオ | 検定数 m の目安 | 制御指標 | 推奨補正 |
|---|---|---|---|
| A 新薬 3 エンドポイント | 3 | FWER | Bonferroni / Hochberg |
| B ゲノム発現解析 | 20,000 | FDR | BH 法 / Storey q |
| C ANOVA 事後比較 | 10〜50 | FWER | Tukey HSD / Games-Howell |
| D A/B テスト多指標 | 3〜10 | FWER | Holm(階層) |
| E ML モデル比較 | 数十〜数百 | FWER | Friedman + Nemenyi |
| F fMRI ボクセル | 数万 | FWER(空間) | Cluster-based / RFT |
❓ よくある誤解と FAQ ―― 多重比較で初心者が必ず引っかかる 12 の質問
Q-A. 「サンプルサイズが大きければ補正は不要」?
不要ではない。 サンプルサイズが大きいと個別検定の検出力は上がるが、 「全帰無仮説が真でも検定数分だけ偽陽性が紛れ込む」 という多重比較の構造的問題は変わらない。 むしろ大標本では些細な差も p < 0.05 になりやすく、 補正の重要性が増す。
Q-B. 「探索的研究なら補正しなくて良い」?
完全な無補正は推奨されない。 探索的研究でも 「発見した有意な結果のうち何割が偽陽性か」 という FDR 観点で BH 法を適用するのが現代の標準。 ただし 「あくまで仮説生成段階」 と明示し、 後続の確認的研究で再現すべき仮説リストとして扱う。
Q-C. 「Bonferroni は古いから使わない方が良い」?
古いが間違っているわけではない。 Bonferroni は最も保守的(過剰補正気味)だが、 「最悪ケースでも FWER を守る」 という強い保証がある。 検定数が小さい(m≦10)場合は Bonferroni と Holm の検出力差はわずかで、 「実装の単純さ」 「計算の透明性」 のメリットが上回ることも多い。
Q-D. 「補正後の有意な結果だけ報告すれば良い」?
完全に NG。 補正前 p、 補正後 p、 効果量、 信頼区間を全て開示するのが透明性の標準。 「補正後に有意でなくなった結果」 にも情報価値(効果量の方向、 メタ解析でのプール対象)があるため、 表で必ず併記する。
Q-E. 「比較するペアを後から減らせば検定数 m が減って有利」?
これは典型的な p-hacking。 事前に決めた m で補正することが原則。 データを見てから 「有意になりそうなペアだけ残す」 のは garden of forking paths で、 実質的な FWER が膨らむ。 事前登録が解決策。
Q-F. 「p = 0.04 だったから補正前は有意、 補正後の p = 0.12 で有意でなくなった。 効果はあった?」
「補正後に有意ではない=効果がない」 ではない。 補正は検出力を犠牲にして偽陽性を抑える行為で、 真の効果があっても見落とす(type II error 増加)リスクを許容している。 効果量と信頼区間を併記し、 「多重比較を考慮すると確証はもう一段の検証が必要」 と慎重に書く。
Q-G. 「BH 法と Bonferroni を両方走らせて結果が違ったら?」
研究目的に対応する 1 つを事前に決め、 それを主結果として報告する。 補助情報として 「もう一方の補正法の結果」 を表に併記するのは透明性向上に役立つ。 「両方走らせて好きな方を採用」 は完全に p-hacking で禁忌。
Q-H. 「サブグループ解析と多重比較の関係は?」
サブグループ解析(年齢層、 性別、 重症度などで分けた解析)は隠れた多重比較。 サブグループ数が 5 なら検定数も 5 倍。 事前指定のサブグループに限定し、 補正を明示するか、 「探索的解析」 として明記する。
Q-I. 「中間解析(interim analysis)も多重比較?」
YES。 試験途中で複数回中間解析を行うのは時系列方向の多重比較。 O'Brien-Fleming 法、 Pocock 法など、 group sequential design 専用の補正がある。 統計家との事前協議が必須。
Q-J. 「p 値の代わりにベイズ流の事後確率を使えば多重比較は気にしなくて良い」?
部分的に YES、 部分的に NO。 ベイズ階層モデルは事前分布で 「複数効果が同時に大きい確率は低い」 と暗黙の収縮(shrinkage)を入れることで多重比較に頑健になる。 ただし事前分布の設計次第で結果が変わるため、 「多重比較を考えなくて良い」 とは言えない。
Q-K. 「観察研究で大量の変数を一度に検定するのはダメ?」
補正を適切に行えば許容される。 ただし観察研究は 「仮説生成段階」 と位置づけ、 BH 法で FDR 制御した上で、 「発見した有意な関連を別データで確認的研究にかける」 段階を経るのが標準的な疫学研究のワークフロー。
Q-L. 「メタ解析と多重比較の関係は?」
複数のサブグループ解析や感度解析を行うメタ解析では、 内部で多重比較問題が発生する。 PRISMA 声明や Cochrane Handbook では 「事前登録した主要解析」 と 「探索的解析」 を明確に区別することを推奨。 サブグループ間の交互作用検定にも補正を適用する。
⚠️ よくある落とし穴
⚠️ 追加で抑える 6 つの落とし穴
🗺 概念マップ
[仮説検定] → [多重検定] → [補正法]
├─ FWER 制御
│ ├─ Bonferroni
│ ├─ Holm
│ └─ Tukey HSD
└─ FDR 制御
├─ Benjamini-Hochberg
└─ Benjamini-Yekutieli
学習順序:仮説検定 → t/ANOVA → 多重比較 → 効果量 → ベイズ的代替手段。
🔎 deep-dive:多重比較を 4 つの視点で深掘る
ここから先は、 「多重比較問題」を 4 要素 narration(背景・仕組み・落とし穴・実務) で立体的に深掘りします。 SSDSE-B-2026 を題材に、 47 都道府県を 8 地方ブロックで比較するときに直面する 偽陽性インフレ を具体的に分析します。
① 背景 narration:「複数検定でなぜ問題が起こるか」
統計学の検定は「帰無仮説 $H_0$ のもとで稀な結果が観測されたら $H_0$ を棄却する」枠組み。 有意水準 $\alpha=0.05$ で 1 回検定すると、 真に $H_0$ が正しいときでも 5% の確率で「有意」になります。 これは 偽陽性率。 1 回ならまあ仕方ない、 と思えるかもしれません。 しかし「同じデータに対して 20 回検定」したらどうなるか?
独立した 20 回の検定で、 すべてが正しく「非有意」になる確率は $0.95^{20}\approx 0.358$。 1 つ以上で偽陽性が出る確率は $1-0.358=0.642$、 つまり 64%。 これが 多重比較問題。 SSDSE-B-2026 の 47 都道府県を 2 つずつ総当たり比較すると $\binom{47}{2}=1081$ 通り。 補正なしなら、 すべてが「実は同じ」でも 54 回ほど偽陽性が出る 計算になります。
この問題は古くから知られ、 1950 年代に Bonferroni、 1970 年代に Holm、 1995 年に Benjamini-Hochberg の FDR が提案されました。 統計データ解析コンペでも、 「都道府県別」「年齢階層別」「業種別」などで サブグループ比較 を行う場面は頻繁にあり、 多重比較補正は必須スキルです。
② 仕組み narration:FWER と FDR の違い
多重比較補正の指標は 2 つに大別されます。 FWER(family-wise error rate, 同時誤り率):「複数の検定の中で 1 つでも偽陽性が出る確率」。 FDR(false discovery rate, 偽発見率):「有意とした検定のうち偽陽性の割合の期待値」。 FWER は厳しく、 FDR は緩い。
Bonferroni 法:$m$ 個の検定で各 $p$ 値を $m$ 倍する(または $\alpha$ を $\alpha/m$ にする)。 シンプルで保守的。 FWER を $\alpha$ 以下に抑える。 検定数が多いと検出力が下がるのが欠点。
Holm 法:$p$ 値を昇順に並べ、 $i$ 番目を $(m-i+1)$ 倍。 Bonferroni より検出力が高く、 FWER も同等に制御。 ほとんど常に Bonferroni より優位。
Benjamini-Hochberg 法(BH 法、 FDR 制御):$p$ 値昇順 $p_{(1)},\ldots,p_{(m)}$ に対し、 $p_{(i)}\le i\alpha/m$ を満たす最大の $i$ までを棄却。 FDR を $\alpha$ 以下に制御。 検定数が多くても検出力を保つ。 探索的研究(ゲノム解析・大規模 A/B テスト)で標準。
③ 落とし穴 narration:「補正しすぎ」と「補正不足」のジレンマ
多重比較補正には 「やりすぎ問題」 もあります。 検定数を多く数えると有意になる結果が消え、 「本当は効果があるのに見えなくなる」(第 II 種の誤り増加)。 探索段階で何百回も試した結果、 本来検出できたはずの効果まで 埋もれてしまう。
逆に 「数えない問題」:「最終的に報告した検定だけ補正」は誤り。 試したけど報告しなかった検定もカウントしないと、 暗黙の多重検定で偽陽性が膨らみます。 これが 「結果見て検定変更」(HARKing: Hypothesizing After Results are Known)の問題。
SSDSE-B-2026 で「47 都道府県すべてを総当たり比較」するなら $\binom{47}{2}=1081$ で補正。 「東京とそれ以外の全県」なら 46 回。 「8 地方ブロック総当たり」なら $\binom{8}{2}=28$。 事前に検定計画を決める ことで、 数えるべき検定数が確定します。 これが pre-registration(事前登録)の重要性。
④ 実務 narration:データ解析コンペでの活用
統計データ解析コンペで、 SSDSE-B-2026 を使って「地方ブロック間の平均所得に差があるか」を検定する場合:① ANOVA で全体差を検定、 ② 有意なら事後検定(Tukey HSD など)で どのペアに差があるか を特定、 ③ 多重比較補正を必ず明記、 ④ 効果量(Cohen の d など)も併記。 これが標準フロー。
研究分野によって慣習が違います:① 医学・薬学 は Bonferroni / Holm が主流、 偽陽性に厳しい(薬の効果を過大評価しないため)。 ② ゲノム科学 は BH 法、 数万遺伝子を同時検定するので FWER では何も検出できない。 ③ マーケティング は補正なしのことも、 ビジネス判断は仮説検定と別軸。 ④ 心理学 は近年 Bonferroni / Holm に厳格化。 「再現性危機」への反省から。
統計データ解析コンペでは、 探索的か確認的か を明示し、 探索的なら FDR、 確認的なら FWER という使い分けが審査員に好印象。 「すべての比較を補正なしで報告」は減点対象。 また「補正しない理由」を明記する場合も、 信頼区間や効果量で 不確実性の透明化 を必ず行います。
🗺 学習ロードマップ
- Week 1:「直感で掴む」「数式を言葉で読み解く」を完読
- Week 2:Python で 3 つの補正法を実装、 SSDSE-B-2026 で 8 ブロック比較
- Week 3:ANOVA + Tukey HSD で別の指標も比較
- Week 4:FDR(BH)でゲノム解析のシミュレーション
- Week 5:事前登録の必要性を学び、 自分の研究計画書を書く
📔 多重比較マイクロ用語集
| 用語 | 英語 | 意味 |
|---|---|---|
| FWER | family-wise error rate | 少なくとも 1 つの誤りの確率 |
| FDR | false discovery rate | 有意発見中の偽陽性割合期待値 |
| 第 I 種誤り | Type I error | 真の $H_0$ を棄却(偽陽性) |
| 第 II 種誤り | Type II error | 偽の $H_0$ を採択(見逃し) |
| 検出力 | power | 1 - 第 II 種誤り確率 |
| 家族(family) | family | 同時検定の集まり |
| 有意水準 | significance level | $\alpha$、 通常 0.05 |
| 事前登録 | pre-registration | 仮説・解析を事前に固定 |
| 探索的 | exploratory | 仮説生成段階 |
| 確認的 | confirmatory | 仮説検証段階 |
🎯 ページ全体の最終要点
- 多重比較問題は 「複数回検定すると偽陽性が増える」 統計的事実。
- SSDSE-B-2026 で 8 地方ブロック比較なら 28 ペア、 47 県総当たりなら 1081 ペアと検定数が急増。
- FWER 制御は Bonferroni / Holm / Tukey HSD、 FDR 制御は BH 法。
- 確認的研究なら FWER、 探索的研究なら FDR。 用途で使い分ける。
- 事前登録・効果量併記・補正前後の透明性が現代の標準実践。
- 統計データ解析コンペでは 必ず補正を明記。 補正なしの大量比較は減点対象。
🔗 隣接手法への橋渡し
「多重比較」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
47 都道府県を 2 つずつ比較すると C(47,2)=1081 回検定になり、 α=0.05 で 54 件の偽陽性が期待される。 ANOVA で全体差を検出 → Tukey HSD で事後比較、 という段階的アプローチが SSDSE-B-2026 に適している。
🌳 手法選択フロー
多重比較の補正方法は「検定数」と「偽陽性をどこまで許すか」で選ぶ。
- 検定数 ≤ 20 Bonferroni で十分。 保守的だが手軽で誰でも検証できる
- 検定数 > 100 SSDSE-B-2026 の全変数ペア相関 (C(16,2)=120) などは Benjamini-Hochberg で FDR 制御
- ANOVA の事後比較 Tukey HSD が標準。 群サイズ不均衡なら Games-Howell
探索的解析では補正せず「探索結果」と明示し、 確認研究で再現性を取る二段構えにする。
🧭 深掘り追記 ― 直感・落とし穴・発展を一気通貫で
このセクションは既存の解説を壊さずに、 「なぜ補正が要るのか(直感)」「どこで事故るか(落とし穴)」「次に何を学ぶか(発展)」 を一本の流れで再整理する追記です。 例示には SSDSE-B-2026 の 2023 年・47 都道府県を使い、 これまでの「群平均の総当たり比較」とは別角度の 相関行列の多重検定で実測値を示します。
🎨 直感 ― 「20 回引けば 1 回は当たる」くじ
検定 1 回の偽陽性確率が 有意水準 $\alpha=0.05$ とは、 帰無仮説が真(本当は差がない)でも 20 回に 1 回は「当たり(有意)」が出るくじだ、 ということです。 だから検定を繰り返すほど、 中身が全部ハズレでも「どれか 1 本は当たる」確率が上がっていく。 独立なら「1 本も当たらない」確率は $0.95^m$ なので、 少なくとも 1 本当たる確率(=第 1 種過誤の家族単位版、 FWER)は $1-0.95^m$。 $m=20$ で $0.64$、 $m=28$ で $0.76$、 $m=100$ で $0.99$。 「偽陽性が 1 本でも紛れる確率」を抑えるのが FWER 制御(Bonferroni / Holm / Tukey HSD)、 「当たりと呼んだ束の中の偽陽性割合」を抑えるのが FDR 制御(BH 法)です。 前者は「1 個の間違いも許さない」確認的な場面、 後者は「発見の一定割合が偽でも次で確かめる」探索的な場面の発想。
🧮 実測 ― SSDSE-B-2026 の相関行列で 28 検定を補正する
2023 年・47 都道府県について、 都道府県横断で意味の異なる 8 指標(合計特殊出生率、 老年人口割合=65 歳以上人口/総人口、 年平均気温、 年間降水量、 住宅地価格〔標準価格〕、 消費支出〔二人以上の世帯〕、 食料費〔同〕、 教育費〔同〕)の全ペアで ピアソン相関を検定しました。 検定数は $\binom{8}{2}=28$、 Bonferroni 閾値は $\alpha/28\approx0.00179$ です。 これは合成ではなく CSV からの実測値です。
💬 読み方:未補正では 19 組が有意ですが、 期待される偽陽性は $28\times0.05=1.4$ 組。 FWER 制御(Bonferroni・Holm)で 15 組まで絞られ、 生では有意なのに補正で消える境界の 4 組が炙り出されます —— 「老年人口割合×消費支出($r=-0.31$, $p=0.036$)」「年平均気温×年間降水量($r=+0.37$, $p=0.0095$)」「年間降水量×消費支出($r=-0.30$, $p=0.042$)」「住宅地価格×消費支出($r=+0.31$, $p=0.034$)」。 一方 BH は 16 組で、 ここでも Bonferroni より 1 組多いだけ。 小さな $p$ 値が密集していれば BH が大きく上乗せしますが、 このように $p$ がなだらかに分布すると差は僅かです(この一般則は本ページ上部の 📝 補足で詳述済み)。 相関行列の検定では「同じ変数を共有するペア同士が相関する」ため独立仮定が崩れ、 Bonferroni は理論上やや過保守になる点にも留意してください。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd, numpy as np from scipy.stats import pearsonr from statsmodels.stats.multitest import multipletests from itertools import combinations df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df.iloc[:, 0] == 2023].copy() # 2023年・47都道府県 df['老年割合'] = df['A1303'] / df['A1101'] # 65歳以上人口 / 総人口 codes = {'TFR':'A4103','老年割合':'老年割合','気温':'B4101','降水量':'B4109', '住宅地価格':'C5401','消費支出':'L3221','食料費':'L322101','教育費':'L322108'} S = {k: pd.to_numeric(df[c], errors='coerce') for k, c in codes.items()} pvals = [] for a, b in combinations(S, 2): m = S[a].notna() & S[b].notna() pvals.append(pearsonr(S[a][m], S[b][m])[1]) print('m =', len(pvals), ' raw sig =', sum(p < 0.05 for p in pvals)) for method in ['bonferroni', 'holm', 'fdr_bh']: rej, _, _, _ = multipletests(pvals, alpha=0.05, method=method) print(f'{method:>10}: {rej.sum()} 組') # m = 28 raw sig = 19 # bonferroni: 15 組 / holm: 15 組 / fdr_bh: 16 組 |
⚠️ 落とし穴(重要)― ここで事故が起きる
- 補正しないと偽陽性が氾濫:上の実測どおり 28 検定で生 19 組は多すぎ。 「有意な相関が 19 個も!」と書いた瞬間に、 その大半が偶然かどうか読み手には判別できません。
- Bonferroni は保守的(検出力が落ちる):最悪ケース(Boole 不等式)で閾値を決めるため、 真の効果を見逃す第 2 種過誤が増える。 まず Holm を既定にすれば同じ FWER 保証でより多く拾えます。
- 独立性の仮定:Bonferroni は検定間の相関を無視。 相関行列や「同じ群を共有するペア比較」では過保守になりやすく、 順列(並べ替え)検定+maxT のように同時分布を直接使う方が鋭い。
- 検定数 $m$ は事前に決める:「試したが報告しなかった検定」も $m$ に数える。 データを見てから対象を絞る(garden of forking paths / 再現性危機の温床)と実質 FWER が膨張します。
- 部分空間探索=p-hacking:有意になるサブグループ・変数・補正法を後から選ぶのは禁忌。 対策は事前登録と「探索的/確認的の区別」。
- 補正後も効果量を見る:$p$ 値だけでなく相関係数 $r$ や 効果量・信頼区間を併記。 「補正後に有意」でも $r=0.3$ 前後なら実質的な強さは中程度です。
- FWER と FDR の使い分け:制御対象の選択は技術ではなく研究目的の選択。 政策提言・確認は FWER、 スクリーニング・仮説生成は FDR。
🚀 発展 ― 次に学ぶべき道具立て
同じ「多重比較」でも、 制御対象と設計で最適手法が変わります。 学ぶ順序の目安:
- FWER 系:Bonferroni(最も単純・保守的)→ Holm(段階降下で一様に優越、 迷ったらこれ)。 ANOVA後の全ペア比較は Tukey HSD(スチューデント化範囲分布でペア間相関を織り込む)。
- FDR 系:Benjamini-Hochberg(探索・大規模検定の標準)と、 真の帰無割合 $\pi_0$ を推定して検出力を上げる Storey の $q$ 値。
- 再標本化:順列検定+maxT / Westfall-Young。 検定間の依存構造を仮定せず同時分布から補正でき、 相関の強い設計で鋭い。
- 設計・運用:事前登録で検定計画を固定し、 探索的 vs 確証的を明示。 補正は検出力を保険料として払うトレードオフだと理解する(膨張の数値実験は多重検定ページ)。
関連ページ:仮説検定 / p 値 / t 検定 / 分散分析 / FDR / 検出力 / 効果量 / 順列検定 / 事前登録 / 第 1 種過誤 / 偽陽性 / 相関 / 多重検定