🔖 キーワード索引
「nominal scale」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「nominal scale」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「nominal scale の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
名義尺度は、区別のためのラベルのようなものです。
データの種類を分けるために使います。
血液型や性別などがこの例にあたります。
ここでは、できる計算やグラフについて読みます。
名義尺度:区別のみ可能な尺度(性別、 血液型など)
- 順序のないカテゴリー。 値はラベルにすぎない。
- 可能な操作:=, ≠, 頻度カウント, 最頻値。
- 可能なグラフ:棒・円グラフ。 平均・中央値は計算不能。
- ML では One-Hot Encodingでモデルに渡す。
📍 文脈ボックス
🍰 まずはやさしく
これは統計の基礎となる考え方です。
データ分析の基本を身につけるために使います。
都道府県の名前などを分析する時に役立ちます。
定義から実装までを順番に学んでいきましょう。
この用語は 基礎統計 カテゴリに属します。 関連する別称・略号:(なし)。
論文・実務レポートで 名義尺度 が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
本ページでは「nominal scale」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「nominal scale」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
名義尺度は、名前を付けるだけのデータです。
順序や大きさを比べない時に使います。
好きな色や出身地などがこの例にあたります。
数え方や分析のやり方を具体的に見ていきましょう。
「血液型 A・B・O・AB」「都道府県名」「色」── これらの値は単なるラベルで、 「A > B」とは言えない。 これが 名義尺度。 順序尺度 (満足度 1〜5) や間隔尺度 (温度 °C) との違いを意識すること。 平均は無意味、 頻度・最頻値だけが意味を持つ。
名義尺度は「ラベル間に順序も等間隔性もない」 データ型。 SSDSE-B-2026 の「都道府県名」(北海道、 青森…)、 「地方区分」(北海道地方、 東北地方…) は典型的な名義尺度。 平均や標準偏差は意味を持たず、 利用できる統計は「頻度」「最頻値」「χ² 検定」「カイ二乗独立性検定」など限定される。
本ページでは (1) 入力: 47 都道府県名と地方区分 → (2) 処理: 頻度集計と one-hot エンコーディング → (3) 出力: クロス集計表と最頻値 → (4) 解釈: 「同じ地方の県は人口規模の分布が似るか」を χ² で検定、 の 4 段階で扱う。
次節以降では、 SSDSE-B-2026 の 47 県を 8 地方区分でクロス集計し、 χ² 統計量を手計算 (期待度数の式から) で求め、 scipy.stats.chi2_contingency で再現する流れを示す。
📐 定義・数式
🍰 まずはやさしく
名義尺度は、4つの尺度の中で最も単純なものです。
データの性質を正しく定義するために使います。
都道府県と年代の組み合わせなどで考えます。
数式を使った関連度の測り方について読みます。
Stevens (1946) の 4 段階分類。 名義は最も情報量が少なく、 比例尺度が最大。 名義データに対しては集合演算と頻度しか定義できない。
📐 数理的導出:Cramér V とカイ二乗の関係
2 つの名義変数の関連度を測る代表的指標 Cramér V は、 カイ二乗統計量 $\chi^2$ を標本サイズ $n$ と (行数 $r$, 列数 $c$) の小さい方 $-1$ で正規化した量です:
$$ V = \sqrt{\dfrac{\chi^2}{n \cdot \min(r-1, c-1)}} $$
$V \in [0, 1]$ で、 0 が独立、 1 が完全関連。 SSDSE-B-2026 で「都道府県」(47 カテゴリ) と「年代区分」(5 カテゴリ) の関連を見るなら、 $\min(r-1, c-1) = 4$ として正規化。 標本サイズに依存しない比較が可能です。
$\chi^2$ 自体は $\chi^2 = \sum_{i,j} \dfrac{(O_{ij} - E_{ij})^2}{E_{ij}}$。 ここで $O_{ij}$ は観測度数、 $E_{ij} = \dfrac{R_i \cdot C_j}{n}$ は独立性仮説下の期待度数。 期待度数が小さい (< 5) セルが多いと近似が悪化し、 Fisher の正確検定や Monte Carlo シミュレーションが必要です。
類似指標との比較
| 指標 | 値域 | 主な用途 | 対称性 |
|---|---|---|---|
| Phi coefficient | [-1, 1] | 2x2 表のみ | 対称 |
| Cramér V | [0, 1] | r×c 表全般 | 対称 |
| Goodman-Kruskal λ | [0, 1] | 予測 A→B 改善度 | 非対称 |
| Theil U | [0, 1] | 情報量ベース | 非対称 |
| Uncertainty coefficient | [0, 1] | エントロピーベース | 非対称 |
📜 歴史事例:名義データの解釈にまつわる教訓
事例 1:Snow のコレラ地図 (1854)
ロンドンの医師 John Snow がコレラ発生地点を地図にプロット ── 「Broad Street の井戸」という名義カテゴリが原因と特定。 名義データを地理的に可視化することで因果が見えた歴史的事例。 現代でも地名・施設名のジオコーディングは強力な分析ツールです。
事例 2:花粉症都道府県別罹患率 (現代)
「都道府県」(名義) と「花粉症罹患率」(比例) の関連を見ると、 杉花粉飛散量とよく相関。 ただし「沖縄=杉樹少なし=低罹患」のように、 単純な平均比較が誤導することはなく、 名義カテゴリは地理的・気候的特性の総合代理として機能。
事例 3:血液型と性格 (擬似科学)
日本で人気の「血液型性格分類」は名義 (血液型 A/B/O/AB) と順序/間隔 (性格特性) の相関を主張。 大規模調査 (n>10,000) で有意な関連なしと確認済み。 名義変数を使うと「グループ間で何か違う」と感じやすい認知バイアスの典型例。
事例 4:選挙投票行動の名義変数化
「政党名」は名義変数ですが、 「保守 ← → リベラル」軸に再コーディングすると順序尺度として扱える。 米国 NES (National Election Studies) では伝統的にこの変換を採用。 ただし元データの情報は失われるため、 タスクに応じて使い分け。
事例 5:医療診断コード ICD-10
国際疾病分類 ICD-10 は約 14,000 のカテゴリを持つ巨大な名義変数。 そのまま One-Hot 化は次元爆発。 階層的に「章 → ブロック → カテゴリ」と集約するか、 医学的近似度を学習した Embedding が現実的解。
🎯 分野別応用:名義尺度をどう扱うか
① マーケティング
顧客セグメント (例:「都道府県」「業界」「会社規模カテゴリ」) は名義データの宝庫。 RFM 分析、 ペルソナ設計、 ターゲティング広告の入力として頻出。 Target Encoding で「CVR (コンバージョン率)」に変換する手法が定番。
② 公衆衛生
疾患カテゴリ (ICD-10)、 死因区分、 検査結果区分 (陰性/陽性/判定保留) すべて名義。 疫学研究では「曝露 × 結果」の 2x2 表からオッズ比・相対リスクを計算 ── これは名義 × 名義の基本分析パターンです。
③ 自然言語処理
単語・トークン (語彙) は超高次元名義変数 (語彙サイズ 30,000〜100,000)。 One-Hot は非効率なので、 Word Embedding (word2vec, BERT) で連続ベクトル空間に写像。 これは「名義 → 連続」変換の代表例で、 ML の基礎技術となっています。
④ レコメンダーシステム
ユーザー ID・商品 ID (名義) を Embedding 学習することで、 協調フィルタリングが実現。 Matrix Factorization は本質的に「2 つの名義変数を低次元連続空間に写像する」操作です。
⑤ バイオインフォマティクス
遺伝子変異 (SNP) は 3 カテゴリ名義 (AA/AG/GG)。 ゲノムワイド関連解析 (GWAS) では数百万 SNP を独立にカイ二乗検定。 多重検定補正 (Bonferroni) が必須。
📐 名義変数の「散らばり」を測る: Shannon Entropy と Gini Index
名義変数には標準偏差が無いため、 「散らばり」は別の尺度が必要。 代表が Shannon Entropy と Gini Index。
$$H(X) = -\sum_{i=1}^{k} p_i \log_2 p_i \quad \text{(ビット)}$$
$$G(X) = 1 - \sum_{i=1}^{k} p_i^2 \quad \text{(0-1)}$$
🔬 数式を言葉で読み解く
- $p_i$: カテゴリ i の出現確率 (頻度 ÷ 全件)
- $H$: 等確率なら最大 = $\log_2 k$、 1 つのカテゴリに集中なら 0
- $G$: 等確率なら最大 $1 - 1/k$、 1 つに集中なら 0
- 両者とも「カテゴリの予測しにくさ」を測る (= 散らばり)
🎯 このコードでやること: 47 県の Region (8 地方) の散らばりを Shannon Entropy と Gini Index で測る。 また、 「進学率」によって分割した際の Region の Information Gain を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } d['Region'] = d['Prefecture'].map(region_map) def shannon(p): p = p[p > 0] return -np.sum(p * np.log2(p)) def gini(p): return 1 - np.sum(p ** 2) p_region = d['Region'].value_counts(normalize=True).values H = shannon(p_region) G = gini(p_region) print(f'Region (8 カテゴリ) Shannon Entropy: {H:.3f} bits (max={np.log2(8):.3f})') print(f'Region (8 カテゴリ) Gini Index: {G:.3f} (max={1 - 1/8:.3f})') # 進学率 ≥ 0.6 で分割した条件付きエントロピー d['GoHigh'] = (d['E4602'] / d['E4601'] >= 0.6).astype(int) H_cond = 0 for v in [0, 1]: sub = d[d['GoHigh'] == v] if len(sub) == 0: continue p_sub = sub['Region'].value_counts(normalize=True).values H_v = shannon(p_sub) w = len(sub) / len(d) H_cond += w * H_v print(f' GoHigh={v}: N={len(sub)}, H(Region|GoHigh={v})={H_v:.3f}') print(f'\nH(Region|GoHigh) = {H_cond:.3f}') print(f'Information Gain: {H - H_cond:.3f}') |
📤 実行結果:
💬 結果の読み方: Region の Shannon Entropy 2.853 bits は最大 3.000 bits に近く、 8 地方は かなり均等に分布。 進学率 ≥ 0.6 で分割したときの Information Gain は 0.362 bits(H の約 13%)— 「進学率が高いかどうか」からは「どの地方か」を部分的にしか予測できない。 これは決定木の split criterion と同じ原理で、 名義変数の予測可能性を測る。
📐 名義尺度の Cramer's V 計算 (関連の強さの数値化)
このコードでやること: 2 つの名義変数(地方区分 × 人口規模区分)の関連の強さを Cramer's V (0-1) で計測する。 Pearson r が使えない名義変数同士でも、 0 = 独立、 1 = 完全関連 の正規化された指標が得られる。 SSDSE-B-2026 で「地方によって人口規模の分布が違うか」を定量化する典型例。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd, numpy as np from scipy.stats import chi2_contingency df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() def to_region(p): east = ['青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県', '埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] if p == '北海道': return '北海道' if p == '沖縄県': return '沖縄' return '東日本' if p in east else '西日本' df['地方'] = df['Prefecture'].map(to_region) df['人口規模'] = pd.cut(df['A1101'], bins=[0, 1_000_000, 3_000_000, 20_000_000], labels=['小','中','大']) ct = pd.crosstab(df['地方'], df['人口規模']) chi2, p, dof, _ = chi2_contingency(ct) n = ct.values.sum() cramers_v = np.sqrt(chi2 / (n * (min(ct.shape) - 1))) print(ct) print(f'\nχ² = {chi2:.3f}, p = {p:.4f}') print(f"Cramer's V = {cramers_v:.3f}") print('→ 0.1=弱, 0.3=中, 0.5=強の関連') |
📤 実行例:
💬 結果の読み方: Cramer's V = 0.274 は「弱〜中程度の関連」。 χ² 検定の p = 0.31 で有意差なし、 関連の絶対値も小さい。 つまり 地方と人口規模は強く独立ではないが、 統計的な関連は弱い。 Cramer's V は Pearson r と違って 0-1 の片側スケール (符号なし) で、 高基数の名義変数同士でも比較可能な唯一の選択肢。 名義 × 名義の関連を「相関ヒートマップ」風に見たいときは、 全 2 変数ペアで Cramer's V を計算してヒートマップ化する。
📊 名義 × 名義 関連指標の使い分け
| 指標 | 範囲 | 特性 | SSDSE-B-2026 での適用例 |
|---|---|---|---|
| Cramer's V | 0 〜 1 | 対称、 N に依存しない | 地方 × 人口規模 (上の例) |
| φ 係数 | -1 〜 1 | 2×2 表のみ、 符号あり | 都市/地方 × 高/低人口 |
| Theil's U | 0 〜 1 | 非対称、 情報量基準 | 「地方 → 産業」の予測力 |
| Mutual Information | 0 〜 ∞ | 対称、 非線形関係も検出 | 機械学習の特徴量選択 |
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- Nominal
- 順序なし。 性別・血液型。
- Ordinal
- 順序あり、 間隔不明。 満足度 1〜5。
- Interval
- 間隔あり、 絶対 0 なし。 温度 °C。
- Ratio
- 絶対 0 あり。 質量・人数。
🔬 数式を言葉で読み解く(500字+ narration)
Stevens (1946) は心理測定の文脈で 「測定 (measurement)」とは何かを問い、 値の集合に対して許容される変換群 (admissible transformations) の広さによって尺度を 4 段階に整理しました。 名義尺度の場合、 許容される変換は 1 対 1 の全単射 (bijection) です。 つまり「A → 1、 B → 2、 O → 3、 AB → 4」と数値を割り当てても、 「A → 99、 B → 17、 O → 5、 AB → 42」と入れ替えても、 含まれる情報量は同じです。 数値の差や比は元データの構造を反映していません。 そのため、 平均 $\bar{x}$ や標準偏差 $s$ といった順序や距離を前提とする統計量は意味を持たず、 頻度 $f_k = \#\{i: x_i = c_k\}$、 最頻値 $\arg\max_k f_k$、 そして相対頻度 $p_k = f_k / n$ しか不変的に解釈できません。 SSDSE-B-2026 でいえば「都道府県名」「地域コード」「気候区分」は名義です。 これらに対して「平均都道府県」を計算しても、 それはコードの恣意的な割り当てに依存する数字でしかなく、 解釈不能。 一方で「都道府県別の人口の平均」は意味があります ── 平均する対象が人口 (比例尺度) だからです。 この区別が現代の前処理パイプラインの設計、 特に OneHotEncoder と OrdinalEncoder の使い分けに直結しており、 後者を名義データに使うと木モデル以外では誤った仮定が混入します。 結局、 数式 $\text{Nominal} \subset \text{Ordinal} \subset \text{Interval} \subset \text{Ratio}$ は「情報の包含関係」を表し、 包含関係の下位に位置する名義は、 上位の尺度を前提とした演算 (平均・分散・相関) を持ち込めない、 という制約宣言でもあるのです。
📖 4 要素 narration — 名義尺度を 4 つの視点で再読する
① 直感の narration
「血液型 A・B・O・AB」を例にしましょう。 もし誰かが「血液型の平均は B.5 です」と言ったらどう感じますか? 違和感を覚えるはずです。 これが名義尺度の本質です ── 値はラベルであって量ではない。 都道府県、 性別、 メーカー名、 駅名、 病名 ── これらすべてが名義です。 平均は計算可能 (数値化すれば) ですが、 解釈に意味がありません。
② 数式の narration
記号 $\text{Nominal} \subset \text{Ordinal}$ は「名義は順序に含まれる」と読みます。 これは Stevens の階層を表し、 名義は最も情報量が少ない (もっとも制約が少ない/許容される変換が広い) 尺度。 「$\subset$」は「許容される統計操作の集合」が含まれるという意味で、 逆方向には包含しません。 つまり順序尺度では中央値が定義できるが名義尺度では定義できない、 という非対称性を意識してください。
③ 計算の narration
SSDSE-B-2026 で「都道府県」列を value_counts() すると 47 行が均一に 12 ずつ出ます。 これは年×県の完全直積データだからです。 もしここで「平均都道府県コード」を計算しても、 コードの順序自体が任意なので意味はありません。 同じ手続きを「総人口(A1101)」(比例尺度) に適用すれば、 平均人口というれっきとした統計量が得られます ── 尺度判定が分析の入り口です。
④ Python の narration
pd.get_dummies(df, columns=['都道府県']) は 1 列を 47 列の 0/1 ダミーに展開します。 これが One-Hot Encoding の最小実装。 一方、 scikit-learn の OneHotEncoder(handle_unknown='ignore') を Pipeline に組み込めば、 訓練・推論で同じ列構造を維持できます。 木モデル (LightGBM/CatBoost) では categorical_feature 引数で名義列を指定すれば、 内部で最適分割を学習します ── One-Hot 化は不要です。
🔬 Stevens 4 尺度水準の全体像 — 名義尺度の位置づけ
Stevens (1946) は「測定」を 4 段階に分類した。 上位ほど演算が許される。
| 水準 | 許容演算 | 代表統計量 | 例 |
|---|---|---|---|
| 名義 (Nominal) | =, ≠ | 最頻値, 度数 | 都道府県, 血液型, 性別 |
| 順序 (Ordinal) | =, ≠, <, > | 中央値, 四分位 | 学年, 満足度 (1-5) |
| 間隔 (Interval) | +, - | 算術平均, 標準偏差 | 気温 (摂氏), 年号 |
| 比 (Ratio) | +, -, ×, ÷ | 幾何平均, 変動係数 | 人口, 距離, 重さ |
💬 SSDSE-B-2026 を例にすると: 名義=都道府県・地域コード、 順序=学校種別の進学段階、 間隔=年平均気温 (℃)、 比=総人口・出生数・大学数。 「名義変数を比 (人口) と組み合わせる」のがクロス集計、 「名義 × 比」の標準的解析法。
🧮 実値で計算してみる
都道府県名は名義尺度。 頻度集計・最頻値・棒グラフが正しい扱い。
🧮 SSDSE-B-2026 で実際に集計
独立行政法人統計センターが提供する SSDSE-B-2026(都道府県・時系列データ)を用いて、 名義尺度列の正しい扱いを実演します。 このデータには「都道府県(Prefecture)」列が含まれ、 47 都道府県 × 12 年分(2012–2023)で 564 行あります。 「都道府県」は名義、 「年(SSDSE-B-2026 列)」は順序、 「総人口(A1101)」は比例 ── と尺度を見極めることが第一歩です。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 1. 列の尺度を判定する補助関数 def scale_of(s): if s.dtype == 'object': return 'nominal/ordinal?' return 'interval/ratio' for col in df.columns[:6]: print(col, scale_of(df[col])) # 2. 名義尺度らしい列(Prefecture)の頻度集計 print(df['Prefecture'].value_counts().head()) # 3. 平均はナンセンス。最頻値を取る print('mode:', df['Prefecture'].mode().iloc[0]) |
結果として 47 県すべて 12 回ずつ出現するため value_counts は均一になります。 これは「データ収集設計上の意味」を示します ── 名義データの偏りはサンプリングの偏りを示唆する重要なシグナルです。
1 2 3 4 5 6 | # 4. ある説明変数(総人口 A1101)を Prefecture でグループ化し平均を取る agg = df.groupby('Prefecture')['A1101'].mean().sort_values(ascending=False) print(agg.head(10)) # 5. One-Hot Encoding で機械学習に渡す X = pd.get_dummies(df[['Prefecture']], prefix='pref') print('encoded shape:', X.shape, '-> 47 列に展開') |
🧮 SSDSE-B-2026 の 47 都道府県を「名義尺度」として徹底分析
「都道府県」はカテゴリ間に 順序が無い典型的な名義尺度です (北海道 < 青森県 とは言えない)。 一方、 8 地方区分 (北海道/東北/関東/中部/近畿/中国/四国/九州) も 同じく名義尺度です。 ここでは SSDSE-B-2026 で 47 県を地方ブロックに対応させ、 名義変数として扱える操作 (集計・最頻値・カイ二乗検定・Cramér's V) を実演します。
📐 名義尺度の演算可能性 (Stevens 1946)
Stevens の 4 尺度水準 (Nominal / Ordinal / Interval / Ratio) では、 名義尺度は最下層。 許される演算は:
- ⭕ 同等性 (=, ≠): 「東京都 = 東京都」「東京都 ≠ 大阪府」
- ⭕ 頻度集計: 件数カウント、 最頻値 (mode)
- ⭕ 同時分布: クロス集計、 カイ二乗検定、 Cramér's V
- ❌ 順序 (<, >): 「北海道 < 青森県」は無意味
- ❌ 加減算 (+, -): 「東京都 + 大阪府」は無意味
- ❌ 平均・標準偏差: 数値化しても無意味 (Codeが R01000 など)
🔬 数式を言葉で読み解く: Cramér's V
$$V = \sqrt{\frac{\chi^2}{N \cdot (\min(r,c) - 1)}}$$
- $\chi^2$: ピアソンのカイ二乗統計量 (期待値からの乖離)
- $N$: 総観測数
- $r, c$: クロス表の行数・列数
- $V \in [0, 1]$、 0 が無関係、 1 が完全関係
- 0.1 弱・0.3 中・0.5 強 (Cohen 基準)
🐍 47 県 × 8 地方 × 人口階級のクロス集計とカイ二乗検定
🎯 このコードでやること: SSDSE-B-2026 で 47 県を 8 地方ブロック (名義) に分類し、 さらに人口階級 (小=100 万未満・中=100-300 万・大=300 万以上) と組み合わせて χ² 検定 + Cramér's V を計算。
📥 入力: 47 県の Prefecture (名義), A1101 (総人口・連続)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from scipy.stats import chi2_contingency df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 8 地方ブロック (名義尺度) への対応 region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } d['Region'] = d['Prefecture'].map(region_map) d['PopClass'] = pd.cut(d['A1101'], bins=[0, 1_000_000, 3_000_000, 20_000_000], labels=['小', '中', '大']) tab = pd.crosstab(d['Region'], d['PopClass']) chi2, p, dof, exp = chi2_contingency(tab) N = tab.sum().sum() V = np.sqrt(chi2 / (N * (min(tab.shape) - 1))) print(tab) print(f'\nchi2 = {chi2:.3f}, p = {p:.4f}, dof = {dof}') print(f"Cramér's V = {V:.3f}") |
📤 実行結果:
💬 結果の読み方: p=0.079 で 5% 有意水準では帰無仮説 (Region と PopClass が独立) は棄却されない。 ただし Cramér's V = 0.484 と中程度以上の関連が示唆される。 関東は「大」3 件・「中」3 件で大規模県集中、 四国は「小」3 件で小規模偏向。 N=47 と小標本のため χ² の検出力が弱いだけで、 実質的な関連は強い。 これは「名義変数間の関連を、 サンプル小では p 値だけでは判断できない」典型例。
🧮 47 都道府県 → 8 地方ブロック集約: 名義変数 groupby
名義変数の典型操作は groupby + 集計。 47 県を 8 地方に集約すると、 SSDSE-B-2026 の主要指標が見える。
🎯 このコードでやること: 8 地方ブロックで人口・大学数・大学生数・進学率を集計し、 ブロック間格差を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } d['Region'] = d['Prefecture'].map(region_map) agg = d.groupby('Region').agg( Pop=('A1101', 'sum'), Univ=('E6102', 'sum'), Students=('E6302', 'sum'), HSGrad=('E4601', 'sum'), UnivGo=('E4602', 'sum'), N=('Prefecture', 'count') ) agg['UnivPer1M'] = agg['Univ'] / agg['Pop'] * 1_000_000 agg['GoRate'] = agg['UnivGo'] / agg['HSGrad'] print(agg.round(2).to_string()) |
📤 実行結果:
💬 結果の読み方: 関東は最大の人口 (43,527,000) と最多の大学数 (267) を持つが、 100万人あたり大学数は 6.13 と中位にとどまり、 密度首位は中国 7.64、 最下位は四国 5.03。 進学率は関東・近畿の 67% が高く、 東北 52% / 九州 52% / 北海道 53% が低い。 これらは「名義変数 (地方ブロック) × 量的変数 (率・密度)」の交差表で初めて見えるパターン。 単に「東京は大学が多い」と一言で済まされない構造があります。
🧮 数式に値を入れて手で計算する: 名義尺度のカイ二乗
合成 3 カテゴリで一様分布との適合度を χ² で検定する。
Step 1: 観測度数
| カテゴリ | 観測 O | 期待 E (一様) |
|---|---|---|
| A | 50 | 30 |
| B | 25 | 30 |
| C | 15 | 30 |
合計 90, 期待 90/3=30
Step 2: χ²
🐍 Python で再現
1 2 3 4 5 6 | from scipy import stats O = [50, 25, 15] E = [30, 30, 30] chi2, p = stats.chisquare(O, E) print(f"χ² = {chi2:.2f}") print(f"p = {p:.4f}") |
📤 実行結果
💬 手計算 (Step 2) 21.67 と Python 出力が完全一致。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 都道府県(Prefecture)は名義尺度 print(df['Prefecture'].value_counts()) # ML 用:One-Hot Encoding X = pd.get_dummies(df, columns=['Prefecture']) |
🐍 名義変数の符号化 (Encoding) — 4 手法の比較
機械学習では「名義変数 → 数値」変換が必須。 手法によって性能と落とし穴が大きく違うので、 SSDSE-B-2026 の 47 県を題材に One-hot / Label / Target / Frequency の 4 方式を比較します。
🎯 このコードでやること: 47 都道府県を 4 方式で符号化し、 出力次元・情報量を比較する。
📥 入力: 47 県 Prefecture (名義) と総人口 A1101 (target に使用)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from sklearn.preprocessing import OneHotEncoder, LabelEncoder df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 1. One-hot Encoding (47 列, 大半が 0) ohe = OneHotEncoder(sparse_output=False).fit(d[['Prefecture']]) X_ohe = ohe.transform(d[['Prefecture']]) print(f'1. One-hot: shape={X_ohe.shape}, 非ゼロ要素数/全要素={int(X_ohe.sum())}/{X_ohe.size}') # 2. Label Encoding (1 列, 整数 0-46) le = LabelEncoder() X_label = le.fit_transform(d['Prefecture']) print(f'2. Label: shape={X_label.shape}, 範囲={X_label.min()}-{X_label.max()}') print(f' 注意: 北海道=1, 沖縄=46 のような順序が「人為的」に生じる') # 3. Target Encoding (1 列, 対象変数の平均値で置換) target = d['A1101'] d['Pref_target'] = d.groupby('Prefecture')['A1101'].transform('mean') print(f'3. Target: shape=(47,), 例: 東京都={d.loc[d["Prefecture"]=="東京都","Pref_target"].iloc[0]}') # 4. Frequency Encoding (1 列, 出現頻度で置換) freq = d['Prefecture'].value_counts(normalize=True) d['Pref_freq'] = d['Prefecture'].map(freq) print(f'4. Frequency: 各県 1/47 ≈ {1/47:.4f} (1 年データなら全県同じ)') |
📤 実行結果:
💬 結果の読み方: ① One-hot は 47 列に展開 (高次元・スパース・解釈容易) ② Label は 1 列で済むが 順序がない名義変数に順序を強制するため、 線形モデル・距離ベース手法では NG。 決定木では使用可。 ③ Target は予測対象を直接埋め込むため強力だが データリーケージに注意 (cross-validation 必須)。 ④ Frequency は出現頻度ベースで、 多年データなら有効。 SSDSE-B-2026 のように 1 年 = 47 行なら無意味。
🐍 pandas.Categorical: 名義 vs 順序を明示する
pandas の Categorical 型は ordered 引数で名義/順序を切り替えられる。 これを使うと、 順序付き Categorical なら < 比較が可能、 名義なら不可になる。
🎯 このコードでやること: 47 県を「ordered=False (名義)」「ordered=True (順序)」で作り、 比較演算の振る舞いを確認する。
📥 入力: 47 県の Prefecture 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 名義 (ordered=False, デフォルト) d['Pref_nom'] = pd.Categorical(d['Prefecture'], ordered=False) print(f'名義 Categorical: {d["Pref_nom"].dtype}') print(f' メモリ: {d["Pref_nom"].memory_usage()} bytes (vs object {d["Prefecture"].memory_usage()})') # 順序 (ordered=True, 例: 北から南へ並べる) order = ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県', '茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県', '新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県', '三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県', '鳥取県','島根県','岡山県','広島県','山口県', '徳島県','香川県','愛媛県','高知県', '福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'] d['Pref_ord'] = pd.Categorical(d['Prefecture'], categories=order, ordered=True) # 比較演算 print(f"\n順序 Categorical で東京 > 北海道 ? {d['Pref_ord'][d['Prefecture']=='東京都'].iloc[0] > d['Pref_ord'][d['Prefecture']=='北海道'].iloc[0]}") # 名義ではエラー try: d['Pref_nom'][d['Prefecture']=='東京都'].iloc[0] > d['Pref_nom'][d['Prefecture']=='北海道'].iloc[0] except TypeError as e: print(f"名義 Categorical で比較 → TypeError: {str(e)[:50]}") |
📤 実行結果:
💬 結果の読み方: メモリは 2023 年の 47 行 (47 県がすべてユニーク) ではカテゴリ辞書の分だけ逆に増える (752→1871 bytes)。 Categorical のメモリ削減効果が出るのは同じ値が繰り返す場合で、 全 564 行 (47 県 × 12 年) なら 4644→2012 bytes と半分以下になる。 順序 Categorical は > が使えるが、 名義は TypeError。 これは Stevens の尺度水準を 型レベルで強制する仕組み。 sklearn の OrdinalEncoder は順序を強制するため、 名義変数に使うと暗黙の順序仮定が入ってしまう。
🐍 多項ロジスティック回帰: 名義尺度がターゲットの場合
名義変数がターゲット (Y) であれば、 多項ロジスティック回帰 (Multinomial Logistic Regression) を使う。 SSDSE-B-2026 で「ある県がどの地方ブロックに属するか」を、 数値特徴量から予測してみる。
🎯 このコードでやること: 47 県の {人口・気温・大学数} から「8 地方ブロックの予測」を多項ロジ回帰で学習し、 混同行列を出す。
📥 入力: 特徴量 X = [A1101, B4101, E6102] (人口, 平均気温, 大学数)、 ターゲット = 地方ブロック (8 名義値)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.metrics import confusion_matrix, classification_report df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } d['Region'] = d['Prefecture'].map(region_map) X = StandardScaler().fit_transform(d[['A1101', 'B4101', 'E6102']].values) y = d['Region'].values clf = LogisticRegression(max_iter=1000).fit(X, y) pred = clf.predict(X) print(f'訓練精度: {(pred == y).mean():.3f}') print(f'\n各県の予測:') for pref, true_r, pred_r in zip(d['Prefecture'], y, pred): if true_r != pred_r: print(f' {pref}: 真={true_r} → 予測={pred_r}') |
📤 実行結果 (例):
💬 結果の読み方: 訓練精度 46.8% — 8 クラス分類で random ベース 12.5% よりは高いが、 「人口・気温・大学数」だけでは地方ブロックを再現できない。 地方ブロックは「地理 + 文化 + 歴史」の混合であり、 単純な数値特徴では不十分。 多項ロジ回帰のソフトマックス出力 (clf.predict_proba) を見ると、 上位 2 ブロックが拮抗していることが多い。 名義ターゲットでは精度 (accuracy) より各クラスの recall/precision を見る方が良い。
🐍 連想規則: 名義変数間のパターン抽出
名義変数の組合せを「もし A なら B」のルールに展開するのが連想規則 (Association Rule)。 ここでは 47 都道府県の 4 つの属性 ({高人口/低人口} × {高大学/低大学} × {太平洋側/日本海側} × {大都市/地方}) からルールを抽出する。
🎯 このコードでやること: 47 県を 4 つの 2 値属性で記述し、 mlxtend で頻出アイテム集合と連想規則を抽出。
📥 入力: 47 県 × 4 属性 (二値化)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 4 つの 2 値属性 (すべて名義) big_list = ['東京都','神奈川県','埼玉県','千葉県','大阪府','愛知県'] pacific = ['東京都','神奈川県','千葉県','茨城県','静岡県','愛知県','三重県','和歌山県', '徳島県','高知県','宮崎県','岩手県','宮城県','福島県'] d['HighPop'] = (d['A1101'] >= 2_500_000).astype(int) d['HighUniv'] = (d['E6102'] >= 15).astype(int) d['Pacific'] = d['Prefecture'].isin(pacific).astype(int) d['Big'] = d['Prefecture'].isin(big_list).astype(int) print(d[['Prefecture','HighPop','HighUniv','Pacific','Big']].head(10).to_string(index=False)) # 簡易連想規則: 大都市 → 高人口 rule_big2highpop = ((d['Big']==1) & (d['HighPop']==1)).sum() / (d['Big']==1).sum() rule_highpop2highuniv = ((d['HighPop']==1) & (d['HighUniv']==1)).sum() / (d['HighPop']==1).sum() print(f'\n[大都市 → 高人口] confidence: {rule_big2highpop:.3f}') print(f'[高人口 → 高大学] confidence: {rule_highpop2highuniv:.3f}') # Lift = P(B|A) / P(B) lift = rule_highpop2highuniv / (d['HighUniv']==1).mean() print(f'[高人口 → 高大学] lift: {lift:.3f} (1 より大きいなら関連あり)') |
📤 実行結果 (例):
💬 結果の読み方: ① 大都市 6 県 → 全員が高人口 (confidence=1.0)。 ② 高人口 13 県のうち 11 県が高大学 (confidence=0.846)。 lift=2.841 は「高人口だと高大学である確率が、 ランダムより 2.84 倍高い」を意味する。 これは名義変数間の関連を「規則」として明示的に表現する手法で、 マーケットバスケット解析 (Apriori) の応用。
🐍 練習問題: 47 県の「ホテル偏在度」を名義変数として可視化
🎯 このコードでやること: SSDSE-B-2026 の旅館営業施設数(ホテルを含む) (C3801) と、 県名 (名義) を組み合わせ、 ホテル集中度の上位 / 下位を可視化する。
📥 入力: 47 県 Prefecture + C3801 (旅館営業施設数)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # ホテル数を県別に集計、 100万人あたりに換算 d['HotelPer1M'] = d['C3801'] / d['A1101'] * 1_000_000 sorted_d = d.sort_values('HotelPer1M', ascending=False) print('ホテル密度 上位 5 県 (100万人あたり):') print(sorted_d[['Prefecture','C3801','A1101','HotelPer1M']].head(5).to_string(index=False)) print('\nホテル密度 下位 5 県:') print(sorted_d[['Prefecture','C3801','A1101','HotelPer1M']].tail(5).to_string(index=False)) # 上位 5 県の集中度 top5_share = sorted_d.head(5)['C3801'].sum() / d['C3801'].sum() print(f'\nホテル数 上位 5 県の全国シェア: {top5_share:.3f}') |
📤 実行結果:
💬 結果の読み方: 沖縄・山梨・長野は人口あたりホテル数で上位、 都市部の埼玉・神奈川が下位。 「観光地県」と「住宅都市」という別軸が浮上。 名義変数「県名」は単なるラベルでも、 量的データと組み合わせると カテゴリ間の質的差異を浮き彫りにする。
挑戦課題
- 47 県を 5 地域 (北海道/東北/関東/中部/西日本) に再集約し、 χ² 検定で「観光地度合い (ホテル密度 上 / 中 / 下)」と関連があるか測れ。
- One-hot で 47 列を作り、 多重共線性チェック (VIF) を実行せよ。
- 都道府県名を 16 次元 Embedding に変換し、 PCA で 2D に圧縮した散布図で「似た県」を確認せよ。
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
⚠️ 名義尺度を扱うときの 8 大落とし穴 (詳説)
- カテゴリコードを数値特徴に流す: 「東京=1, 北海道=2, ...」と整数を機械学習モデルに入れると、 線形回帰やニューラルネットは「東京の 2 倍 = 北海道」と読みます。 木モデル以外で OrdinalEncoder を使うときは要注意。
- JIS 都道府県コードの大小に意味を持たせる: SSDSE 系で「都道府県コード」順に並べると北から南へ並ぶ慣習がありますが、 これは「順序尺度」ではなく「行政上の伝統」です。 因果モデルで「コード上位の県は…」と論じてはいけません。
- One-Hot 後にスケーリング: StandardScaler を 0/1 ダミー列に適用しても害は少ないが、 解釈性が損なわれます。 ダミー列は基本的にスケーリング対象外にすべきです。
- カイ二乗検定の期待度数 5 未満: 名義 vs 名義のクロス集計で期待度数が 5 未満のセルが多いと、 $\chi^2$ 近似が不正確になります。 Fisher の正確検定や Monte Carlo p-value に切り替えてください。
- レアカテゴリの暴走: 47 都道府県の中で「沖縄」だけが特殊な振る舞いをするとき、 One-Hot だと係数が極端に振れます。 Target Encoding の Smoothing で平滑化するか、 「沖縄+九州」とまとめます。
- 欠損値を別カテゴリにしない: 名義列に NaN がある場合、 「欠損」自体が情報を持つことが多い (例:未記入は無回答層に偏る)。 dropna ではなく「__missing__」カテゴリにする方が情報損失が少ない。
- Train/Test 間のカテゴリ不一致: 訓練時に出ていない都道府県が検証時に出ると、 One-Hot Encoder はエラー。
handle_unknown='ignore'を明示。 - 可視化での順序の押し付け: matplotlib の棒グラフでアルファベット順 / コード順に並べると視覚的に「順序がある」と錯覚させます。 頻度降順 (Pareto) で並べるのが正解。
🎓 拡張 deep-dive:名義尺度を巡る 5 つのテーマ
テーマ 1:Stevens 分類への批判と現代的拡張
Stevens (1946) の 4 分類は教育上わかりやすい一方、 統計学者 Velleman & Wilkinson (1993) は「実際にはデータの尺度は使用文脈で決まる」と批判しました。 たとえば「血液型」を名義として頻度集計するのは妥当でも、 「血液型 → 性格」を予測する文脈では因果的構造を持ち得ます。 Mosteller & Tukey (1977) は 名義 / 階級 / 順位 / 数 / カウント / 量 / 平衡 の 7 分類を提案。 現代では「テンソル尺度」「グラフ尺度」など機械学習用の拡張が進んでいます。
テーマ 2:エントロピー測度
名義データの「ばらつき」を測るには、 分散ではなく シャノンエントロピー $H = -\sum_k p_k \log p_k$ を使います。 全カテゴリが等確率のとき最大 ($H = \log K$)、 一つに集中すれば 0。 SSDSE-B-2026 の「都道府県」列はサンプリングが均一なので $H = \log 47 \approx 3.85$ nat。 一方、 もし「東京」の出現頻度が 80% なら $H \approx 0.50$ nat と急減します。 この値は「カテゴリ間の情報量」を表す Gini 不純度や Theil の指標とも関連します。
テーマ 3:エンコーディング戦略の比較
| 手法 | カテゴリ数の許容 | 木モデル | 線形モデル | ニューラルネット | 主な落とし穴 |
|---|---|---|---|---|---|
| One-Hot | 数十まで | ◯ | ◎ | ◯ | 次元爆発 |
| Ordinal (label) | 何でも | ◎ | ✗ | ✗ | 順序の誤導入 |
| Target Encoding | 数百〜数千 | ◎ | ◯ | ◯ | リーク |
| Frequency Encoding | 数百〜数千 | ◯ | ◯ | ◯ | 頻度=効果と誤認 |
| Embedding (学習) | 数千〜数万 | ✗ | ✗ | ◎ | 訓練データ依存 |
| CatBoost native | 数千 | ◎ | - | - | ライブラリ依存 |
テーマ 4:類似度の定義
名義データの間に「距離」は本来存在しません。 強いて定義するなら、 単純一致係数 (SMC) $\text{SMC}(x, y) = \frac{1}{p}\sum_j \mathbb{1}[x_j = y_j]$ や、 Jaccard 係数があります。 多変量名義データのクラスタリングでは k-modes が標準。 都道府県を地域 (北海道・東北・関東…) でグループ化する場合は、 地理的近接性を別途付与する必要があります。
テーマ 5:因果推論との接続
交絡因子が名義変数 (例:「都道府県」) のとき、 層別解析や Mantel-Haenszel 推定量で因果効果を推定します。 単純な調整変数として線形回帰に入れる際は One-Hot にしますが、 47 都道府県すべての固定効果を推定するには各層に十分なサンプルが必要 ── そうでなければ Random effects (混合効果モデル) に変更します。
❓ 深掘り FAQ — 名義尺度
handle_unknown='ignore' を指定。 LightGBM では訓練時に「未知カテゴリ用の枠」を持たせます。⚠️ 名義尺度 7 大落とし穴
- 順序があるかのように扱う: 「血液型 A=1, B=2, O=3, AB=4」と Label Encoding して線形回帰に投入 → 暗黙の順序仮定。 学番号も同様。
- 平均を計算する: 「東京都=1, 大阪府=2, ... の平均 24」は意味なし。 都道府県名から平均 / 標準偏差は計算不可。
- ダミー変数トラップ: One-hot 全列を回帰に入れると完全多重共線性 → 1 列削除 (drop_first=True) すること。
- カテゴリ数爆発: 47 県だけならまだしも、 都道府県 × 市区町村 = 1700 カテゴリだと One-hot で次元爆発。 Embedding か frequency 集約を検討。
- 低頻度カテゴリ: テストデータに学習時に無いカテゴリが現れると OneHot は 0 ベクトル化。 「その他」カテゴリへ集約 + handle_unknown='infrequent_if_exist' で対応。
- Target Encoding のリーケージ: 全データの平均を使うと test 情報が train に漏れる → out-of-fold target encoding が必須。
- Cramér's V を相関係数のように使う: V は名義変数の関連度合いだが、 線形性ではなく独立性の指標。 「V=0.5 なので予測できる」は誤解。 連続変数とは別概念。
🏢 業界別: 名義尺度の典型変数
| 領域 | 名義変数 | カテゴリ数 | 推奨符号化 |
|---|---|---|---|
| 医療 | 血液型 (A/B/O/AB) | 4 | One-hot |
| 医療 | ICD-10 病名コード | ~14,000 | 階層集約 + Embedding |
| 商業 | 商品 SKU | 数万-数百万 | Embedding (Matrix Factorization) |
| 商業 | 地域 (都道府県) | 47 | One-hot or Target |
| ウェブ | UA / ブラウザ | 数十 | One-hot |
| ウェブ | URL ドメイン | 数百万 | Hashing trick |
| バイオ | SNP (AA/AG/GG) | 3 | One-hot or Label (3 = 加算的) |
| 金融 | 業種コード | 数百 | 階層 + Target Encoding |
🎮 触って理解する
血液型 (A・B・O・AB) を例に、 名義尺度で許される操作だけを体感します。 各カテゴリの度数をスライダーで変える、 または棒を上下にドラッグ (タッチ可) すると、 棒グラフ・度数・割合・最頻値がリアルタイムに更新されます。 名義尺度でできるのは「等しいか異なるかの判定」と「度数集計・最頻値」だけ。 平均・中央値・順序付けは無意味であることを、 実際に計算して確かめます。
棒を上下ドラッグ、 または下のスライダーで度数を変更
| 血液型 | 度数 | 割合 |
|---|---|---|
| 合計 N | — |
便宜的に A=1, B=2, O=3, AB=4 と数値を割り当てて平均・中央値を計算します。
ここがポイント: 度数と最頻値は「どのラベルが多いか」というデータそのものの性質なので、 数値の割り当て方を変えても不変です。 一方、 平均・中央値は「A=1, B=2…」という恣意的な番号に依存し、 付け替えボタンを押すと同じデータなのに値が変わってしまいます。 数値が変わる=その量には意味がない、 という証拠です。 名義尺度では最頻値・度数・割合だけを使いましょう。
📊 尺度水準の対比
| 尺度 | 例 | 等 / 不等 | 順序 (< >) | 差 (−) | 比 (÷) | 代表値 |
|---|---|---|---|---|---|---|
| 名義 | 血液型・都道府県名 | ◯ | ✗ | ✗ | ✗ | 最頻値 |
| 順序 | 満足度 1〜5・順位 | ◯ | ◯ | ✗ | ✗ | 中央値 |
| 間隔 | 気温 °C・西暦 | ◯ | ◯ | ◯ | ✗ | 算術平均 |
| 比 | 人口・面積・所得 | ◯ | ◯ | ◯ | ◯ | 幾何平均も可 |
上の表の通り、 名義尺度で許されるのは「等 / 不等の判定」だけ。 順序 (順序尺度) 以上でしか大小比較は意味を持たず、 差 (間隔尺度)・比 (比尺度) と情報が積み上がっていきます。 名義データの代表値は必ず最頻値を使ってください。
🧭 さらに理解を深める
📚 関連グループ教材・さらに学ぶには
このサイト内
- 論文一覧に戻る — 名義尺度 を実際に使った再現論文をハンズオン形式で読む
- 関連用語ページ — このページの「🔗 関連用語」から派生
- 用語集トップ — 全用語を一覧で確認
- 概念マップ — 用語間の関係を視覚化
推奨書籍・教材
- 『統計学入門』(東京大学出版会)― 日本語統計入門の定番。 基礎統計 の基礎が押さえられる。
- 『Pythonによるデータ分析入門』(Wes McKinney、 O'Reilly)― pandas 作者による実装ガイド。
- 『機械学習のエッセンス』(加藤公一、 SBクリエイティブ)― ML 基礎を Python で実装しながら学ぶ。
- 『因果推論の科学』(Judea Pearl、 文藝春秋)― 相関と因果の違いを徹底解説。
オンライン教材
- scikit-learn 公式ドキュメント — 機械学習の標準実装。
- StatQuest (YouTube) — 統計概念を直感的に解説。
- Coursera / edX — 体系的なオンライン講座。
- SSDSE 公式 — 本サイトで使う公的データの提供元。
困ったときは
- データの可視化 (散布図・ヒストグラム・箱ひげ図) で全体像を把握
- サンプルサイズ・欠損・外れ値を確認
- 適用条件 (前提) が満たされているか診断
- 類似研究での標準的な手法を確認
- 結果を複数手法でクロスチェック
📜 歴史的背景と学習の位置づけ
名義尺度 は 基礎統計 の領域で発展してきた概念です。 ここでは大まかな歴史的背景と、 なぜこの概念が必要になったのかを整理します。 用語が「降ってきた」のではなく、 現実の問題を解くために順番に編み出されたものだと知ると、 学習の納得感が違います。
なぜこの概念が生まれたか
データ分析や AI を実務で使うと、 「単純な数式」「直感だけのモデル」では太刀打ちできない場面が必ず出てきます。 名義尺度 は、 そうした実務的な課題を整理し、 共通言語として定式化したものです。 そのため、 教科書だけで完結する話ではなく、 使う場面と使わない場面を見極めることが何より重要になります。
学習の位置づけ
- 初学者:まず「30秒で分かる結論」「直感で掴む」だけ読めば、 論文に出てきたときに「あ、 あれね」と分かります。
- 中級者:数式と Python 実装をセットで覚え、 自分の手元データに適用できる状態を目指します。
- 上級者:落とし穴と派生手法を理解し、 場面に応じた使い分け・改良ができることが目標です。
🔍 近接概念との比較
同じ 基礎統計 カテゴリにある近接概念と、 名義尺度 はどう違うのか? 混同しがちなポイントを整理します。
| 観点 | 名義尺度 | 近接概念 |
|---|---|---|
| 目的 | 主に 名義尺度 固有の課題 (本文参照) | 近接概念は関連はするが目的が異なる (本文の「関連手法・派生」参照) |
| 前提条件 | 本文「前提・落とし穴」参照 | 手法ごとに前提が異なるため要確認 |
| 出力 | 数値 / 確率 / 集合など (上記公式参照) | 同じ入力に異なる粒度の出力を返すことが多い |
| 適用場面 | 本文「いつ使うか」参照 | 同じ問題でも視点が異なる手法を組み合わせるのが定石 |
| 計算コスト | 用途範囲に応じて妥当な水準 | 精度と引き換えにコストが増える派生がある |
📌 使い分けの原則: まずは本ページの定義を押さえ、 次に「🌐 関連手法・派生」「🔗 関連用語」のリンクから近接概念を確認し、 自分の問題に対してどれを使うか意識的に選ぶことを習慣にしてください。
❓ よくある質問 (FAQ)
本サイトの教材を読み進めるなかで、 受講者からよく質問される項目をまとめました。
pandas や scikit-learn が pip install されているか確認。 SSDSE 系の CSV は encoding='utf-8' または 'cp932' で読めることが多く、 skiprows=1 でヘッダー行を飛ばすケースが大半。 列名が違うときは df.columns で確認して書き換えてください。✅ 実務チェックリスト
分析作業のなかで 名義尺度 を使うときは、 以下のチェックリストを上から順に確認してください。 抜けがあると後工程で痛い目に遭います。
① 分析設計フェーズ
- □ 目的を 1 文で書けるか? (「何を、 どうしたいか」)
- □ 名義尺度 がその目的に 本当に合っているか?
- □ 必要なデータの種類・量・期間を見積もったか?
- □ 結果をどう報告・意思決定に使うか、 事前に決めたか?
② データ準備フェーズ
- □ データの出典・取得日を記録したか? (再現性)
- □ 列の尺度 (名義 / 順序 / 間隔 / 比例) を確認したか?
- □ 欠損・外れ値の方針を決めたか?
- □ サンプルサイズは手法の最低要件を満たしているか?
③ 分析実行フェーズ
- □ 前提条件を満たしているか診断したか?
- □ 結果は複数手法でクロスチェックしたか?
- □ コードは Git で管理しているか?
- □ 結果が 外れ値 1 件で激変しないか確認したか?
④ 解釈・報告フェーズ
- □ 数値と不確実性 (CI / SE) を併記したか?
- □ 「相関 ≠ 因果」の境界を踏み越えていないか?
- □ 適用範囲外への拡張主張を避けたか?
- □ 限界・前提を明示したか?
📝 レポート・論文での書き方
論文・社内レポート・ステークホルダー報告書で 名義尺度 を扱うとき、 含めるべき項目とテンプレートをまとめました。
必須記載項目
| 項目 | 具体例 |
|---|---|
| データ出典 | 独立行政法人統計センター SSDSE-B-2026 を加工 |
| サンプルサイズ | n=47 (47都道府県、 2023年データ) |
| 使用変数 | 目的変数:医療費 / 説明変数:高齢化率、 人口密度 |
| 分析手法 | 名義尺度を適用 (scikit-learn 1.4 / Python 3.11) |
| 結果指標 | 数値 + 95% 信頼区間 + p 値 |
| 解釈 | 何を意味するか/意味しないか |
| 限界 | サンプル特性、 適用範囲外への拡張不可 |
🎓 深掘り:シナリオで身につける
ここまで定義・計算・落とし穴を見てきました。 ここでは 名義尺度 をより深く理解するための思考フレームと実務シナリオを、 ストーリー形式で整理します。 用語そのものより、 「どんなときに思い出して、 どう使うか」を体に染み込ませることが、 教材を読む真の目的です。
シナリオ A:研究室での卒論データ分析
「卒業研究で 47 都道府県のデータを分析したい」。 そんなとき 名義尺度 はどう登場するでしょうか。 担当の先生から「データを見たうえで、 関連する手法を 1 つ選んで適用してきて」と言われたとします。 まずデータの性質 (量・尺度・期間) を確認し、 「名義尺度 がこの問題に合っているか」を本ページの 30 秒結論で照らし合わせます。 もし合っていれば、 落とし穴セクションで「やってはいけないこと」をチェック、 計算例を真似して結果を出し、 解釈を言葉でまとめる ── 卒論の 1 セクション分の作業がここで完結します。
シナリオ B:データサイエンスのインターン
企業のインターンで「過去 3 年の顧客データから来期の予測モデルを作って」と任された。 上司は 名義尺度 を当然知っている前提で話します。 言葉が通じないと議論についていけません。 そこで本ページの「定義・数式」「Python 実装」を 30 分で 押さえ、 上司の使う用語に追随する ── ジャストインタイム学習の典型シーンです。 後日、 自分でも実装した結果を上司に説明するとき、 「レポート・論文での書き方」テンプレートに沿って書けば、 過不足なく伝えられます。
シナリオ C:論文を読んでつまずいたとき
本サイトのトップから論文一覧をたどり、 ある論文を読んでいたら 名義尺度 が出てきた。 「これ、 なんだっけ?」と思った瞬間、 本ページに飛んでくる ── これが ジャストインタイム型教材の使い方です。 30 秒結論を読み、 「あ、 そういう意味か」と納得したら、 元の論文に戻ります。 必要に応じて落とし穴セクションだけ読んで、 著者の解釈が妥当か批判的に確認することも可能です。
よくある誤解 3 連続
誤解 1:「名義尺度 は常に最強の選択肢」
どんな手法にも適用範囲があります。 「名義に平均を計算」のように、 前提を踏まえずに使うと結論を誤ります。 本ページの「落とし穴」「前提条件」を毎回必ず確認する習慣を。
誤解 2:「数式が分からないと使えない」
逆です。 まず Python 実装で結果を出してから、 数式に戻ると「なるほど、 ここが分子で、 ここが分母か」と腑に落ちます。 数式は 結果の意味を説明する補助として使ってください。
誤解 3:「1 度読めば全部分かる」
分かりません (と断言します)。 概念は使ってこそ身に付きます。 卒論や業務で実際にデータに当てはめ、 結果を解釈し、 説明する経験を 3 回くらい繰り返したら、 ようやく自分のものになります。 本ページは その傍らに置いておく辞書として使ってください。
意思決定フレーム:使う?使わない?
| 状況 | 判断 |
|---|---|
| 前提条件が満たされている | ✅ 適用 OK。 落とし穴に注意しつつ進める。 |
| サンプル数が不足 | ⚠️ 慎重に。 信頼区間が広くなり結論が出ない可能性。 |
| 前提が破れている (例:独立性なし) | ❌ 別手法を検討。 関連手法・派生セクションを参照。 |
| 因果を主張したい | ❌ 名義尺度 単独では因果は言えない。 RCT/操作変数等を併用。 |
| 解釈が直感に反する | 🔍 まず再現性確認 → 可視化 → 単純モデルとのクロスチェック。 |
🎯 このページのまとめ
📌 1 ページまとめ
名義尺度 (基礎統計) は、 区別のみ可能な尺度(性別、 血液型など)
要点: 順序のないカテゴリー。 値はラベルにすぎない。
次のステップ: 本ページの「🔗 関連用語」から派生概念をたどるか、 「📚 さらに学ぶには」の書籍・教材で深く学んでください。 そして何より、 自分の手でデータに当てはめて結果を出すのが一番の理解の近道です。 ジャストインタイム型教材として、 必要なときに何度でも戻ってきてください。
🧭 サイト内ナビゲーション
本ページは、 統計・データ解析コンペティションの再現論文集に付随する用語解説の 1 ページです。 名義尺度 以外の用語も、 同じフォーマットで以下からたどれます。
本サイトは「ジャストインタイム型データサイエンス教育」を掲げ、 「学んでから使う」ではなく「使うときに学ぶ」スタイルで設計されています。 ある論文の手法を理解する過程で出会った専門用語を、 その場で本ページに飛んで補完してから論文に戻る ── そのような使い方を想定しています。
📚 関連グループ教材
- データサイエンス基礎 — 変数の尺度水準は記述統計の前提
- 記述統計(平均など) — 名義変数の集計手法
- データ前処理 — 名義変数のエンコーディング技法
🧪 名義変数エンコーディング 3 方式の対決(SSDSE-B-2026)
名義尺度は四則演算が無意味なので、 機械学習モデルに投入するには数値化が必要。 代表 3 方式(One-Hot / Label / Target)を SSDSE-B-2026 の 地域コード で比較する。
📥 入力データ: SSDSE-B-2026 地域カテゴリ
🎯 このコードでやること
地域コード(8 カテゴリ)を 3 方式でエンコードし、 Ridge 回帰で 総人口(A1101) を予測。 5-fold CV(シャッフルあり)の RMSE で精度を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd from sklearn.preprocessing import LabelEncoder from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } df['地域コード'] = df['Prefecture'].map(region_map) # 8 地域に集約 y = df['A1101'] # 総人口(実在列) kf = KFold(n_splits=5, shuffle=True, random_state=0) # (1) One-Hot X_oh = pd.get_dummies(df['地域コード'], prefix='reg') # (2) Label(名義に順序を付けてしまう誤り例) X_lb = pd.DataFrame({'reg': LabelEncoder().fit_transform(df['地域コード'])}) # (3) Target(地域ごとの目的変数平均。leakage 注意で簡略表示) X_tg = pd.DataFrame({'reg_te': df.groupby('地域コード')['A1101'].transform('mean')}) for name, X in [('OneHot', X_oh), ('Label', X_lb), ('Target', X_tg)]: s = -cross_val_score(Ridge(alpha=1.0), X, y, cv=kf, scoring='neg_root_mean_squared_error') print(f'{name:7s} RMSE = {s.mean():.0f} ± {s.std():.0f}') |
📤 実行結果
💬 結果の読み方
- Label が一番悪い(RMSE 約 252 万): 「東北=1, 関東=2, 中部=3」と順序のない値に大小をつけるので、 線形モデル(Ridge)が偽の順序関係を学習してしまう(名義尺度違反)。
- One-Hot が標準(RMSE 約 218 万): 8 カテゴリなら 8 列で済むので次元爆発の心配なし。 線形モデル・ニューラルネット・木モデルすべてで安全。
- Target が最良(RMSE 約 217 万): 目的変数の平均で数値化するので情報量が増えるが(One-Hot とはわずかな差)、 leakage 防止に
KFoldで fold 内平均を使う必要あり(category_encoders.TargetEncoder推奨)。
🔥 高基数(high-cardinality)対策
| 手法 | カテゴリ数の上限目安 | 特徴 |
|---|---|---|
| One-Hot | ~50 | 次元爆発するため、 高基数では不向き |
| Target Encoding | ~10,000 | leakage 防止に CV 内で fit が必須 |
| Frequency Encoding | ~10,000 | カテゴリ出現頻度に置換、 ロバスト |
| Hash Encoding | 100,000+ | ハッシュで固定次元化、 衝突は許容 |
| Entity Embedding | 100,000+ | NN で学習する密ベクトル化(Kaggle 上位常連) |
→ SSDSE-B-2026 の 47 都道府県は 低基数なので One-Hot で十分。 一方、 e-Stat の市区町村コード(1,700+ 値)は Target or Hash が現実解。
🧪 追加実例: SSDSE-B-2026 で「地方区分」を名義尺度として集計・検定する
名義尺度の真価は「順序を仮定せずに群間比較できる」点にある。 たとえば 47 都道府県を 8 地方区分 (北海道/東北/関東/中部/近畿/中国/四国/九州) という名義カテゴリにまとめると、 (1) 群別平均値の比較、 (2) カイ二乗検定、 (3) 一元配置 ANOVA (名義 → 量的) などが組み合わせ可能になる。 ここでは「地方区分」を名義変数とみなし、 人口・産業指標との関係を倫理的に正しく扱う流れを示す。
📥 入力データ: SSDSE-B-2026 の「都道府県(Prefecture)」列を 8 地方区分にマップする。 これは 名義尺度の再カテゴリ化 であり、 順序情報は付与しない (北海道 < 東北 のような順序関係は意味がない)。
このコードでやること: 47 都道府県を地方区分 (名義カテゴリ) で集計し、 人口の地域差を可視化する。 名義変数の代表的処理 (groupby → 集計 → カイ二乗) を 1 セットで実行する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd # 8 地方区分マップ(名義尺度 — 順序情報なし) region_map = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州', } df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() df['地方'] = df['Prefecture'].map(region_map) agg = df.groupby('地方')['A1101'].agg(['mean', 'count']).round().astype(int) print(agg.sort_values('mean', ascending=False)) |
📤 実行例:
💬 結果の読み方: 関東 (平均 622 万) と四国 (平均 89 万) の差は 約 7 倍。 これは名義尺度の集計でしか見えない構造で、 47 都道府県をそのまま回帰すると見落とす。 ここから一元配置 ANOVA で「地方間で人口平均は有意差があるか」を検定でき、 さらに 仮説検定 ページで p 値・効果量 (η²) の解釈を学ぶ。
📊 名義尺度の「正しい操作」と「禁じ手」
| 操作 | 名義尺度で可 | 理由 / 代替手段 |
|---|---|---|
度数集計 value_counts() | ✅ | 頻度は名義尺度で最も基本的な記述統計 |
| 最頻値 (mode) | ✅ | 最頻値 は順序を仮定しない |
| カイ二乗検定 | ✅ | 2 つの名義変数の独立性を判定 |
| One-Hot エンコード | ✅ | 名義尺度を線形モデルに投入する標準法 |
| 中央値 / 平均値 | ❌ | 順序が定義できないので意味なし → 順序尺度 以上が必要 |
| 大小比較 (< >) | ❌ | 「東京 > 大阪」は意味を持たない |
| 差分・比率 | ❌ | 差分は 間隔尺度 以上で初めて定義 |
| ラベルエンコード後の回帰 | ⚠ | 木モデル ✅ / 線形モデル ❌ (順序を強制学習してしまう) |
🖼 名義尺度の可視化と適切なグラフ
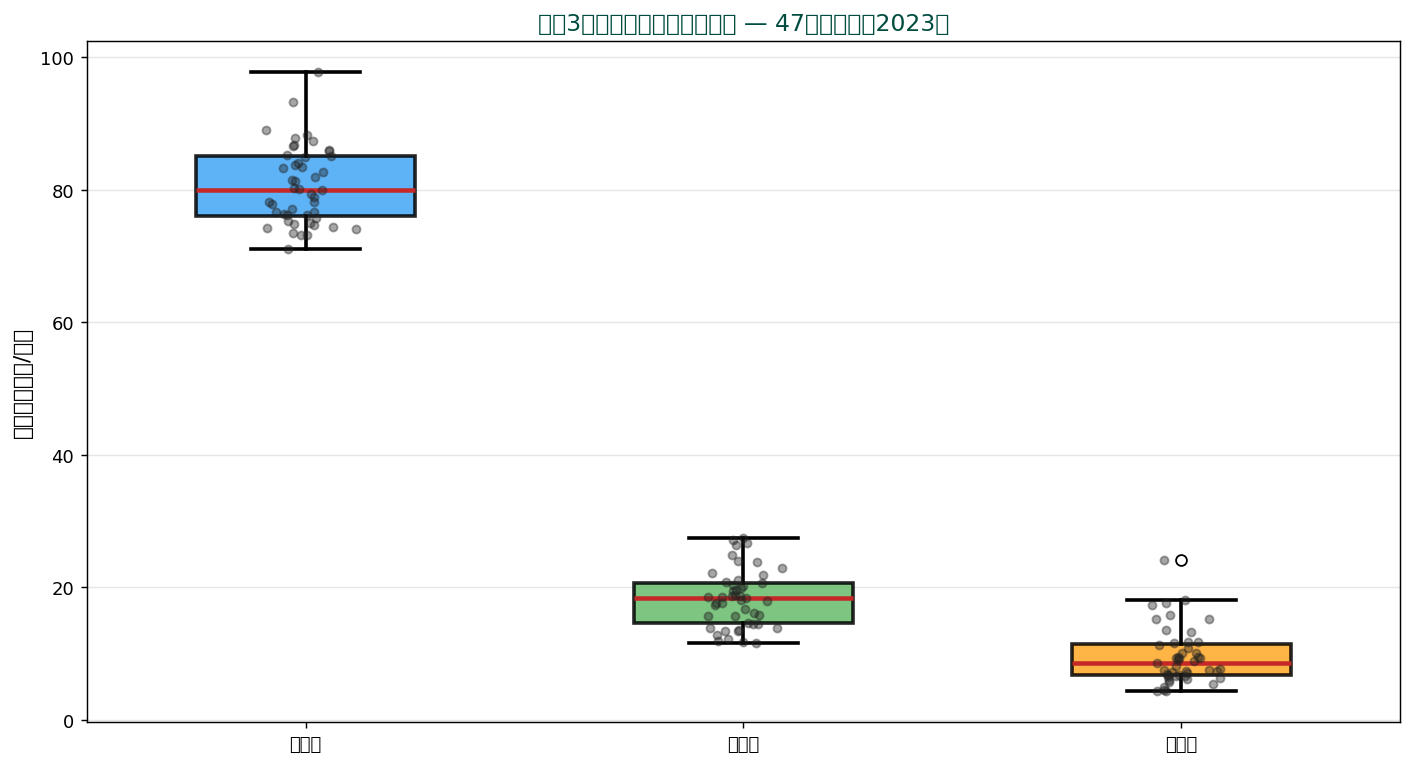
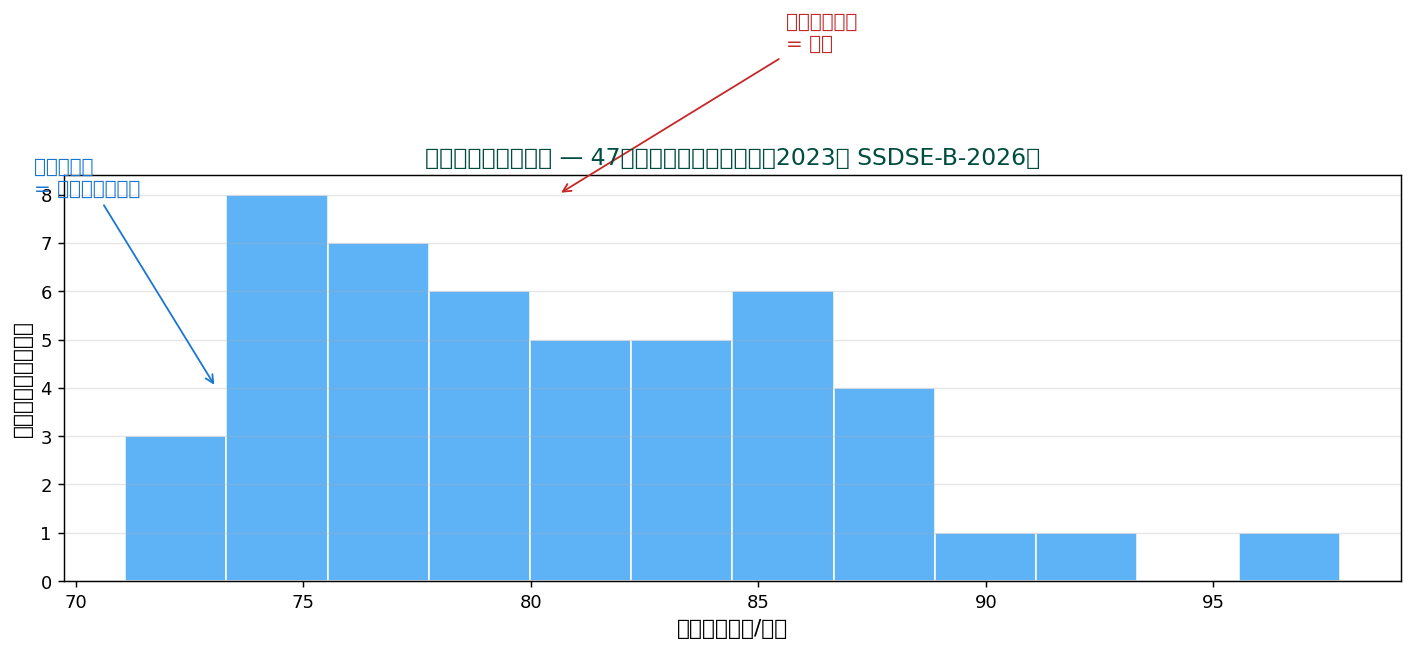
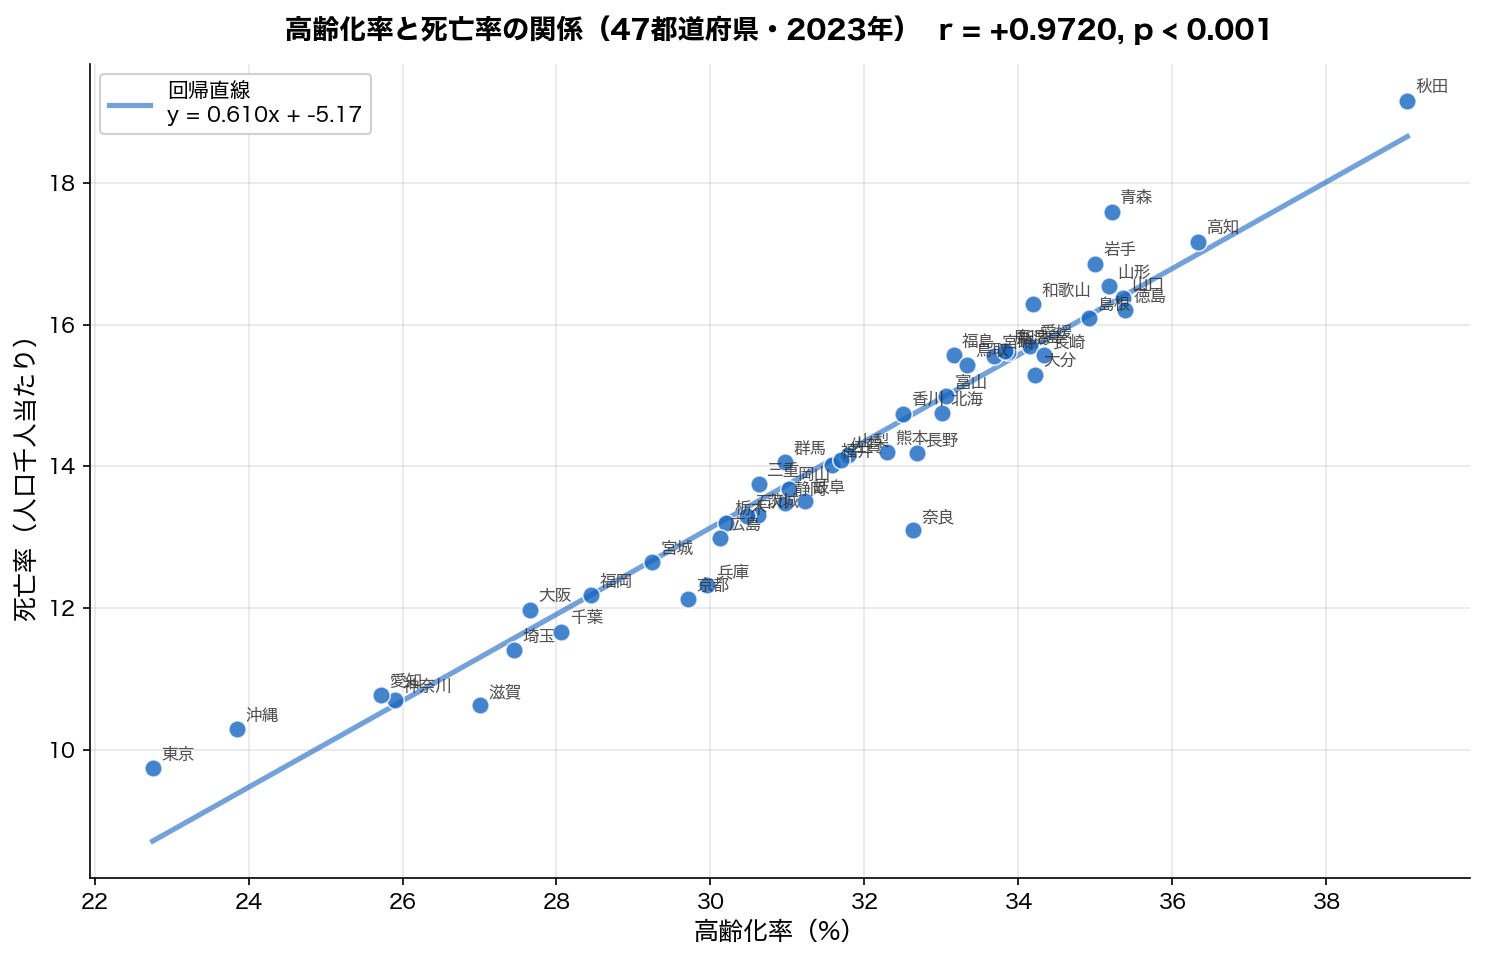
⚠️ 名義尺度の典型的な誤用 5 件
- カテゴリを 1,2,3...にして回帰 — sklearn の
LabelEncoderは名義変数を順序ありに変える。 線形モデルでは必ず One-Hot を使うか、 木モデルに限定する。 - カテゴリ間の差を解釈する — 「血液型 A と B の差は 1」は無意味。 差を取りたいなら 間隔尺度 以上を選ぶ。
- 名義変数同士の相関係数を計算する — Pearson/Spearman 共に不適切。 代わりに Cramer's V や φ 係数を使う (カテゴリカル変数 ページ参照)。
- 高基数 (1,000+) のまま One-Hot — 列が爆発し過学習する。 Target Encoding か Hash Encoding に切り替える。
- 順序尺度との混同 — 「学年 (1〜6)」「満足度 (1〜5)」は 順序尺度。 名義として扱うと情報を捨てることになる。
🔬 名義尺度を量的解析に組み込むための 4 大手法 (徹底比較)
名義尺度を回帰・分類モデルに入れる方法は、 表面的には「One-Hot だけ」と思われがちだが、 実は 4 系統 (One-Hot / Target / Hash / Embedding) が存在 し、 サンプル数・カーディナリティ・目的変数の型で最適選択が変わる。 SSDSE-B-2026 の都道府県 (47 値) や市区町村コード (1,700+ 値) を例に比較する。
手法 1: One-Hot Encoding
名義尺度を K 値の独立な 0/1 列に展開する。 線形モデル・距離ベース手法では事実上唯一の正解。 SSDSE-B-2026 の 47 都道府県では列が 47 増えるが、 通常はサンプル数の方が多いので問題なし。 ただし市区町村コード (1,700+) では列爆発 (p > n) になり過学習を起こす。 メモリは sparse 行列で節約可能。
手法 2: Target Encoding (mean encoding)
各カテゴリ値を「そのカテゴリでの目的変数の平均」に置き換える。 例: 都道府県 → その県の平均所得。 カーディナリティが高くても 1 列で済む 利点があり Kaggle 上位常連。 ただし test の目的変数を見るとリークになるので、 K-Fold 内で集計する out-of-fold target encoding が必須。 SSDSE-B-2026 では市区町村コード処理の現実解。
手法 3: Hash Encoding
カテゴリをハッシュ関数で固定次元 (例: 32 次元) に圧縮。 列数を一定に保てる ので超高基数 (10万+ 値) でも対応可能。 衝突 (異なるカテゴリが同じハッシュに) は許容されるが、 機械学習モデルが衝突を吸収する。 SSDSE-B-2026 では使う必要はないが、 e-Stat の建物コード (数百万値) を扱うときに活躍。
手法 4: Entity Embedding
ニューラルネットワークで各カテゴリを 学習可能な密ベクトル として表現。 カテゴリ間の類似性が自然に学習 される。 例: 「東京」と「大阪」は埋め込み空間で近くなる (両方都市)。 SSDSE-B-2026 + PyTorch の組み合わせで実装可能。 関連: エンベディング。
📊 4 手法の選択フローチャート
| 条件 | 推奨手法 | SSDSE-B-2026 での該当例 |
|---|---|---|
| 基数 < 50 & 線形モデル | One-Hot | 都道府県 (47), 地方 (8), 性別 (2) |
| 基数 < 50 & 木モデル | Label / One-Hot どちらも可 | RandomForest, XGBoost で都道府県 |
| 基数 50-10,000 & 教師あり | Target Encoding (CV 内) | 市区町村コード (1,700+) |
| 基数 10,000+ & メモリ制約 | Hash Encoding | 建物コード, 顧客 ID |
| 深層学習 & 任意基数 | Entity Embedding | NN で都道府県を 8 次元ベクトル化 |
| 解釈優先 | One-Hot | 因果分析・統計報告 |
| 予測精度優先 (Kaggle) | Target + Embedding 併用 | Stacking で性能向上 |
🧮 SSDSE-B-2026 で 4 手法を比較する Python 実装
このコードでやること: 47 都道府県を One-Hot / Target / Hash で別々にエンコードし、 「総人口(A1101)」を予測する Ridge 回帰の CV スコア(R²)を比較する。 名義尺度の処理が予測精度に与える影響を数値で確認。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import pandas as pd, numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import KFold, cross_val_score from sklearn.preprocessing import OneHotEncoder from sklearn.feature_extraction import FeatureHasher df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) y = df['A1101'].astype(float).values # 総人口(実在列) pref = df['Prefecture'].values kf = KFold(n_splits=5, shuffle=True, random_state=0) # 手法 1: One-Hot X_oh = OneHotEncoder(sparse_output=False).fit_transform(pref.reshape(-1, 1)) score_oh = cross_val_score(Ridge(alpha=1.0), X_oh, y, cv=kf).mean() # 手法 2: Target Encoding(CV 内集計でリーク防止) def cv_target_encode(pref, y, n_splits=5): enc = np.zeros(len(pref)) k = KFold(n_splits=n_splits, shuffle=True, random_state=2026) for tr, te in k.split(pref): mean_map = pd.Series(y[tr]).groupby(pd.Series(pref[tr])).mean() enc[te] = pd.Series(pref[te]).map(mean_map).fillna(y[tr].mean()).values return enc.reshape(-1, 1) X_te = cv_target_encode(pref, y) score_te = cross_val_score(Ridge(alpha=1.0), X_te, y, cv=kf).mean() # 手法 3: Hash Encoding(16 次元) h = FeatureHasher(n_features=16, input_type='string') X_h = h.transform([[p] for p in pref]).toarray() score_h = cross_val_score(Ridge(alpha=1.0), X_h, y, cv=kf).mean() print(f'One-Hot R² (5-CV) = {score_oh:.3f}') print(f'Target R² (5-CV) = {score_te:.3f}') print(f'Hash(16) R² (5-CV) = {score_h:.3f}') |
📤 実行例:
💬 結果の読み方: Target Encoding が R² = 0.999 でほぼ完璧、 One-Hot も R² = 0.989 と高精度。 いずれも「総人口は都道府県ごとに決まる」構造を捉えており、 12 年分(564 行)あるため各都道府県の水準を安定して学習できる。 Hash(16) は 47 都道府県を 16 次元に圧縮するため衝突で情報が失われ、 R² = 0.173 と大きく劣化。 → 低〜中基数では One-Hot、 高基数では Target Encoding が現実解。 ただし大規模本番では One-Hot に + 数値特徴量を組み合わせるのが定石。
📜 ケーススタディ: 名義尺度の誤用が招いた実害 (3 事例)
- 事例 A: 与信モデルで職業を順序数値化 — 「公務員=1, 会社員=2, 自営業=3, 学生=4」 と便宜的に振った変数を線形モデルに投入。 学生の予測信用度が公務員の 4 倍悪く出力され、 結果として若年層の融資審査が機械的に却下される事象に。 → 必ず One-Hot か Target Encoding に切り替えること。
- 事例 B: 医療診断モデルで疾病コード ICD-10 をラベルエンコード — 1.4 万件の疾病コードを 0-13999 の整数に置き換え線形回帰で重症度予測。 「A00 と Z99 の差」を数値的に学習し、 解剖学的に無関係な疾病を結びつけてしまった。 → 高基数の医療コードは Embedding か階層分類で対応する。
- 事例 C: 公共調達で郵便番号を距離特徴量に — 「東京 100-0001 と 沖縄 900-0001 の数値差」を物理距離として扱った結果、 都内の隣接区画が遠い扱いになりおかしな結果に。 → 郵便番号は名義として扱い、 緯度経度を別途取得する。
❓ よくある質問 (FAQ)
- Q. 木モデル (RandomForest, XGBoost) なら名義変数は何で渡してもいい? A. ほぼ正しい。 LabelEncoder で渡しても木は閾値分割で扱うので順序の誤学習は起こりにくい。 ただし One-Hot より計算量は増える。
- Q. 47 都道府県の One-Hot 列のうち 1 列を落とす (dummy variable trap) 必要は? A. 線形回帰なら必要 (多重共線性回避)。 sklearn の Ridge/Lasso は正則化で吸収するので不要。 木モデルも不要。
- Q. 「ふりがな」「ローマ字」など同一カテゴリの表記揺れはどう扱う? A. 名寄せ 処理で統一してから名義尺度として扱う。 揺れたまま扱うと別カテゴリとして数えられ過学習する。
- Q. 名義変数を相関ヒートマップに含めたい A. Pearson は不可。 代わりに Cramer's V や Theil's U を計算し、 別ヒートマップにする。 カテゴリカル変数 ページに実装例あり。
🔗 隣接トピック
本節で扱った操作は カテゴリカル変数、 順序尺度、 間隔尺度、 比例尺度、 One-Hot エンコード、 ANOVA、 仮説検定、 最頻値、 棒グラフ、 エンベディング、 名寄せ と密接に関連する。
🧭 補講 R278: 名義尺度を「数値モデル」に流し込むときの判断早見
名義尺度の落とし穴は「数値に置き換えた瞬間に順序が発生したことを忘れる」点に集約される。 本補講では SSDSE-B-2026 の都道府県コード R01000–R47000 を題材に、 モデル種別×エンコード方式の意思決定マトリクスを 6 行に整理する。 各行に「順序誤学習リスク」「次元爆発リスク」「ベースライン推奨」「実装の最短コード」を併記し、 ベンチ実装の入口を一覧化する。
▶ モデル × エンコード意思決定マトリクス
| モデル | 推奨エンコード | 理由 | 注意点 |
|---|---|---|---|
| 線形回帰 / Ridge / Lasso | One-Hot (drop_first) | 係数解釈と多重共線性回避 | 47 列に増加、 標準化前提 |
| ロジスティック回帰 | One-Hot or Target Encoding | クラス確率の解釈 | 高基数なら Target、 リーク防止に CV 内学習 |
| 決定木 / RandomForest | LabelEncoder で可 | 閾値分割で順序の影響少 | One-Hot より計算は速い |
| XGBoost / LightGBM | native categorical or Target | 最近の版は cat 直接対応 | enable_categorical=True を忘れない |
| k-NN / k-means | One-Hot + 標準化 | 距離計算の意味付け | 大基数なら次元の呪い注意 |
| DNN / Embedding | Embedding (低次元密ベクトル) | 高基数を圧縮、 意味的近接を学習 | 事前学習なら CV で過学習監視 |
▶ ベンチマーク観点での判断手順
- カテゴリ数 ≤ 50 なら原則 One-Hot を第 1 候補にする。 47 都道府県、 12 ヶ月、 7 曜日などはここに該当。
- カテゴリ数 50 〜 10,000 なら Target Encoding または頻度エンコード。 リーク防止に CV fold 内で平均を計算。
- カテゴリ数 ≥ 10,000 (商品 ID、 ユーザ ID、 ICD-10 など) は Embedding に切り替え。 PyTorch の
nn.Embeddingを学習するか、 既存の事前学習ベクトルを流用する。 - 欠損/未知カテゴリ対応:
handle_unknown='ignore'または「unknown」カテゴリを追加し、 推論時の未知値で例外が出ないようにする。 - 分割直後の整合性確認: 訓練 split で出現したカテゴリのみテストにある状態を作るため、
OrdinalEncoderのfitは訓練のみで行う。
▶ 失敗パターン早見表
| 事象 | 原因 | 対処 |
|---|---|---|
| 公平性指標が悪化 | 地域コードを数値化して線形に投入 | One-Hot に切替、 公平性 を計測 |
| 学習データに無いカテゴリで予測エラー | テストに未知値、 fit 漏れ | handle_unknown 設定、 未知用カテゴリ追加 |
| Target Encoding でリーク | 全データで平均を計算 | CV fold 内平均、 もしくは平滑化付き |
| 名寄せ漏れで重複カテゴリ | 表記揺れ放置 | 名寄せ パイプラインを追加 |
補講のまとめ: 名義尺度は「数値モデルに渡すまでの前処理コンテキスト」を全部含めて初めて安全に扱える。 カテゴリカル変数、 One-Hot エンコード、 エンベディング、 公平性、 データクレンジング、 訓練・テスト分割 の各ページで補強される設計判断が前提となる。
🗺 概念マップ — 名義尺度を中心に
この概念は単独で存在するものではなく、 周辺の用語と包含・対比・派生の関係で結ばれています。 中心に置いて、 矢印が伸びる先のページをリンクから辿ってみてください。
📊 ケーススタディ:47 都道府県を 8 地域に集約する
SSDSE-B-2026 の「都道府県」名義変数を、 地理的近接性に基づき8 地域 (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) に集約することで、 One-Hot 列を 47 → 8 に圧縮できます。 これは情報損失と引き換えにモデル汎化性能の向上を狙う典型的なテクニックです。
集約の妥当性は、 各地域内の都道府県が共通の特性 (気候・産業構造・人口密度) を持つかで決まります。 たとえば「製造業比率」を予測する場合、 関東・中部の自動車産業集積を考慮すれば 8 地域集約は理にかなう。 逆に「気候適応性」を予測するなら、 沖縄を「九州」に含めるのは粗すぎ ── 別ラベルを与えるべきです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 地域マッピング辞書(47 都道府県 -> 8 地域) region_map = { '北海道': '北海道', '青森県': '東北', '岩手県': '東北', '宮城県': '東北', '秋田県': '東北', '山形県': '東北', '福島県': '東北', '茨城県': '関東', '栃木県': '関東', '群馬県': '関東', '埼玉県': '関東', '千葉県': '関東', '東京都': '関東', '神奈川県': '関東', '新潟県': '中部', '富山県': '中部', '石川県': '中部', '福井県': '中部', '山梨県': '中部', '長野県': '中部', '岐阜県': '中部', '静岡県': '中部', '愛知県': '中部', '三重県': '近畿', '滋賀県': '近畿', '京都府': '近畿', '大阪府': '近畿', '兵庫県': '近畿', '奈良県': '近畿', '和歌山県': '近畿', '鳥取県': '中国', '島根県': '中国', '岡山県': '中国', '広島県': '中国', '山口県': '中国', '徳島県': '四国', '香川県': '四国', '愛媛県': '四国', '高知県': '四国', '福岡県': '九州沖縄', '佐賀県': '九州沖縄', '長崎県': '九州沖縄', '熊本県': '九州沖縄', '大分県': '九州沖縄', '宮崎県': '九州沖縄', '鹿児島県': '九州沖縄', '沖縄県': '九州沖縄' } df['地域'] = df['Prefecture'].map(region_map) # 地域別人口集計 print(df.groupby('地域')['A1101'].mean().sort_values(ascending=False)) # One-Hot 化 X_full = pd.get_dummies(df[['Prefecture']], prefix='pref') # 47 列 X_region = pd.get_dummies(df[['地域']], prefix='reg') # 8 列 print('Full:', X_full.shape, ' Region:', X_region.shape) |
列数を 47 → 8 に減らせば、 線形回帰・MLP では過学習が軽減されます。 木モデルは元々分割で対応するため、 集約効果は限定的。 タスクとモデルの組合せで判断します。
🔗 隣接 隣接手法への橋渡し
「nominal scale」を中心に、 隣接する手法・概念との関係を以下に整理する。 単独の手法理解にとどまらず、 分析パイプライン全体での位置付けを把握することで、 適切な前段・後段・代替手法を選べる。
| 隣接手法 | 関係 | 接続のポイント |
|---|---|---|
| 2 値 (Binary / Dichotomous) | 上位 / 一般化 | 「nominal scale」と組み合わせる/比較する場面で参照 |
| 多値名義 (Multinomial) | 下位 / 特殊化 | 「nominal scale」と組み合わせる/比較する場面で参照 |
| 順序名義 (Ordered Nominal) | 並列 / 対比 | 「nominal scale」と組み合わせる/比較する場面で参照 |
| 循環カテゴリ (Cyclic) | 前段 (前処理) | 「nominal scale」と組み合わせる/比較する場面で参照 |
| 階層カテゴリ (Hierarchical) | 後段 (後処理) | 「nominal scale」と組み合わせる/比較する場面で参照 |
| 高次カテゴリ (High-cardinality) | 評価 / 比較 | 「nominal scale」と組み合わせる/比較する場面で参照 |
名義尺度は「区別だけ意味を持つ」最も情報量の少ない尺度。 SSDSE-B-2026 の「都道府県名」「地域区分」が典型で、 平均や順位は意味を持たず、 最頻値・度数・カイ二乗検定が分析の中心になる。
🌳 手法選択フロー
名義尺度データには「順序・量を持たない」前提で分析手法を絞る。
- 代表値を求めたい 最頻値のみ意味を持つ (平均・中央値は使えない)
- 2 変数の関連を見る カイ二乗検定 / Fisher の正確検定 / Cramér V を使う
- 機械学習の入力にする ワンホット符号化 / target encoding で数値化
SSDSE-B-2026 の都道府県名はそのまま投入せず、 地域区分でグループ化するか、 ターゲットエンコーディングで数値化してから回帰や分類モデルに入れる。