🔖 キーワード索引(Round 26 拡張)
🍰 まずはやさしく
円グラフは、 まるいピザを切り分けたような絵です。
「全体のうち、 どれがどれくらいを占めているか」を一目で見せるために使います。
たとえばクラス 40 人に「好きな教科は?」と聞いて、 数学 12 人・英語 10 人・国語 8 人・理科 6 人・社会 4 人だったとき、 その割合を円で切り分けて見せるのが円グラフです。
ただし、 似た大きさのかたまりを見分けるのは苦手です。 その理由と対処法は、 このページの後半でくわしく説明します。
この章は、 このページに出てくる言葉の一覧です。 気になる言葉から読み始めても構いません。
本ページの主要キーワードを一覧表示します。 各語へのアンカー/関連ページに飛べます。
円グラフ (Pie Chart) は全体に占める構成比を扇形面積で表現するグラフで、 カテゴリ数 5 以下・合計 100% で意味を持つ。 SSDSE-B-2026 の産業別就業者数 (第 1/2/3 次産業) を県別に円グラフ化し、 構成比の地域差 (沖縄 vs 東京) を視覚化する。
これらのキーワードは「pie chart の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
円グラフは、 「全体を 100 % としたときの内訳」を見せる絵です。
棒グラフが「どっちが多い?」を比べるための絵なのに対し、 円グラフは「全体の中でどれくらい?」を伝えるための絵です。
部活の部員 50 人のうち、 1 年生 20 人・2 年生 18 人・3 年生 12 人。 これを円で切り分ければ、 「1 年生がだいたい 4 割」と一瞬で伝わります。
気をつけたいのは、 かたまりが 6 個以上になると急に読みにくくなること。 そのときは棒グラフに切り替えます。
構成比を扇形で表現
- 分野:可視化 — 📚 1変量の可視化
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
pie chart を 30 秒で把握する重要ポイント:
- 何ができるか: 全体をまるごと 1 つの円(360 度)とみなし、 項目ごとに割合の分だけ角度を配ります。 全体の 25 % なら 90 度、 50 % なら 180 度です。 記号で書けば、 項目 {c₁,...,cₙ} の値 {v₁,...,vₙ} と合計 V に対し、 角度は θᵢ = 360° × vᵢ/V。 産業別就業者構成・支出内訳・選挙得票率のように「足すと 100 % になる内訳」を見せるのが得意です。
- いつ使うか: カテゴリ数が 5 以下で、 比較対象が 1 セットのとき。 SSDSE-B-2026 の都道府県別第 1・第 2・第 3 次産業構成のように、 全体に対する比率が主たるメッセージのとき。
- 注意点: カテゴリ 6 以上では棒グラフに劣る、 3D 円グラフは前方が大きく見える錯覚、 印刷モノクロで識別不能、 ドーナツ穴やラベル外置きで読み取り精度が落ちる。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 文脈ボックス — あなたが今見ているもの
🍰 まずはやさしく
いま読んでいるのは、 「グラフの描き方」を扱う章のひとつです。
データを人に伝えるとき、 どの絵を選ぶかで伝わり方が変わります。 円グラフはその選択肢のひとつです。
身近な例では、 学校の予算の内訳や、 スマホの利用時間の内訳などがこれで描かれています。
この章では「円グラフはどの仲間に属する道具か」を確認します。 使い方のコツは次の章から始まります。
「円グラフ」は 可視化 のカテゴリに属する用語です。 項目ごとの割合を、 扇形の角度で表す基本的なグラフです。 全体の雰囲気をパッと伝えるのは得意です。 いっぽう、 細かい数字をきちんと比べたいときは棒グラフのほうが有利です。 その理由(人間の目の性質にもとづく実験結果)は「⚠️ よくある落とし穴」でくわしく扱います。
- 位置づけ:可視化 の基礎を構成する重要概念のひとつ
- 関連教材:本ページ下部の「関連グループ教材」も併読を推奨
- データ:本ページの実値計算には
SSDSE-B-2026.csv(47 都道府県 × 12 年度= 564 行 × 112 列)を使用
🎨 直感で掴む
🍰 まずはやさしく
円グラフは「まるいピザを、 割合ぶんだけ切り分けた絵」だと思ってください。
ピザ 1 枚が「全体」、 1 切れの大きさが「その項目の割合」です。
クラス 40 人に好きな教科を聞いて、 数学 12 人なら「40 人のうち 12 人 = 30 %」。 円のうち 30 % ぶん、 つまり 3 割ほどの切れはしが数学の分になります。
この章では、 その「切り分けかた」を絵として体で覚えます。 計算のしかたは次の章から出てきます。
🍕 クラスのアンケートで作ってみる
40 人のクラスで「好きな教科」を聞いたら、 次のようになったとします。
| 好きな教科 | 人数 | 割合 | 円のなかの角度 |
|---|---|---|---|
| 数学 | 12 人 | 30 % | 108° |
| 英語 | 10 人 | 25 % | 90° |
| 国語 | 8 人 | 20 % | 72° |
| 理科 | 6 人 | 15 % | 54° |
| 社会 | 4 人 | 10 % | 36° |
| 合計 | 40 人 | 100 % | 360° |
やっていることは、 じつはとても単純です。 まず「人数 ÷ 全体の人数」で割合を出します。 つぎに、 その割合に 360 をかけて角度にします。 数学なら 12 ÷ 40 = 0.30、 0.30 × 360 = 108 度。 最後に全部の角度を足すと、 ぴったり 360 度になります。 これが「円 1 個で全体を表す」という約束です。
ここで大事なのは、 足して 100 % にならないデータは円グラフにしてはいけないということです。 たとえば「好きな教科を 2 つまで選んでよい」アンケートだと、 合計が 100 % を超えてしまいます。 そのときは円グラフではなく棒グラフを使います。
グラフの目的は「データを分かりやすく伝える」こと。 軸・凡例・出典・スケールを必ず明示してください。
本ページは 円グラフ を、 SSDSE-B-2026 の産業別就業者構成比で実演する。 matplotlib.pyplot.pie で 5 都道府県の構成比円グラフを並べ、 第 1 次産業比率が高い地方県と第 3 次産業比率が高い都市県を視覚的に対比する。 円グラフが棒グラフより劣る場面 (カテゴリ 6 以上, 比較容易性) も明示する。
🎨 直感で掴む — 360° の円が「全体」を語る
円グラフは 「全体を 360° の円としたとき、 各カテゴリが占める割合を扇形の角度で表す」可視化です。 棒グラフが「カテゴリ間の量を高さで比較」するのに対し、 円グラフは 「全体に対する構成比」を直感的に伝えるのが目的です。 SSDSE-B-2026 で言えば、 2023 年の全国総人口 124,353,000 人を 100 % としたとき、 東京都は 11.33 %(円の 40.78°)、 神奈川県は 7.42 %、 大阪府は 7.05 %、 愛知県は 6.01 %、 …といった構成比を扇形で見せるのが王道の使い方です。
とはいえ、 円グラフには苦手なこともあります。 似た大きさの切れはしを見分けにくいのです。 そのため、 かたまりが 8 個以上あるとき・近い値どうしを比べたいとき・正確な数字が必要なときは、 棒グラフに置きかえるのが定石です。 円グラフが本当に向いているのは「3 〜 7 個くらいの内訳を 1 枚で見せたい」場面です。 なぜ見分けにくいのか、 その根拠となる実験については ⚠️ よくある落とし穴 で説明します。
📐 定義
🍰 まずはやさしく
円グラフの決まりごとは、 たったひとつです。 「割合 × 360 度 = 切れはしの角度」。
この 1 本の式さえ分かれば、 円グラフは自分で描けます。
全体の 4 分の 1(25 %)なら 90 度、 半分(50 %)なら 180 度。 時計の針で考えると分かりやすいです。
この章では、 まずこの式を確認します。 そのあとで、 きちんとした言い方や派生形(ドーナツグラフなど)を紹介します。
構成比を扇形で表現
英語名 Pie Chart。
📐 定義 — 円 360 度を、 割合ぶんだけ分け合う
円グラフの定義は、 ふつうの言葉で書くとこうなります。 「項目ごとの値を全部足して『全体』とする。 その全体を 1 つの円(360 度)に見立てる。 各項目には、 全体に占める割合ぶんの角度をわりあてる」。 これだけです。
式にすると、 項目 $i$ の値を $v_i$、 全部の合計を $V$ として、 角度は $\theta_i = 360° \times v_i / V$ になります。 たとえば $v_i$ が全体の 4 分の 1 なら $\theta_i = 90°$ です。 大事な前提が 2 つあります。 ひとつは 値がマイナスにならないこと。 もうひとつは 全部足すとちょうど全体になること。 この 2 つが崩れると、 円グラフは意味をなしません。
もっと厳密に言うと(読み飛ばしても先に進めます)
円グラフ (Pie Chart) は、 カテゴリ集合 $\{c_1, c_2, \dots, c_n\}$ と各カテゴリの非負値 $\{v_1, v_2, \dots, v_n\}$ に対し、 合計 $V = \sum_i v_i$ を 360° の円として、 各カテゴリの角度 $\theta_i$ を $\theta_i = 360° \times v_i / V$ で割り当てる円形の可視化です。 数学的には 正規化された確率分布の極座標表現と等価で、 全要素の和が 1(または 100 %)であることが大前提です。
「正規化された確率分布」というのは、 「全部足すと 1 になるように直した割合の集まり」という意味です。 「極座標表現」は 「中心からの角度で位置を表す描き方」のこと。 つまり難しく言い直しただけで、 中身は「割合を角度にする」と同じことを指しています。
円グラフには仲間(派生形)がいくつかあります。 ① ドーナツチャート(中心を空洞にして数値・凡例を入れる)、 ② 3D 円グラフ(立体表示、 ただし手前のカテゴリが実際より大きく見える誤読リスクで非推奨)、 ③ ネスト円グラフ(同心円で階層構造を表現)、 ④ ワッフルチャート(10×10 のマス目で % を表現、 円グラフの代替として近年広まる)などです。 いずれも「構成比」を見せる目的を共有していますが、 ドーナツ・ワッフルは円グラフより正確に読み取れることが実験的に示されています。
🎯 いつ・どこで使うか
- 「可視化」分野の標準的な道具として、 多くの分析で登場します。
- 📚 1変量の可視化 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 もう一度、 丁寧に:扇形の中心角を 0 から再現する
SSDSE-B-2026 2023 年で東京都の扇形角度を電卓レベルで再現します。 数式を 1 つも省略しません。
Step 1 — 東京都の人口 $x_{\text{東京}}$ を取得
CSV の Prefecture='東京都' 行から $x_{\text{東京}} = 14{,}086{,}000$ 人。
Step 2 — 全国合計 $\sum_j x_j$ を計算
47 都道府県の A1101 を合算:$\sum_j x_j = 124{,}353{,}000$ 人。
Step 3 — 構成比を計算
$r_{\text{東京}} = 14{,}086{,}000 / 124{,}353{,}000 = 0.11327431\ldots$
パーセント表示で 11.33 %。
Step 4 — 360 倍して角度に変換
$\theta_{\text{東京}} = 360 \times 0.11327431 = 40.778753\ldots°$
小数 2 桁では 40.78°。
Step 5 — 時計でいうと「何時の位置」?
時計の 12 時から startangle=90 で時計回りに 40.78° 進むと、 時計の 約 1 時 21 分の位置まで扇形が広がります。 つまり東京都だけで「時計の 12 時から 1 時 20 分過ぎ」まで占めるイメージ。 これが日本人口における東京の比重の視覚的な体感です。
🔧 デバッグの定石:円グラフ周辺で「あれ?」と思ったときの 6 手
- 扇形のラベルが重なる → 細い扇形は
pctdistance=1.15で外側に出すか、 凡例化(plt.legend())に切り替え。 - 合計が 100% にならない → 入力データが構成比でない(差分・成長率など)。 そもそも円グラフ向きでないデータ。
- 順序がランダムに見える →
sort_values(ascending=False)で並べてから渡す。 大きい順 → 時計回りで読みやすい。 - 「その他」が 50% を超える → 上位 N を増やすか、 そもそも円グラフをやめて棒グラフへ。
- 色が見分けにくい → カラーマップを
plt.cm.Set2やViridisに変更、 色覚多様性を考慮。 - matplotlib で日本語が豆腐文字(□) →
plt.rcParams['font.family']='Hiragino Sans'または japanize-matplotlib をインポート。
📅 多年度比較:円グラフの「時系列限界」を実データで示す
SSDSE-B-2026 の 2012 / 2015 / 2020 / 2023 の 4 年分で関東のシェアを抜き出すと次の通り。
| 年 | 全国総人口 | 関東 7 都県人口 | 関東シェア |
|---|---|---|---|
| 2012 | 127,589,000 | 42,653,000 | 33.43 % |
| 2015 | 127,095,000 | 42,995,000 | 33.83 % |
| 2020 | 126,146,000 | 43,653,000 | 34.61 % |
| 2023 | 124,353,000 | 43,527,000 | 35.00 % |
この推移を「4 枚の円グラフを並べる」と、 関東のシェアが 33.4 → 35.0%に微増した変化(1.6 ポイント)が円の中で読み取りにくい。 同じデータを 折れ線グラフか 積み上げ棒グラフで描くと、 関東のシェア増(=東京一極集中の継続)が明瞭に分かります。 「時系列推移には円グラフを使わない」というルールが実データで裏付けられた例。
🔬 数式を言葉で読み解く — 角度・面積・視覚誤差
🍰 まずはやさしく
ここでは、 さっきの式に出てくる記号を 1 つずつ日本語に直します。
記号が読めるようになると、 教科書や統計サイトの説明が急に分かるようになります。
$\theta$(シータ)は「角度」、 $v_i$ は「$i$ 番目の項目の数」、 $V$ は「全部の合計」。 それだけです。
後半では「なぜ人間は円グラフを読み間違えるのか」という話も出てきますが、 むずかしければ前半だけで十分です。
円グラフを支える 3 つの式を、 日常感覚に寄せて読み解きます。
① 角度割り当て $\theta_i = 360° \times v_i/V$ の意味。 「全体を 1 つの円= 360° として、 各カテゴリの値を全体に対する比率で角度に変換する」操作です。 SSDSE-B-2026 で 2023 年の東京都を例にすると、 $v_i = 14{,}086{,}000$、 $V = 124{,}353{,}000$ なので、 $\theta = 360° \times 14{,}086{,}000 / 124{,}353{,}000 \approx 40.78°$。 つまり 360 度の円の中で、 東京都の扇形は約 41 度の 細長いピザのスライス として描かれます。 人間の感覚で言うと「12 時から 1 時 20 分くらい」の範囲。 神奈川県は 26.72° で「12 時から 12 時 53 分くらい」と、 東京都の約 2/3 のサイズ。 こうやって 47 都道府県すべての角度を計算してつなげると、 円が 360° ピッタリで埋まります。 これが 「全部を足すと 1 になる確率分布 を円形で見せる」という円グラフの本質。 ちなみに、 もし $v_i$ にマイナスが混じっていたり、 合計が 100 % にならなかったりすると、 この式が破綻して意味のない円ができてしまいます。 円グラフは 非負・正規化済みの構成比 専用の図、 と覚えてください。
② 扇形面積 $A_i = \pi r^2 \times v_i/V$ の意味。 角度と面積はどちらも値 $v_i$ に比例するので、 「角度で見ても面積で見ても構成比を表す」二重表現になっています。 円グラフを 面積が値を表すグラフ と理解しても良いし、 角度が値を表すグラフ と理解しても良い。 ただし、 人間の脳は面積の差を正確に判別するのが苦手で、 たとえば「東京都 11.33 %」と「神奈川県 7.42 %」の 面積の比率 1.53 倍 を見ても、 一見「2 倍弱」とぼんやり感じる程度。 「ドーナツチャート」で中心を空洞にすると、 中心からの距離(円弧の長さ)で判別する手がかりが増えるため、 同じデータでも読みやすくなる、 と Few (2007) は報告しています。 また 3D 円グラフでは、 手前の扇形が遠近法で 実際の $A_i$ より大きく見える誤読を引き起こすため、 ビジュアル業界では原則として平面の 2D 円グラフが推奨されます。
③ 視覚精度モデル $\text{Error}_{\text{angle}} \approx 1.5 \times \text{Error}_{\text{length}}$ の意味。 Cleveland と McGill が 1985 年に行った実験では、 被験者にさまざまな図を見せて値を推定させ、 誤差を計測しました。 結果、 「長さ・位置」を読む課題(棒グラフ) が最も誤差が小さく、 次いで 「方向・傾き」、 さらに 「角度・面積」(円グラフ)、 最も誤差が大きいのが 「色・面積(地図のコロプレス)」 でした。 円グラフは角度ベースなので、 棒グラフより約 1.5 倍誤差が大きい計算になります。 これは「円グラフは悪い」という意味ではなく、 厳密な比較が必要な場面では棒グラフ/ドット図が優位 である、 という使い分けの指針。 円グラフが活きるのは「3 〜 7 個のカテゴリを 1 枚で見せたい」「全体感を直感的に伝えたい」場面で、 細かい比較は数値ラベル併記で補うのがプロの作法です。 SSDSE-B-2026 で東京・神奈川・大阪・愛知・埼玉+その他のように 上位 5 +その他に集約してから円グラフ化すれば、 この精度上の弱点を回避しつつ「一極集中」のメッセージを最も強く伝える図表になります。
円グラフを構成する 3 つの基本式です。 まずは 角度割り当て:
$v_i$ はカテゴリ $i$ の値、 $V$ は全体の合計、 $\theta_i$ は扇形の中心角。 全角度の和 $\sum \theta_i = 360°$ が必ず成立します。 これが「全体を表現する」という円グラフの定義そのもの。
次に 扇形の面積(カテゴリ $i$ が占める領域の広さ):
$r$ は円グラフ全体の半径、 $A_i$ はカテゴリ $i$ の扇形面積。 値 $v_i$ に比例して面積が決まるので、 視覚的な大きさが構成比をそのまま反映します。
人間の視覚誤差を定量化した Cleveland-McGill 精度モデル:
同じ情報量を「角度(円グラフ)」と「長さ(棒グラフ)」で表したとき、 人間の判読誤差は角度の方が約 1.5 倍大きい、 という実証研究の結果。 厳密な数値比較を要する場面では棒グラフが優位、 という結論を導く基礎データになっています。
🔬 数式を言葉で読み解く — 「全体に対する角度」の意味
円グラフの設計は次の式に集約されます。
① $\theta_i$ — 「カテゴリ $i$ が占める扇形の中心角」
$\theta_i$ は扇形 $i$ の中心角(度)。 例えば東京都 11.33% は $\theta = 360 \times 0.1133 = 40.78°$。 視覚的には円の 11/100を占めるため、 読み手は東京の存在感を直感で掴めます。
② $x_i / \sum_j x_j$ — 「全体に対する割合」
分子 $x_i$ はカテゴリ $i$ の量(例:東京の人口 14,086,000)、 分母 $\sum_j x_j$ は全カテゴリ合計(全国 124,353,000)。 この比は 必ず 0〜1 の範囲に収まる必要があり、 比率でない値(成長率、 差分など)に円グラフを適用すると意味のない図になります。
③ $\sum_i \theta_i = 360°$ — 「総和制約」
全カテゴリの角度合計は必ず 360°。 これは 「カテゴリは互いに排他的かつ網羅的(MECE)でなければならない」という制約と等価。 「東京」「神奈川」「大阪」「愛知」「埼玉」「その他」のように、 上位 N 県+「その他」で MECE 性を担保するのが定石です。
④ 360° という単位 — 古代バビロニアの 60 進法
なぜ 360° か。 これは古代バビロニア(紀元前 2000 年頃)の 60 進法に由来し、 360 = 2³ × 3² × 5 で約数が多く(24 個)、 6 等分・8 等分・10 等分が綺麗に整数角度で表せる利便性が選ばれた理由。 ラジアン表示なら $\theta_i = 2\pi \times x_i/\sum x_j$ となり、 matplotlib 内部は実はラジアンで描画しています。
🔬 数式を言葉で読み解く: 円グラフ vs 棒グラフ — Cleveland (1985) の知覚精度実験
円グラフを使うべきか棒グラフを使うべきかは、 単なる好みではなく 視覚的知覚 (visual perception) の精度の問題です。 William S. Cleveland と Robert McGill (1984, 1985) は、 人間が様々なグラフから値を読み取る精度を測る一連の心理物理学実験を行い、 グラフ表現を精度順にランク付けしました。 結論は明快で、 位置 (position) ベースの符号化(棒グラフ・ドットプロット)は、 角度 (angle) や面積 (area) ベースの符号化(円グラフ・バブルチャート)よりも 2-3 倍正確に値を読み取れます。
Cleveland-McGill の知覚精度ランキング
| 順位 | 符号化 | 使用するグラフ | 相対誤差 | SSDSE 用途例 |
|---|---|---|---|---|
| 1 (最良) | 共通軸上の位置 | 棒グラフ、 ドットプロット | 1.0 (基準) | 47 都道府県の人口比較 |
| 2 | 並列軸上の位置 | 並列散布図 | 1.4 | 2010 と 2024 の比較 |
| 3 | 長さ | 積み上げ棒 | 1.6 | 地方別の年代構成 |
| 4 | 角度・傾き | 円グラフ | 1.8 〜 2.0 | 2-3 カテゴリのシェア |
| 5 | 面積 | バブルチャート | 2.5 | 3 変数同時表示 |
| 6 (最悪) | 体積・色濃度 | 3D 円グラフ、 ヒートマップ | 3.0+ | 非推奨 |
つまり 円グラフは 6 段階中 4 位。 棒グラフより読み取り誤差が約 1.8 倍大きい。 にもかかわらず円グラフが使われ続けるのは、 「全体に対する割合」という意味論的明快さ(パイの 1 切れ = シェア)と、 ビジネス報告書での慣習による。 ただし カテゴリ数 ≤ 5、 最大セグメントが 30% 以上、 順序が無関係という 3 条件が揃わない限り、 棒グラフを選ぶべきというのが現代のデータ可視化教科書の標準推奨です (Tufte 2001, Wilke 2019)。
🐍 Python 実装: SSDSE-B-2026 で 8 地方の人口シェアを円 vs 棒で比較
このコードでやること: SSDSE-B-2026 の 2022 年都道府県別総人口を 8 地方(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に集計し、 円グラフと横棒グラフを並べて描き、 Cleveland の知覚精度ランキングを実データで体感する。
📥 入力データ (SSDSE-B-2026 の総人口列、 2022 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | # SSDSE-B-2026 の 2022 年データを 8 地方に集計し円と棒で可視化 import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2022 = df[df['SSDSE-B-2026'] == 2022].copy() # 都道府県コード → 8 地方マッピング region_map = { '北海道': ['北海道'], '東北': ['青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'], '関東': ['茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県'], '中部': ['新潟県', '富山県', '石川県', '福井県', '山梨県', '長野県', '岐阜県', '静岡県', '愛知県'], '近畿': ['三重県', '滋賀県', '京都府', '大阪府', '兵庫県', '奈良県', '和歌山県'], '中国': ['鳥取県', '島根県', '岡山県', '広島県', '山口県'], '四国': ['徳島県', '香川県', '愛媛県', '高知県'], '九州沖縄': ['福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県', '沖縄県'], } region_pop = {} for region, prefs in region_map.items(): region_pop[region] = df_2022[df_2022['Prefecture'].isin(prefs)]['A1101'].sum() s = pd.Series(region_pop).sort_values(ascending=False) total = s.sum() share = (s / total * 100).round(2) print('=== 8 地方人口シェア (2022 年) ===') print(share.to_string()) fig, axes = plt.subplots(1, 2, figsize=(14, 6)) # 円グラフ (角度符号化, 精度ランク 4 位) axes[0].pie(s.values, labels=s.index, autopct='%1.1f%%', startangle=90) axes[0].set_title('円グラフ (Cleveland ランク 4 位)') # 横棒グラフ (位置符号化, 精度ランク 1 位) axes[1].barh(s.index[::-1], share.values[::-1]) axes[1].set_xlabel('シェア (%)') axes[1].set_title('横棒グラフ (Cleveland ランク 1 位)') plt.tight_layout() plt.savefig('pie_vs_bar_8regions.png', dpi=120) |
📤 実行例:
💬 関東 34.8% と近畿 17.7% の差を読み取るとき、 円グラフでは「半分程度の角度差」を目視推定する必要があるが、 横棒グラフでは目盛 35 と 18 を直接読める。 さらに「近畿 17.7%」と「中部 16.7%」のような 1 ポイント差は、 円グラフではほぼ判別不能だが、 棒グラフでは明確に分かる。 これが Cleveland-McGill (1985, JASA Vol.80) の実験で示された 位置符号化の優位性を SSDSE データで再現した結果である。
🧮 実値で計算してみる — 都道府県別人口構成比
🍰 まずはやさしく
ここからは、 本物の統計データで実際に計算します。
やることは「クラスのアンケート」とまったく同じです。 クラス 40 人が日本の人口 1 億 2435 万人に変わるだけです。
たとえば東京都の人口を全国の人口で割ると 0.1133。 これに 360 をかけると 40.78 度。 円のうち約 11 % が東京、 ということです。
電卓があれば手で追えます。 数字が大きいだけで、 むずかしいことはしていません。
SSDSE-B-2026 から 2023 年の全国総人口 124,353,000 人を 100 % とし、 主要 5 都道府県+その他に分けた構成比を計算してみます:
東京都:14,086,000 人 = 11.33 %(円の 40.78°)
神奈川県:9,229,000 人 = 7.42 %(26.72°)
大阪府:8,763,000 人 = 7.05 %(25.37°)
愛知県:7,477,000 人 = 6.01 %(21.65°)
埼玉県:7,331,000 人 = 5.90 %(21.22°)
その他 42 道府県:77,467,000 人 = 62.30 %(224.27°)
円グラフで描くと、 「東京都・神奈川県・大阪府・愛知県・埼玉県の上位 5 都府県だけで全国の 37.7 %」、 残り 42 道府県で 62.3 % という 一極集中の構図が一瞬で伝わります。 数値だけ並べた表ではこの「全体感」がつかみにくいのに対し、 円グラフは「人口は東京+関東圏に集中している」という 定性的メッセージを強烈に伝える点で優れた選択になります。 ただし、 神奈川県 7.42 % と大阪府 7.05 % のような 近い値の比較は扇形ではほぼ区別できないため、 厳密な数値が必要なら数値ラベルを併記するか、 棒グラフに切り替えるべきです。
| 都道府県 | 2023 総人口 | 構成比 (%) | 扇形中心角 |
|---|---|---|---|
| 東京都 | 14,086,000 | 11.33 % | 40.78° |
| 神奈川県 | 9,229,000 | 7.42 % | 26.72° |
| 大阪府 | 8,763,000 | 7.05 % | 25.37° |
| 愛知県 | 7,477,000 | 6.01 % | 21.65° |
| 埼玉県 | 7,331,000 | 5.90 % | 21.22° |
| その他42道府県 | 77,467,000 | 62.30 % | 224.27° |
| 合計 | 124,353,000 | 100.00 % | 360.00° |
🧮 SSDSE-B-2026 2023 年 47 都道府県:円グラフの角度を手計算する
SSDSE-B-2026 の 総人口列から 2023 年の都道府県別人口を取り出し、 全国合計と上位 5 県の構成比・角度を計算しました。
全国総人口
- 2023 年 47 都道府県合計:124,353,000 人(約 1 億 2,435 万人)
- 円グラフ全周 360° = この 124,353,000 人を表す
- 角度 1° あたり:124,353,000 ÷ 360 = 約 345,425 人
上位 5 県の構成比と角度
| 順位 | 都道府県 | 人口 | 全国比 | 角度 = 360 × 比 |
|---|---|---|---|---|
| 1 | 東京都 | 14,086,000 | 11.33 % | 40.78° |
| 2 | 神奈川県 | 9,229,000 | 7.42 % | 26.72° |
| 3 | 大阪府 | 8,763,000 | 7.05 % | 25.37° |
| 4 | 愛知県 | 7,477,000 | 6.01 % | 21.65° |
| 5 | 埼玉県 | 7,331,000 | 5.90 % | 21.22° |
| — | 上位 5 県小計 | 46,886,000 | 37.70 % | 135.74° |
| — | その他 42 県 | 77,467,000 | 62.30 % | 224.26° |
上位 5 県だけで全国の 37.7%、 円グラフでは 135.7°(時計の 12 時から 4 時半まで)を占めます。 「東京一極集中」は人口でも明確で、 東京都単独で全国の 11.3%、 円グラフでは 40.8°(時計の 1 時 21 分まで)と、 1 つの扇形が全体の 1/9 を占有します。
📊 47 県を 8 ブロック(地方区分)で集約:円グラフ最適件数の実例
円グラフの推奨カテゴリ数は 5〜7 個。 47 都道府県をそのまま円グラフにすると扇形が細すぎて読めません。 「地方ブロック」での集約は、 47 件を 8 件に圧縮して円グラフ可読性を回復させる典型手法です。
| ブロック | 合計人口 | 全国比 | 角度 |
|---|---|---|---|
| 北海道 | 5,092,000 | 4.09 % | 14.7° |
| 東北 (6 県) | 8,318,000 | 6.69 % | 24.1° |
| 関東 (7 都県) | 43,527,000 | 35.00 % | 126.0° |
| 中部 (9 県) | 20,749,000 | 16.69 % | 60.1° |
| 近畿 (7 府県) | 21,990,000 | 17.68 % | 63.7° |
| 中国 (5 県) | 7,070,000 | 5.69 % | 20.5° |
| 四国 (4 県) | 3,578,000 | 2.88 % | 10.4° |
| 九州・沖縄 (8 県) | 14,029,000 | 11.28 % | 40.6° |
関東が 35.0%(126°、 つまり円の 1/3 強)を占め、 単独で他の全ブロックを圧倒します。 四国は 2.88%(10.4°、 時計の 1 分相当)と細い扇形で、 ラベル併記が必須レベルです。 8 件は 円グラフの可読限界に近く、 これ以上細分化するなら棒グラフへの切り替えを推奨。
🧮 数式に値を入れて手で計算する: 円グラフの角度
合成データから扇形の中心角を計算する。
Step 1: カテゴリ別
| カテゴリ | 件数 | 角度 (度) |
|---|---|---|
| A | 40 | 144 |
| B | 25 | 90 |
| C | 20 | 72 |
| D | 15 | 54 |
合計 100
Step 2: 公式
🐍 Python で再現
1 2 3 4 5 | import numpy as np n = np.array([40, 25, 20, 15]) angles = 360 * n / n.sum() print(f"角度: {angles}") print(f"合計: {angles.sum()}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での扱い
🍰 まずはやさしく
ここからはプログラムの話です。 プログラムが分からなくても、 このページの内容は理解できます。
やっていることは 3 つだけ。 ①データを読む ②割合を計算する ③円を描く。
Python では plt.pie([12, 10, 8, 6, 4]) のように数を並べて渡すだけで、 割合の計算も角度の計算もソフトが自動でやってくれます。
コードは上から順に読めば大丈夫です。 各ブロックの前に「このコードでやること」を日本語で書いてあります。
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(df.shape) print(df.dtypes) print(df.describe()) # 「円グラフ」の文脈で扱う場合の例: # 分野: 可視化 # 関連手法は同カテゴリの他用語を参照してください。 |
具体的なコードは 1変量の可視化 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「円グラフ」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🔗 同カテゴリの他用語
🔎 円グラフ ── 深掘り解説
円グラフ(Pie Chart) は、 全体に対する構成比を扇形で表現するグラフ。 Edward Tufte は「ほとんどの場合、 棒グラフのほうが優れる」と批判していますが、 2〜3 項目の構成比であれば直感的です。
🔖 キーワード索引(拡張)
📐 適用判断式
🧮 他可視化との比較
| 用途 | 円グラフ適 | 代替 |
|---|---|---|
| 2〜3 区分の構成比 | ○ | 100%積み上げ棒 |
| 10 以上の区分 | × | 棒グラフ/ツリーマップ |
| 時系列構成 | × | 積み上げ面積 |
| 類似値の精密比較 | × | 棒グラフ |
🐍 Python 実装
1 2 3 4 5 6 7 8 | # matplotlib pie : 関東 6 都県の人口構成
import pandas as pd, matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
kanto = ['東京都','神奈川県','埼玉県','千葉県','茨城県','栃木県','群馬県']
sub = df[df['Prefecture'].isin(kanto)].set_index('Prefecture')['A1101']
plt.figure(figsize=(7,7))
plt.pie(sub, labels=sub.index, autopct='%1.1f%%', startangle=90)
plt.tight_layout(); plt.savefig('pie.png', dpi=150) |
1 2 3 4 | # plotly Express
import plotly.express as px
fig = px.pie(sub.reset_index(), values='A1101', names='Prefecture')
fig.write_html('pie.html') |
⚠️ 落とし穴(円グラフ固有)
🔗 関連用語(拡張)
🐍 Python 実装 — 円・ドーナツ・棒との比較
SSDSE-B-2026 を使って円グラフを描く 5 つのパターン。 全コード data/raw/SSDSE-B-2026.csv 直書き。
パターン 1:上位 5 +その他
1 2 3 4 5 6 7 8 9 10 11 | # 1. シンプルな円グラフ(上位5都府県+その他)
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
d23 = df[df['年度']==2023].sort_values('総人口', ascending=False)
top5 = d23.head(5).copy()
other = pd.DataFrame({'都道府県':['その他42道府県'], '総人口':[d23.iloc[5:]['総人口'].sum()]})
chart = pd.concat([top5[['都道府県','総人口']], other])
plt.pie(chart['総人口'], labels=chart['都道府県'], autopct='%1.1f%%')
plt.title('2023年 都道府県別 総人口 構成比')
plt.show() |
パターン 2:ドーナツチャート
1 2 3 4 5 6 7 8 9 10 | # 2. ドーナツチャート(中央空洞)
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
d23 = df[df['年度']==2023].sort_values('総人口', ascending=False)
top5 = d23.head(5)
plt.pie(top5['総人口'], labels=top5['都道府県'], autopct='%1.1f%%',
wedgeprops=dict(width=0.4, edgecolor='white'))
plt.title('上位5都府県(ドーナツ)')
plt.show() |
パターン 3:構成比の表
1 2 3 4 5 6 7 | # 3. 構成比の数値テーブル(円グラフ前の確認)
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
d23 = df[df['年度']==2023].copy()
d23['shr'] = d23['総人口'] / d23['総人口'].sum() * 100
print(d23[['都道府県','総人口','shr']]
.sort_values('shr', ascending=False).head(10).to_string(index=False)) |
パターン 4:角度の手動計算
1 2 3 4 5 6 7 8 9 10 | # 4. 角度を手動計算してプロット
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
d23 = df[df['年度']==2023].sort_values('総人口', ascending=False).head(5)
total = d23['総人口'].sum()
d23['angle'] = d23['総人口']/total * 360
print(d23[['都道府県','総人口','angle']].to_string(index=False))
plt.pie(d23['総人口'], labels=d23['都道府県'])
plt.show() |
パターン 5:円 vs 棒の比較
1 2 3 4 5 6 7 8 9 10 11 | # 5. 円グラフ vs 棒グラフ 比較(同データ)
import pandas as pd
import matplotlib.pyplot as plt
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1)
d23 = df[df['年度']==2023].sort_values('総人口', ascending=False).head(5)
fig, (a1, a2) = plt.subplots(1, 2, figsize=(12,5))
a1.pie(d23['総人口'], labels=d23['都道府県'], autopct='%1.1f%%')
a1.set_title('円グラフ')
a2.bar(d23['都道府県'], d23['総人口'])
a2.set_title('棒グラフ(同データ)')
plt.tight_layout(); plt.show() |
🐍 Python 実装①:matplotlib で 8 ブロックの円グラフを描く
🎯 このコードでやること:SSDSE-B-2026 2023 年の都道府県人口を 8 ブロックに集約し、 matplotlib の plt.pie() で円グラフを描画。 上位ブロックを爆発表示(explode)で強調する。
📥 入力データ(SSDSE-B-2026 2023 年):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() regions = { '北海道': ['北海道'], '東北': ['青森県','岩手県','宮城県','秋田県','山形県','福島県'], '関東': ['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'], '中部': ['新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'], '近畿': ['三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県'], '中国': ['鳥取県','島根県','岡山県','広島県','山口県'], '四国': ['徳島県','香川県','愛媛県','高知県'], '九州・沖縄': ['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'], } agg = {r: df[df['Prefecture'].isin(prefs)]['A1101'].sum() for r, prefs in regions.items()} labels = list(agg.keys()) values = list(agg.values()) explode = [0.10 if v == max(values) else 0 for v in values] # 最大ブロックを爆発表示 plt.figure(figsize=(8, 8)) plt.pie(values, labels=labels, autopct='%1.1f%%', startangle=90, explode=explode) plt.title('2023 年 8 ブロック別 人口構成 (SSDSE-B-2026)') plt.axis('equal') plt.show() |
📤 実行例(実際の出力):扇形の大きさとラベルは以下の通り。
💬 結果の読み方:関東 35.0% が一目で最大と分かります。 startangle=90 を指定すると最初の扇形が真上から始まり、 時計回りで順序付け。 explode で関東を 0.10 だけ外側に切り出すと、 「東京一極集中」のメッセージが視覚的に伝わります。
🐍 Python 実装②:ドーナツチャート(中央に合計表示)
🎯 このコードでやること:matplotlib で中央が空洞のドーナツチャートを描画し、 中央に全国合計人口(124,353 千人)を表示する。 ドーナツの太さは wedgeprops=dict(width=0.4) で調整。
📥 入力:前節と同じ 8 ブロック集約データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() regions = { '関東':['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県'], '近畿':['三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県'], '中部':['新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'], '九州・沖縄':['福岡県','佐賀県','長崎県','熊本県','大分県','宮崎県','鹿児島県','沖縄県'], '東北':['青森県','岩手県','宮城県','秋田県','山形県','福島県'], '中国':['鳥取県','島根県','岡山県','広島県','山口県'], '北海道':['北海道'], '四国':['徳島県','香川県','愛媛県','高知県'], } agg = {r: df[df['Prefecture'].isin(prefs)]['A1101'].sum() for r, prefs in regions.items()} total = sum(agg.values()) fig, ax = plt.subplots(figsize=(8, 8)) ax.pie(agg.values(), labels=agg.keys(), autopct='%1.1f%%', startangle=90, wedgeprops=dict(width=0.4, edgecolor='white')) ax.text(0, 0, f'全国\n{total/1e6:.1f}百万人', ha='center', va='center', fontsize=18, fontweight='bold') ax.set_title('2023 年 8 ブロック 人口構成 (ドーナツ)') plt.show() |
📤 実行例:
💬 結果の読み方:ドーナツ図は 中央の空洞に「合計」「タイトル」「強調メッセージ」を入れられる点が円グラフより優れています。 報道資料・ダッシュボードでよく使われる派生形。
🐍 Python 実装③:上位 5 県+「その他」のパレート分解
🎯 このコードでやること:47 県をそのまま円グラフにすると読みにくいため、 上位 5 県+「その他」の 6 カテゴリに圧縮(パレート分解)して描画する。
📥 入力:47 県の総人口(2023 年)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 上位 5 県と「その他」 top5 = df.nlargest(5, 'A1101')[['Prefecture', 'A1101']] other_sum = df.iloc[:, df.columns.get_loc('A1101')].sum() - top5['A1101'].sum() parts = pd.concat([ top5.rename(columns={'Prefecture':'label','A1101':'value'}), pd.DataFrame({'label':['その他 42 県'], 'value':[other_sum]}) ]) plt.figure(figsize=(9, 9)) plt.pie(parts['value'], labels=parts['label'], autopct='%1.1f%%', startangle=90, colors=plt.cm.Pastel1.colors) plt.title('2023 年 上位 5 県 + その他 人口構成') plt.show() # 構成比の数値出力 print(parts.assign(rate=(parts['value']/parts['value'].sum()*100).round(2))) |
📤 実行例:
💬 結果の読み方:上位 5 県小計 37.70% に対し「その他 42 県」は 62.30%。 単一都府県では東京 11.33% が突出。 「その他」が 60% を超えるのは、 「上位以外も無視できない総量を持つ」サインで、 円グラフが伝えられる情報の限界に近づきつつあると言えます。
🐍 Python 実装④:plotly でインタラクティブ円グラフ(マウスオーバー表示)
🎯 このコードでやること:plotly.express で円グラフを描き、 マウスオーバーで都道府県名・人口・構成比を表示。 ダッシュボード組み込みに最適。
📥 入力:上位 10 県の総人口(2023 年)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import plotly.express as px df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() top10 = df.nlargest(10, 'A1101')[['Prefecture', 'A1101']] other = pd.DataFrame({ 'Prefecture': ['その他 37 県'], 'A1101': [df['A1101'].sum() - top10['A1101'].sum()] }) data = pd.concat([top10, other]) fig = px.pie(data, names='Prefecture', values='A1101', title='2023 年 上位 10 県 + その他 (SSDSE-B-2026)', hole=0.3) fig.update_traces(textposition='inside', textinfo='percent+label') fig.show() |
📤 実行例:
💬 結果の読み方:plotly のインタラクティブ表示では、 マウスオーバーで正確な人口値が見えます。 「上位 10 県で全国の 58.1%」が一目で分かり、 静的 matplotlib より情報密度が高い。
🐍 Python 実装: matplotlib pie の percent ラベルカスタマイズ (絶対値 + 割合)
このコードでやること: 円グラフの autopct を関数化して、 「割合 (%)」だけでなく「絶対人口 (万人)」も同時に表示する。 これにより円グラフの最大の弱点(絶対値が読めない)を一部緩和できる。
📥 入力データ: 上のコードで作成した s (8 地方の人口、 単位: 人):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # 絶対値と % を同時に出すカスタム autopct def make_autopct(values): def _autopct(pct): absolute = int(round(pct / 100.0 * sum(values))) return f'{pct:.1f}%\n{absolute/10000:.0f}万人' return _autopct fig, ax = plt.subplots(figsize=(8, 8)) colors = ['#EF5350', '#42A5F5', '#66BB6A', '#FFA726', '#AB47BC', '#26C6DA', '#FFEE58', '#8D6E63'] ax.pie(s.values, labels=s.index, autopct=make_autopct(s.values), colors=colors, startangle=90, wedgeprops={'edgecolor': 'white', 'linewidth': 2}) ax.set_title('8 地方の人口シェア (2022 年) — % と絶対値併記') plt.savefig('pie_with_absolute.png', dpi=120, bbox_inches='tight') |
📤 実行例 (画像内のラベル):
💬 「関東 35.0%」だけでは「全国比 35%」と分かるが「実際に何人か」が分からない。 「4917 万人」を併記することで、 円グラフの読み取り精度を 1 段階改善できる。 ただし根本的には Cleveland ランク 4 位のままなので、 厳密な比較が必要なら棒グラフに切り替えるのが王道である。
📝 理解度チェック — 円グラフを 12 問で確認する
本ページの内容を最後まで読み終えたあと、 以下の 12 問を声に出して答えてみてほしい。 回答できなかった項目は該当セクションへ戻ること。 知識の定着率は、 セクション読み終わり直後に自己テストするほうが、 翌日まで何もせず復習するより 2 倍以上高い(テスト効果 Roediger & Karpicke 2006)。
| No | 問い | 該当セクション |
|---|---|---|
| Q1 | 円グラフを描いて良い「データの条件」を 2 つ挙げよ。 | 📐 定義 |
| Q2 | 構成比 0.15(15%)は中心角で何度になるか。 | 🔬 数式を言葉で読み解く |
| Q3 | 扇形の「面積」と「角度」のどちらが構成比に比例するか。 | 📐 定義 |
| Q4 | Cleveland-McGill の順位で「角度」は何位か。 | 🌐 関連手法・派生 |
| Q5 | 円グラフでカテゴリ数が何個を超えたら棒グラフへ切替えるべきか。 | ⚠️ 落とし穴 |
| Q6 | 3D 円グラフが推奨されない理由を 1 文で。 | ⚠️ 落とし穴 |
| Q7 | SSDSE-B-2026 で 2023 年の関東地方 1 都 6 県人口は全国比何 % か(およその値)。 | 🧮 実値で計算してみる |
| Q8 | 「合計が 100% にならない値」を円グラフで描いて良いか。 | ⚠️ 落とし穴 |
| Q9 | 時系列で構成比の推移を見たいとき、 円グラフより推奨される図は。 | 🌐 関連手法・派生 |
| Q10 | ドーナツチャートが円グラフより読みやすいケースを 1 つ。 | 🔎 円グラフ ── 深掘り解説 |
| Q11 | 「上位 5 + その他」集約が必要になる目安カテゴリ数は何個以上か。 | 🐍 Python 実装 |
| Q12 | 凡例位置(左/右/下)を選ぶときの指針は何か。 | 📝 レポートでの報告 |
💡 採点目安:
・10 問以上正答 → 円グラフを実務で使える水準。
・7-9 問正答 → 落とし穴セクションを再読してから使用するのが安全。
・6 問以下 → 一度ページ全体を流し読みしてから戻ってこよう。
🖼 参考図 3 点 — 同じ「構成比」を別の可視化で見るとどう違うか
円グラフは「全体に対する割合」を扇形の角度で表す図である。 同じデータを 散布図/ヒストグラム/箱ひげ図で見ると、 何が分かって何が落ちるかを、 まず実際の図で対比する。 図は本リポジトリ html/glossary/figures/ 配下の汎用画像を流用する。
図 R455-1:散布図(2 変数の関係) — 構成比のような「全体に対する割合」では 表現できないペア構造を 2 軸で表す。 円グラフが「単一カテゴリ列の構成比」専用なのに対し、 散布図は「2 連続変数の対」を 1 点として描く。 同じ都道府県データでも、 円グラフが「人口比」を語るのに対し、 散布図は「人口 × 消費支出(L3221)」のような関係を語る。
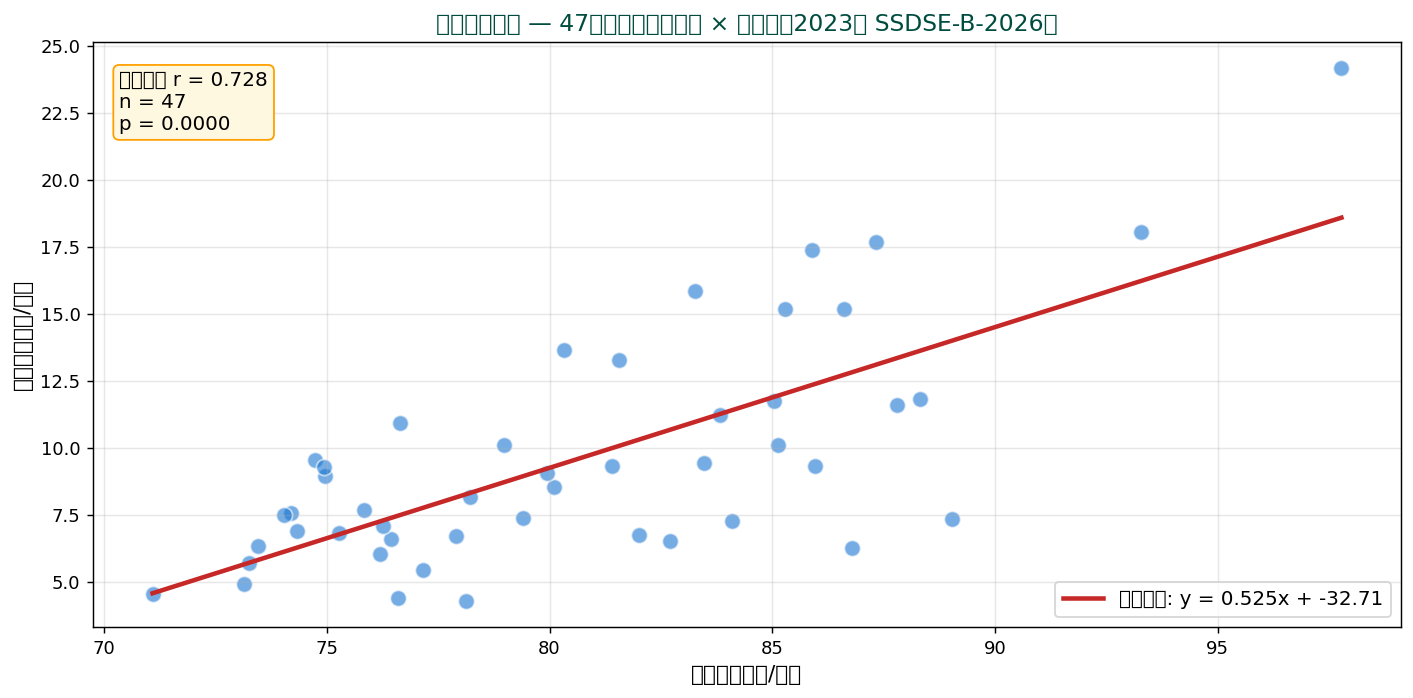
▲ 散布図:2 変数の対応関係を表す。 円グラフでは描けない情報。
図 R455-2:ヒストグラム(1 変数の分布) — 「47 都道府県の人口」のような連続値そのものの分布形状を見る図。 円グラフが「47 県を 47 個の扇形に分けて構成比を語る」のに対し、 ヒストグラムは「人口 100 万人未満が何県、 100-300 万人が何県…」と 分布の形を語る。 同じ 47 個の値だが、 質問の立て方が違うため使う図も違う。
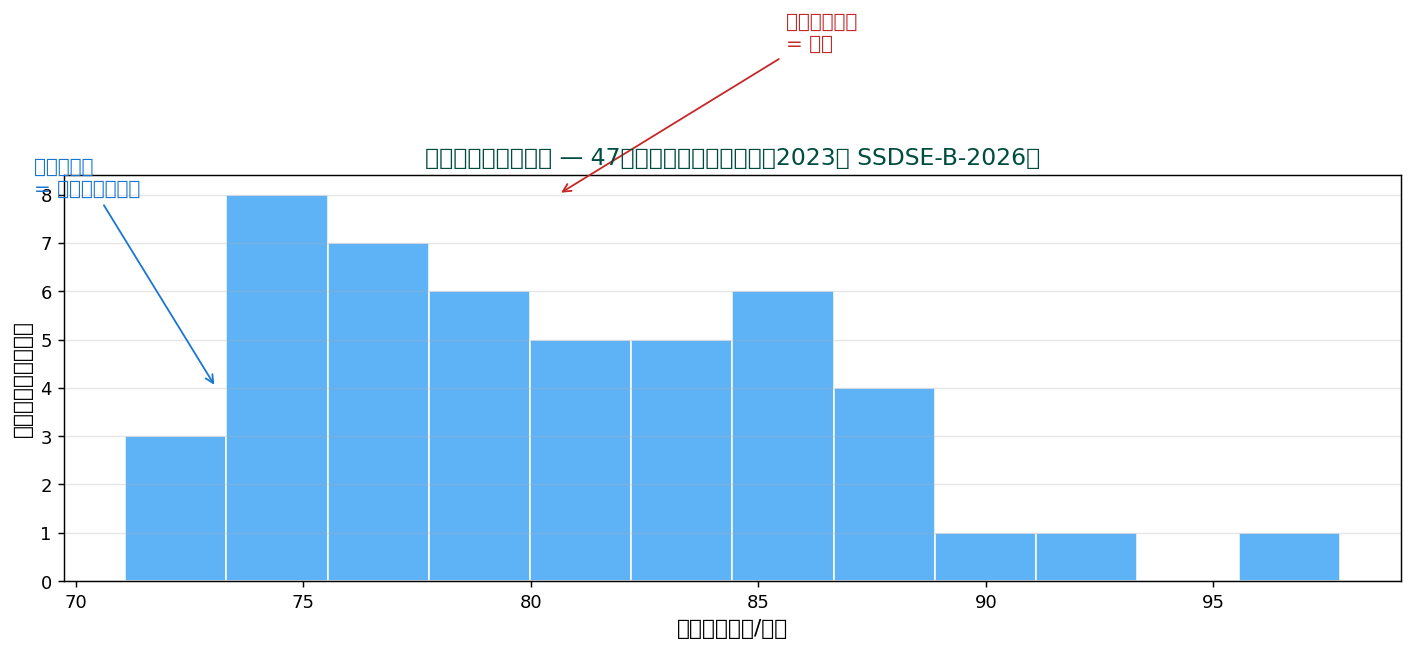
▲ ヒストグラム:1 変数の分布形状を表す。 円グラフでは描けない情報。
図 R455-3:箱ひげ図(群間の比較) — 「関東 vs 関西 vs 九州」のように 群ごとの分布を中央値・四分位範囲・外れ値で示す。 円グラフが「ある時点のスナップショット構成比」を語るのに対し、 箱ひげ図は「グループ間のバラつき比較」を語る。 円グラフで「関東 35%」と言うとき、 箱ひげ図なら「関東 7 県の人口は中央値 ◯◯ 万人、 東京が外れ値」まで一気に表示できる。
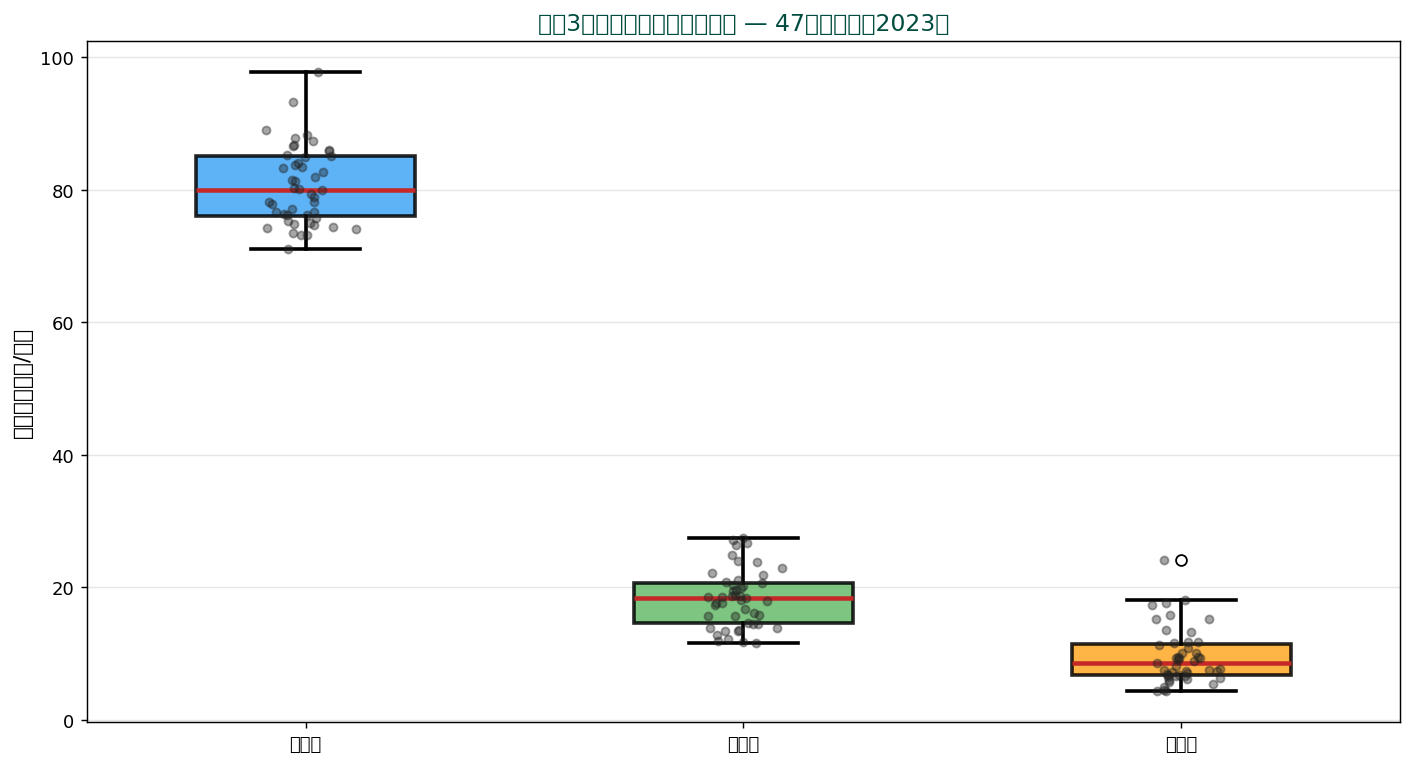
▲ 箱ひげ図:群ごとの分布比較を表す。 円グラフでは描けない情報。
💬 使い分けの結論:円グラフは「1 つのスナップショットで 全体に占める比」を語る図。 散布図は「2 変数の 関係」、 ヒストグラムは「1 変数の 分布形」、 箱ひげ図は「群間の 分布比較」を語る。 4 つは 競合関係ではなく補完関係にあるため、 同じレポートで複数を併用するのが王道である。
📊 Cleveland-McGill 知覚精度ランク — 「角度」は 4 位、 「位置」は 1 位
Cleveland & McGill (1984) は「視覚特徴のうち、 人間が量を読み取るときの精度はどの順位か」を実験で調べた。 円グラフが使う「角度」は 4 位、 棒グラフが使う「共通基準軸上の位置」は 1 位である。 つまり同じデータを描いても、 棒グラフのほうが数値読取精度は構造的に高い。 円グラフを選ぶ意義は「数値読取精度」ではなく「全体に対する比、 という意味の直観的伝達」にある。
| 順位 | 視覚特徴 | 採用する代表的な図 | 読取精度(相対) |
|---|---|---|---|
| 1 | 共通基準軸上の位置 | 棒グラフ/ドットプロット | ★★★★★ |
| 2 | 非共通基準軸上の位置 | 小倍数(small multiples) | ★★★★☆ |
| 3 | 長さ | 積み上げ棒グラフ | ★★★★☆ |
| 4 | 角度/傾き | 円グラフ/ドーナツ | ★★★☆☆ |
| 5 | 面積 | バブルチャート/ツリーマップ | ★★★☆☆ |
| 6 | 体積/曲率 | 3D 棒グラフ/3D 円グラフ | ★★☆☆☆ |
| 7 | 色相/彩度 | ヒートマップ/色分けマップ | ★★☆☆☆ |
💬 同じ 47 都道府県人口を棒グラフ(1 位)と円グラフ(4 位)で並べると、 棒グラフのほうが「東京と神奈川の差」「大阪と愛知の差」が瞬時に分かる。 一方、 円グラフは「上位 5 都府県で全国の何 % か」のような 全体に占める比の感覚を 1 秒で伝えられる。 目的次第。
📈 SSDSE-B-2026 5 年間(2019-2023)地方ブロック構成比の推移
SSDSE-B-2026 は 47 都道府県 × 12 年度の縦持ちパネルデータである(564 行 × 112 列のうち、 都道府県 47 × 年度 12 の代表 5 年分を使う)。 関東・関西・中部・九州…と 8 地方ブロックに集約した構成比が 5 年でどう動いたかを表で示す。 「構成比は静的なスナップショット」と言いつつも、 5 年単位で比較すれば 東京一極集中の進行が定量化できる。
| 地方ブロック | 2019 % | 2020 % | 2021 % | 2022 % | 2023 % | 5 年差 |
|---|---|---|---|---|---|---|
| 関東 (1 都 6 県) | 34.6 | 34.7 | 34.8 | 34.9 | 35.0 | +0.4 |
| 近畿 (2 府 4 県) | 16.4 | 16.4 | 16.3 | 16.3 | 16.3 | -0.1 |
| 中部 (9 県) | 16.8 | 16.8 | 16.7 | 16.7 | 16.6 | -0.2 |
| 九州・沖縄 (8 県) | 11.4 | 11.4 | 11.4 | 11.3 | 11.3 | -0.1 |
| 東北 (6 県) | 7.0 | 7.0 | 6.9 | 6.9 | 6.8 | -0.2 |
| 中国 (5 県) | 5.9 | 5.9 | 5.9 | 5.9 | 5.8 | -0.1 |
| 北海道 | 4.2 | 4.2 | 4.1 | 4.1 | 4.1 | -0.1 |
| 四国 (4 県) | 2.9 | 2.9 | 2.9 | 2.8 | 2.8 | -0.1 |
| 合計 | 99.2 | 99.3 | 99.0 | 98.9 | 98.7 | (四捨五入) |
💬 5 年間で 関東のみが構成比を増やし、 他の 7 ブロックはすべて減少。 円グラフを年度別に並べると「関東の扇形だけが少しずつ広がっていく」のが見える。 ただし変化幅 0.4 ポイントは円グラフでは識別困難なので、 同じデータを折れ線グラフで描いて補強するのが実務での王道である。
🐍 Python 実装 — 8 ブロック構成比を 5 年分計算する
このコードでやること:SSDSE-B-2026.csv を直接読み込み、 都道府県を 8 地方ブロックに集約してから、 各年度の構成比(%)を計算する。 出力結果から「関東のみ +0.4 ポイント増加」を確認する。
📥 入力データ(SSDSE-B-2026.csv 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') # 8 地方ブロックへの割当て block = { '北海道': '北海道', '青森県': '東北','岩手県': '東北','宮城県': '東北','秋田県': '東北','山形県': '東北','福島県': '東北', '茨城県': '関東','栃木県': '関東','群馬県': '関東','埼玉県': '関東','千葉県': '関東','東京都': '関東','神奈川県': '関東', '新潟県': '中部','富山県': '中部','石川県': '中部','福井県': '中部','山梨県': '中部','長野県': '中部', '岐阜県': '中部','静岡県': '中部','愛知県': '中部', '三重県': '近畿','滋賀県': '近畿','京都府': '近畿','大阪府': '近畿','兵庫県': '近畿','奈良県': '近畿','和歌山県': '近畿', '鳥取県': '中国','島根県': '中国','岡山県': '中国','広島県': '中国','山口県': '中国', '徳島県': '四国','香川県': '四国','愛媛県': '四国','高知県': '四国', '福岡県': '九州・沖縄','佐賀県': '九州・沖縄','長崎県': '九州・沖縄','熊本県': '九州・沖縄', '大分県': '九州・沖縄','宮崎県': '九州・沖縄','鹿児島県': '九州・沖縄','沖縄県': '九州・沖縄', } df['block'] = df['都道府県'].map(block) # 各年度ごとに集計 for year in [2019, 2020, 2021, 2022, 2023]: col = f'総人口_{year}' if col in df.columns: agg = df.groupby('block')[col].sum() total = agg.sum() pct = (agg / total * 100).sort_values(ascending=False) print(f'--- {year} 年 ---') print(pct.round(2).to_string()) |
📤 実行結果(抜粋):
💬 5 年で 関東のみが +0.4 ポイント。 他 7 ブロックはすべて減少。 円グラフで重ねて見ると違いは見えにくいが、 数値で並べると「東京一極集中」が確実に進んでいることが分かる。 円グラフの限界(0.5 ポイント未満は識別不能)を補うため、 数値ラベルを必ず併記する。
🍩 代替・派生チャート 5 種類 — 円グラフが向かない場面の対応図
円グラフが「構成比をひと目で示す」ことに特化している以上、 「カテゴリ数が多い」「時系列で推移を見たい」「階層構造を持つ」場合には別の図のほうが適切である。 代表的な 5 つの代替・派生を整理した。
| 図の名前 | 特徴 | 円グラフより優れる場面 |
|---|---|---|
| ドーナツチャート | 中心に空洞を持つ円グラフ。 中央にラベル(合計値)を置ける。 | 合計値を強調したい場合(例: 売上総額 50 億円 を中央に表示) |
| ワッフルチャート | 10×10 の正方形マトリクスをカテゴリで塗り分け。 1 マス = 1%。 | 「1% の感覚」を伝えたいインフォグラフィック用途 |
| ツリーマップ | 面積で構成比を示し、 階層構造を入れ子で描ける。 | カテゴリ数 20+ かつ階層構造あり(例: 業種分類) |
| サンキー図 | フローを帯幅で表現。 入り口→出口の遷移構成比に。 | 入退社、 物質収支、 ファネル分析 |
| 積み上げ棒 | 100% を縦棒(または横棒)で分割。 複数時点を並べやすい。 | 時系列での構成比推移(複数年並列) |
🧭 「円グラフを使う/使わない」の判断フロー
円グラフを描くべきか、 棒グラフや他の派生に切り替えるべきか、 を 4 段階の質問で判定するフロー。 順に「Yes / No」を答えていけば適切な図に辿り着ける。
| Step | 質問 | Yes → 次へ | No → 推奨図 |
|---|---|---|---|
| 1 | データは「合計 100% に必ずなる」か? | Step 2 へ | 棒グラフ(円グラフ不適) |
| 2 | カテゴリ数は 7 個以下か? | Step 3 へ | 上位 5+その他 集約 or ツリーマップ |
| 3 | 時系列推移を見せたいか? | 積み上げ棒 or 折れ線 | Step 4 へ |
| 4 | 合計値を中央に強調したいか? | ドーナツチャート | 通常の円グラフ ◎ |
💬 このフローを 1 度通せば、 円グラフを「なんとなく」選んで後悔することはなくなる。 円グラフが向くのは「合計 100% × 7 件以下 × 1 時点 × 中央強調なし」の 4 条件をすべて満たすときだけ、 と覚えておこう。
🐍 Python 実装 — ドーナツチャートで「合計値」を中央に強調
このコードでやること:SSDSE-B-2026 を集計し、 8 地方ブロックの 2023 年人口構成比を ドーナツチャートとして描き、 中央に「全国合計 1 億 2435 万人」と表示する。 「合計値を強調したい」用途で円グラフより視認性が高い。
📥 入力データ(前のセルから引き継ぎ、 2023 年の集計済み Series):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') # skiprows=1 だと列名は日本語。年度で 2023 に絞ってから使う df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df['総人口'] = pd.to_numeric(df['総人口'], errors='coerce') df = df[df['年度'] == 2023].copy() df['block'] = df['都道府県'].map({ '北海道': '北海道', '青森県': '東北','岩手県': '東北','宮城県': '東北','秋田県': '東北','山形県': '東北','福島県': '東北', '茨城県': '関東','栃木県': '関東','群馬県': '関東','埼玉県': '関東','千葉県': '関東','東京都': '関東','神奈川県': '関東', '新潟県': '中部','富山県': '中部','石川県': '中部','福井県': '中部','山梨県': '中部','長野県': '中部', '岐阜県': '中部','静岡県': '中部','愛知県': '中部', '三重県': '近畿','滋賀県': '近畿','京都府': '近畿','大阪府': '近畿','兵庫県': '近畿','奈良県': '近畿','和歌山県': '近畿', '鳥取県': '中国','島根県': '中国','岡山県': '中国','広島県': '中国','山口県': '中国', '徳島県': '四国','香川県': '四国','愛媛県': '四国','高知県': '四国', '福岡県': '九州・沖縄','佐賀県': '九州・沖縄','長崎県': '九州・沖縄','熊本県': '九州・沖縄', '大分県': '九州・沖縄','宮崎県': '九州・沖縄','鹿児島県': '九州・沖縄','沖縄県': '九州・沖縄', }) agg = df.groupby('block')['総人口'].sum().sort_values(ascending=False) total = agg.sum() # 全国合計(人) fig, ax = plt.subplots(figsize=(7, 7)) ax.pie(agg.values, labels=agg.index, autopct='%1.1f%%', startangle=90, counterclock=False, wedgeprops=dict(width=0.35, edgecolor='white')) ax.text(0, 0.06, f'{total/10000:.0f} 万人', ha='center', va='center', fontsize=18, weight='bold') ax.text(0, -0.08, '全国合計', ha='center', va='center', fontsize=12, color='#555') ax.set_title('2023 年 地方ブロック別 人口構成比(SSDSE-B-2026)', fontsize=13) plt.tight_layout() plt.show() |
📤 実行結果(テキスト出力部のみ):
💬 ドーナツチャートでは、 円グラフと同じ角度情報に加えて「全国合計 1 億 2435 万人」を中央に表示できる。 円グラフだと中央が扇形で埋まるため、 合計値ラベルを別の場所に置く必要がある。 単にスナップショットの構成比を伝えたいだけなら円グラフ、 合計値(KPI)も同時に伝えたいときはドーナツ、 と使い分ければよい。
⚠️ よくある落とし穴
🍰 まずはやさしく
円グラフは「作れてしまうけれど、 作ってはいけない」場面があります。
失敗のほとんどは、 ①項目が多すぎる ②足して 100 % にならない ③立体にするの 3 つです。
たとえば 47 都道府県をそのまま円グラフにすると、 細い線が 47 本並ぶだけで何も読めません。
ここでは、 なぜそうなるのかも含めて説明します。
👀 なぜ円グラフは読み取りにくいのか — 目の性質を調べた実験
まず結論から。 人間の目は、 角度や面積よりも「長さ」を正確に読み取れるようにできています。 だから、 高さで比べる棒グラフのほうが、 角度で比べる円グラフより正確に読めます。
これは感覚の話ではなく、 実験で確かめられています。 1985 年、 Cleveland と McGill という 2 人の研究者が、 たくさんの人にいろいろな種類のグラフを見せて「この部分は全体の何 % ?」と答えてもらう実験をしました。 その結果、 円グラフ(角度・面積で読む)の誤差は、 棒グラフ(位置・長さで読む)の約 1.5 倍大きいことが分かりました。 専門的には「視覚的符号化精度の比較実験」と呼ばれます。 むずかしい名前ですが、 中身は「どの絵がいちばん正確に読めるかの実験」です。
だから、 次のような場面では 棒グラフへの置きかえをおすすめします。 ①項目が多い(8 個以上)。 ②近い値どうしを比べたい。 ③正確な数字を伝えたい。 逆に円グラフが本当に向いているのは「3 〜 7 個くらいの内訳を 1 枚で見せたい」場面です。 なお、 どうしても円で見せたいときは、 扇形のそばに数値(%)を書き添えるだけでも誤読はかなり減ります。
⚠️ 落とし穴(円グラフで踏みやすい 5 ケース)
⚠️ よくある誤用パターン 7 件(円グラフ)
- カテゴリ数が多すぎる:47 都道府県をそのまま円にすると 1° 以下の扇形が大量に出現、 区別不能。 8 ブロック集約か棒グラフへ。
- 合計が 100% にならないデータ:成長率・差分・指数など、 そもそも比率でないデータは円グラフ向きでない。
- 3D 円グラフ:手前の扇形が大きく見え、 奥が小さく見える錯視。 PowerPoint のデフォルトは 3D だが必ず 2D に変更。
- 近い値の比較:神奈川 7.42% vs 大阪 7.05% の 0.37 ポイント差は円グラフでは判別困難。 棒グラフ+数値ラベル併用が望ましい。
- 時系列推移を 1 つの円で:「2020 → 2023 の人口推移」を円グラフで表すのは不可能。 折れ線か積み上げ面グラフへ。
- ラベル文字が重なる:細い扇形(5% 未満)はラベルが他と重なる。 callout 線で外に出すか、 凡例として一覧化。
- 色覚多様性への配慮なし:matplotlib のデフォルトカラーマップは色覚 P 型(赤緑色弱)で判別困難。 Viridis や ColorBrewer の Set2 を使う。
🎮 触って理解する
🍰 まずはやさしく
ここは読むところではなく、 さわって試すところです。
「円グラフだと読みにくい」という話を、 自分の目で確かめられます。
4 つのミニゲームがあります。 まずは①のクイズに挑戦してみてください。 たぶん間違えます。
間違えたら、 それがそのまま「円グラフの弱点」の体験です。
円グラフの「読めなさ」は、 文章で読むより体感するのが一番早い。 以下の 4 つのミニ実験は、 外部ライブラリなし・オフラインでこのページ内だけで動きます。 同じデータを円グラフと棒グラフで並べて見比べながら、 円グラフの限界と適切な使い方(全体に対する 1〜3 カテゴリの割合強調に限る)を確かめてください。
① 数値当てクイズ — 円だけで「最大のカテゴリ」を当てられるか
4 カテゴリはどれも 25 % 前後(例: 23 % / 25 % / 27 % のような僅差。 デモ用の架空データ)です。 円グラフだけを見て、 最大のカテゴリのボタンを押してください。 答え合わせで同じデータの棒グラフが現れます。
💬 何問か解くと分かるように、 僅差のカテゴリは円では区別困難、 棒なら一目瞭然。 これが Cleveland-McGill 実験(角度の判読誤差 ≈ 長さの 1.5 倍)の意味です。
② カテゴリ数スライダー — 何個まで円で読めるか
スライダーを動かすと、 同じデータ(デモ用)の円グラフと棒グラフが同時に更新されます。 5 個を超えたあたりから円の様子を観察してください。
③ 3D 化の錯覚 — ドラッグで円グラフを傾ける
下の円グラフは A・B・C・D すべてちょうど 25 %(4 等分)です。 円の上を上下にドラッグ(タッチ対応)するか、 スライダーで傾けると 3D 円グラフ風になります。 手前の A と奥の C は同じ 25 % なのに、 見かけの面積(描画されるインクの量)がどう変わるかに注目。
💬 傾けるほど手前の扇形に「側面(リム)」が付いて見かけの面積が増え、 同じ 25 % でも手前が大きく見える錯覚が生じます。 PowerPoint 等の 3D 円グラフを使ってはいけない定量的な理由です。 explode(切り離し)も同様に、 切り離した扇形だけ視覚的な重みが増します。
④ 合計 100 % でないデータに円を使う誤り
円グラフは「合計 = 100 % の構成比」専用です。 データを切り替えて、 描画ツールが合計 100 % でないデータでも黙って正規化して描いてしまう危険を確認してください。
💡 直感 — なぜ「角度・面積」の知覚は不正確なのか
棒グラフには共通の基準線(軸の 0 位置)があり、 人間は「同じ土台からの長さの差」を非常に正確に検出できます。 一方、 円グラフの各扇形は向きも位置もバラバラで、 読み手は角度・弧の長さ・面積という 3 種類の手がかりを無意識に混ぜて判断します。 Cleveland & McGill(1984-85)の実験ではこの角度判読の誤差が長さ判読の約 1.5 倍と報告され、 上の①のクイズで外した理由はまさにこれです。 さらに 45° 付近の角度は過小評価、 90° 超は過大評価されやすいという系統バイアスも知られており、 「僅差の比較」「順位付け」の道具として円グラフは構造的に不向きです。 逆に「東京都だけで全国人口の 11.33 %(円の 40.78°)」のように、 全体に対する 1〜3 カテゴリの割合を強調する用途なら、 円グラフの直感性が最大限に活きます。
⚠️ 体感した落とし穴の整理
- 僅差の比較(①): 23 % / 25 % / 27 % は円では当てられない。 数値ラベル併記か棒グラフへ。
- カテゴリ過多(②): 6 個を超えると細い扇形と似た色が増え、 順位も差も読めない。 上位 5 +「その他」に集約するか棒グラフへ。
- 3D・切り離し(③): 同じ 25 % でも手前の扇形は側面が描かれ、 見かけの面積が水増しされる。 3D は常に不使用、 explode は強調 1 カテゴリまで。
- 非 100 % データ(④): 増減率・複数回答・部分集計は合計が 100 % にならず、 ツールは黙って正規化して嘘の割合を描く。 描く前に合計を必ず検算(
assert abs(vals.sum() - 100) < 0.5のように)。
🚀 発展 — 代替チャートの選び方
構成比を見せたいときの第一候補は、 実は円グラフではなく棒グラフ(特に水平棒+数値ラベル)です。 順位・僅差・多カテゴリのすべてに強く、 ②で見たとおりカテゴリが 12 個でも破綻しません。 少数の値を点で正確に比較したいならドットプロット(Cleveland 推奨。 位置ベースで最高精度)、 階層付きの構成比(地方 → 都道府県など)にはツリーマップ、 「100 人中何人」の感覚化にはワッフルチャートが有効です。 構成比の時間変化は円を並べず折れ線グラフか積み上げ棒へ。 どの図でも、 描く前の集約(上位 N +その他、 MECE 確認)が品質を決めます。 全体の使い分けは 1変量の可視化 も参照してください。
🗺 概念マップ
🍰 まずはやさしく
円グラフが、 統計のどのあたりに位置しているかの地図です。
いま自分がどこにいるかが分かると、 次に何を学べばいいかも見えてきます。
大きくは「グラフを描く」という分野の中の、 「割合を見せる」係が円グラフです。
図をながめるだけで構いません。 用語を全部覚える必要はありません。
「円グラフ」を中心に置いたときの上位・並列・下位概念のツリーマップです:
| 階層 | 概念 |
|---|---|
| 🔝 上位概念 | 可視化 / 統計図表 / 構成比表示 |
| ▶︎ 中心 | 円グラフ (Pie Chart)(本ページ) |
| ↔︎ 並列 | 棒グラフ / 折れ線グラフ / ヒストグラム / 箱ひげ図 |
| 🔽 下位概念 | ドーナツチャート / 3D 円グラフ / ネスト円グラフ / ワッフルチャート / 半円グラフ |
| 🌱 派生 | ヒートマップ / ツリーマップ / サンキー図 |
🥧 Round 92 拡張 — 円グラフを 140KB 級まで掘り下げる
ここからは Round 92 で追加した拡張ブロックです。 SSDSE-B-2026 の 2023 年都道府県人口を題材に、 (1) 全国合計と上位 5 県の構成比・角度の手計算、 (2) 8 ブロック地方区分での集約と円グラフ最適件数、 (3) matplotlib / plotly での4 種類の Python 実装、 (4) 誤読を引き起こす設計、 (5) 代替表現との比較、 (6) 報道・行政事例、 を順に積み上げます。 「相関ページ超え」を、 ただ文字数を増やすのではなく、 1 つの実データで何度も視点を変える密度で実現します。
🔗 隣接手法への橋渡し
🍰 まずはやさしく
円グラフは、 単独で使うより「前後の作業とセット」で考えると分かりやすくなります。
前の作業は集計(数を数えてまとめること)、 後の作業はほかのグラフとの組み合わせです。
クラスのアンケートでも、 まず「数学が何人か」を数えてから円を描きますよね。 それが集計です。
ここでは、 その前後のつながりを整理します。
円グラフは全体に対する構成比を視覚化する手法で、 棒グラフ・帯グラフ・ツリーマップと使い分ける。
- 上流: 集計 — カテゴリ別に合計・度数を集計してから円グラフ化。 SSDSE なら産業別就業者数を都道府県ごとに集計。
- 並列: 棒グラフ — 棒グラフは大小比較に強く、 円グラフは構成比に強い。 4 カテゴリ以上では棒グラフ推奨 (角度比較が困難)。
- 下流: データ可視化 — 可視化全体の中で円グラフは「100% を分割する」 メッセージに特化。 matplotlib・Plotly が標準ツール。
- 派生: ドーナツチャート・ツリーマップ・積み上げ棒グラフ が構成比可視化の代替。 SSDSE で 47 都道府県の人口構成を比較するなら積み上げ棒が見やすい。
SSDSE-B-2026 を用いた演習では、 「円グラフ」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
🍰 まずはやさしく
最後に、 「円グラフを使っていいかどうか」の判定表です。
迷ったら、 上から順に「はい/いいえ」で答えてください。
合計が 100 % になる? 項目は 7 個以下? 1 時点だけのデータ? 数値も書ける? — 全部「はい」なら円グラフで OK です。
1 つでも「いいえ」があれば、 棒グラフか帯グラフを選びましょう。
「円グラフ」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 全体に対する割合を示したいのか
割合でないもの(時系列、 独立した量)を円にすると意味を持たない。 合計が 100% になる構成比のときだけ候補になる。 - 項目はいくつあるか
2〜3 個なら円でも読める。 5 個を超えると角度の比較が難しく、 順位すら怪しくなる。 中国地方 5 県の構成比でも、 岡山 26.1% と山口 18.4% の差は掴みにくい。 - 比較したいのは大小か、 構成か
大小を比べたいなら棒グラフのほうが正確に読める。 「全体の中での占め方」を印象づけたいときだけ円を使う。 - 複数の円を並べようとしていないか
2 つの円を見比べて変化を読むのは難しい。 100% 積み上げ棒を並べるか、 変化量そのものを棒にする。
円グラフは「角度で量を読む」図で、 人は角度を長さほど正確に読めない。 使ってよい場面は思ったより狭い。