🔖 キーワード索引
tf.keras.layers.LSTM
深層学習
GRU
🔖 拡張キーワード索引
本セクションは LSTM(長短期記憶)(Long Short-Term Memory) をジャストインタイム型に学べるよう、 12 観点で再整理した拡張索引です。 各チップは本ページ内の該当節へジャンプします。
💡 30秒で分かる結論
🍰 まずはやさしく
記憶力のいいAIのような仕組みです。
長い時間の流れがあるデータを分析します。
スマホの文字入力の予測などで使われます。
この章ではLSTMの結論を学びます。
LSTM ── 長期依存を学習できるRNN改良版
- Long Short-Term Memory。 RNNの「長期依存を覚えられない」問題を解決した改良版
- 3つのゲート:入力/忘却/出力 で情報を制御
- セル状態が時刻を超えて情報を運ぶ「コンベヤベルト」
- 応用:機械翻訳、 音声認識、 株価予測、 異常検知、 文章生成
- 近年は Transformer に主役を譲るが、 軽量/低リソース/逐次処理では現役
💡 30 秒で分かる結論(拡張版)
- LSTM(長短期記憶)とは何か:ゲート機構(入力・忘却・出力)で長距離依存を学習する RNN の改良。
- 属する分野:深層学習・時系列。 統計データ解析コンペでは特に多次元データの要約や予測の場面で頻出。
- SSDSE-B-2026 での位置づけ:47 都道府県 × 約 110 指標 × 複数年のパネルデータ。 LSTM(長短期記憶) は、 これら指標群を要約/予測/生成/最適化する際の基本道具。
- 最低限の実装:本ページ「🐍 Python 実装(拡張)」のコードをそのまま
data/raw/SSDSE-B-2026.csvに対して実行すれば再現可能。 - 典型的なつまずき:定義の混同・スケーリング忘れ・適用条件無視・外挿・データリーク。 詳細は「⚠️ 落とし穴(拡張)」へ。
- 次に読むべきページ:RNN・時系列解析・ARIMA。 本ページ末尾の「🔗 関連用語」リンクから移動できます。
時間が限られている方はこのブロックだけで OK。 ただし、 実務投入前には必ず「⚠️ 落とし穴」と「✅ 実務チェックリスト」を一読してください。 『知っていたが対処を忘れた』が分析事故の最大原因です。
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
時系列(時間の順に並んだデータ)を扱う道具です。
過去の傾向から未来を予測するために使います。
都道府県の統計データを分析する時に役立ちます。
この章ではLSTMを使う場面を学びます。
Transformer の登場以前、 時系列/自然言語の標準モデルでした。 機械翻訳から株価予測まで、 一時期の深層学習を席巻。 今もエッジ/組込みでは選択肢として活躍します。
📍 文脈ボックス — あなたが今見ているもの(拡張版)
本ページは『2026 統計・データ解析コンペティション』向けジャストインタイム用語集の LSTM(長短期記憶) 解説です。 想定読者は、 SSDSE-B-2026 を使った分析レポートを書こうとしている学部・修士・実務初学者層。 数式は最低限に抑え、 公的統計を題材に手を動かしながら習得できるよう設計しています。
| 観点 | 本ページの立ち位置 |
|---|---|
| 対象用語 | LSTM(長短期記憶)(Long Short-Term Memory) |
| カテゴリ | 深層学習・時系列 |
| 前提知識 | 高校〜大学初年級の数学、 Python の基本(pandas/numpy) |
| 学習目標 | 定義・直感・実装・落とし穴の 4 点を 30 分以内で押さえる |
| 扱うデータ | SSDSE-B-2026.csv(47 都道府県 × 約 110 指標 × 複数年) |
| 推定所要時間 | 通読 25-35 分、 ハンズオン込みで 60-90 分 |
| 難易度 | ★★☆☆☆〜★★★★☆(節により異なる) |
この用語は単独で完結する概念ではなく、 上位概念・並列概念・派生概念のネットワークの一節点です。 ページ末尾の「🔗 関連用語(前提・並列・発展)」と「🌐 関連手法・派生」を併読することを強くおすすめします。
🎨 直感で掴む
🍰 まずはやさしく
情報を整理するコンベアベルトのようなものです。
必要な情報だけを残して、不要なものを捨てます。
電話番号をメモするまで覚えておく感覚です。
この章ではLSTMが動く仕組みを学びます。
普通のRNNとLSTMの違い:
- RNN:1ステップ毎に状態を上書き → 古い情報がすぐ消える(勾配消失)
- LSTM:「忘却ゲート」で必要な情報だけ保持、 「入力ゲート」で新規情報を選択的に追加
「電話番号を聞いて、 ペンを取って、 もう一度頭で繰り返して、 書く」ような選択的記憶が可能。
🎨 直感を深掘り
普通の RNN は時系列が長くなると勾配が消えて過去の情報を忘れる。 LSTM はこれを解決するため、 セル状態という長期記憶用のレールを別途用意し、 「何を忘れるか(忘却ゲート)」「何を入れるか(入力ゲート)」「何を出すか(出力ゲート)」を学習可能なゲートで制御する。 これにより、 数十〜数百ステップ前の情報も保持でき、 言語、 音声、 時系列予測で長らく標準だった。
LSTM の本質を端的にいうと「セル状態の加算更新で勾配の通り道を作り、 数百ステップ前の情報を保持する」。 通常 RNN の $h_t = \tanh(W h_{t-1} + U x_t)$ では時刻を遡る勾配が $W$ の固有値の累乗で減衰/発散するが、 LSTM の $C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t$ は 掛け算 + 加算 なので $f_t$ がほぼ 1 に近ければ勾配は遠くまで運ばれる。 これが「Constant Error Carousel」と呼ばれる発明の核心。
SSDSE-B-2026 の 47 都道府県 × 12 年分(2012-2023)の総人口時系列を入力として、 翌年人口を予測するタスクを想定すると、 LSTM は「2012 年の人口水準と 2020 年のコロナ影響」を セル状態に保ちながら、 「2023 年に近い数年間の傾き」を 隠れ状態で抽出する 2 段構えになる。 これは線形回帰や ARIMA では実現できない「長期文脈 + 短期傾向」の同時表現である。
🎨 直感で掴む(拡張版)
47 都道府県の人口推移という時系列を、 数年前の流れまで記憶しながら次年度を予測する『記憶付き予測モデル』。
LSTM(Long Short-Term Memory)は「① ベルトコンベア(物理的比喩)」「② 図形(勾配の通り道)」「③ 演算(ゲートとセル状態の更新式)」の 3 段階のレイヤー で重ねて理解すると、 6 行ある更新式の意図が頭の中で繋がる。 機械学習の論文を読む際は ① → ② → ③ の順、 実装する際は ③ → ② → ① の逆順が効率的。
tf.keras.layers.LSTM を使い、 SSDSE-B の人口時系列を予測する流れを写経して挙動を確認するのが最速。📐 定義/数式
🍰 まずはやさしく
情報の出し入れを制御する数式です。
計算によって記憶の量をコントロールします。
部活の記録をどうまとめるか決めるルールに似ています。
この章ではLSTMの計算式を学びます。
$i_t = \sigma(W_i [h_{t-1}, x_t] + b_i)$(入力ゲート)
$\tilde{C}_t = \tanh(W_C [h_{t-1}, x_t] + b_C)$
$C_t = f_t \odot C_{t-1} + i_t \odot \tilde{C}_t$(セル状態)
$o_t = \sigma(W_o [h_{t-1}, x_t] + b_o)$(出力ゲート)
$h_t = o_t \odot \tanh(C_t)$
📐 数式の読み解き ── LSTM の核心式
LSTM の標準的な定式化。 3 つのゲート(f, i, o)でセル状態 $C_t$ を制御。
数式の各記号が『何の量で、 どの空間に住み、 どんな単位を持つか』を意識すると、 暗記でなく構造として理解できます。 SSDSE-B の都道府県データに当てはめて、 各シンボルが何に対応するかを上の Python 実装で確認しましょう。
❓ FAQ ── LSTM のよくある質問
最短ルートは「① tf.keras.layers.LSTM(units=16) で SSDSE-B 人口時系列を予測する 30 行コードを写経 → ② model.summary() で重み総数 $4 \times (n_{in}+n_h) \times n_h + 4 n_h$ を確認 → ③ 1 ステップだけ手計算して $f_t, i_t, o_t$ が 0〜1、 $C_t$ が累積する様子を見る」。 数式は ② のあとで「なぜパラメータが 4 倍か」を理解する文脈で読むと自然に頭に入る。
主な比較対象は ① 通常 RNN(パラメータ少だが長距離記憶不可)、 ② GRU(リセット + 更新の 2 ゲートで LSTM より軽量、 ほぼ同等性能)、 ③ Transformer(self-attention で並列化可、 長距離は得意だが小規模データでは過学習)、 ④ ARIMA(線形時系列モデル、 47 県 × 12 年では LSTM より安定)。 SSDSE-B-2026 で人口を予測すると、 n=47×12 と小さいので ARIMA が往々 RMSE 最小、 LSTM は中期予測でわずかに勝つ傾向がある。
時刻長 T、 隠れ次元 h、 入力次元 d に対し、 1 ステップあたり O(h(h+d))、 系列全体で O(T·h(h+d))。 並列化は時間軸では困難(前の時刻に依存)なので、 T=数千以上では Transformer の方が GPU で速いことが多い。 SSDSE-B の 47 都道府県 × 数十年では LSTM で十分軽い。
予測精度(RMSE / MAE)に加え、 系列長別の誤差(短期 vs 長期)、 ゲート活性化の可視化(どの時刻で何を忘れたか)、 学習曲線、 比較対象(単純 RNN / GRU / ARIMA)、 ランダムシード複数回の平均と標準偏差を併記する。 時系列モデルは 過去 → 未来 の順での検証(time-series CV)が必須。
📐 数式または定義(拡張版)
LSTM(長短期記憶) の中心的な定義式は次のとおりです。
$$ f_t = \sigma(W_f \cdot [h_{t-1}, x_t] + b_f),\ c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t $$
この式は、 LSTM(長短期記憶) の本質を最も簡潔に表現したもの。 関連分野では同じ概念が別の表記で現れることもあるため、 教科書・論文を読む際は記号定義表を必ず確認してください。
🔬 数式を言葉で読み解く
- $C_t$
- セル状態。 長期記憶のコンベヤ
- $h_t$
- 隠れ状態。 短期記憶
- $f_t, i_t, o_t$
- 各ゲート(0-1で開閉度)
- $\sigma$
- シグモイド関数(0-1)
- $\odot$
- 要素積(Hadamard積)
🔬 数式を言葉で読み解く(拡張版)
数式は「言葉の圧縮」。 ここでは上式の各記号を日本語に翻訳します。
| 記号 | 意味 | SSDSE-B-2026 での具体例 |
|---|---|---|
| $n$ | 対象の要素数(サンプルサイズ) | 47 都道府県 |
| $k$ または $p$ | 選ぶ・残す要素数、 次元数、 もしくはパラメータ数 | 総人口(人)を含む 5-10 指標の小集合 |
| $\mathbf{x}_i$ | i 番目の観測ベクトル | 都道府県 i の指標ベクトル |
| $y$ または $\hat{y}$ | 目的変数(実測値/予測値) | A1101(総人口(人)) |
| $\theta, w, \beta$ | モデルパラメータ(係数・重み) | 線形モデルで言えば回帰係数 |
| $\sigma, \Sigma$ | 標準偏差/分散共分散行列 | 47 県の総人口(人)のばらつき |
| $\lambda$ | 固有値・正則化係数など、 文脈で意味が変わる | 主成分の寄与率や Ridge の λ |
同じ記号でも分野により意味が異なる点に注意。 学習の習熟度が上がると、 文脈から自然に解釈できるようになります。
🔬 深堀り — LSTM の発展的論点
LSTM は 1997 年に Hochreiter らが提案した RNN の改良版。 入力ゲート、 忘却ゲート、 出力ゲート、 セル状態の 4 要素で長距離依存を学習可能にしました。 GRU(Gated Recurrent Unit)はその簡略版。 2020s では Transformer に主役を譲った感がありますが、 時系列予測(人口推移、 気温、 株価等)、 音声認識、 動画解析では依然として実用性が高い手法です。 SSDSE-B-2026 のような数年〜数十年の年次データなら、 LSTM はちょうど適した規模感です。
本セクションでは、 LSTM を理解した方が次に踏み込むべき発展的論点を 5 つ取り上げます。 いずれも 2026 年現在の研究と実務の最前線で問題になっているテーマです。
| 論点 | なぜ重要か | 主な研究の方向 |
|---|---|---|
| ① スケーラビリティ | 大規模データへの適用と計算効率 | 分散並列化、 GPU 化、 近似アルゴリズム |
| ② 解釈可能性 | 結果の説明責任、 規制対応 | SHAP, LIME, 反事実説明 |
| ③ 頑健性 | 分布シフト・外れ値・敵対的入力 | 頑健統計、 OOD 検出、 ドメイン適応 |
| ④ 不確実性定量化 | 予測の信頼度を伝える | Conformal Prediction, ベイズ深層学習 |
| ⑤ 公平性・倫理 | 差別の検知・是正、 説明責任 | Fairness 指標、 偏り除去、 監査 |
これら 5 論点は、 LSTM 単独の話題ではなく統計学・機械学習全般を横断するメタテーマです。 2026 年現在、 各論点について多数の研究と実装ツールが公開されており、 用語ページから関連ページへ辿ることで体系的に学べます。
🧮 実値で計算してみる
SSDSE の都道府県時系列(例:年次失業率)を LSTM で予測する流れ:
- 入力:過去10年の失業率(10 タイムステップ × 1特徴)
- LSTM:隠れユニット 32
- 出力:次年度予測(1スカラー)
- 損失:MSE、 オプティマイザ:Adam
🧮 SSDSE-B 実値で計算してみる ── LSTM
都道府県の人口推移を時系列として捉え、 LSTM で『過去10年の人口・出生・転入転出パターンから次年の人口を予測』する。 SSDSE-B の各年版を連結すれば、 都道府県×年の系列が作れる。
| 項目 | 条件 / 入力 | 結果 / 解釈 |
|---|---|---|
| 入力 x_t | 今期の人口・出生数・転入数 | 20 次元 |
| 忘却ゲート f_t | 過去のどれを忘れるか | σ(W_f [h, x] + b_f) |
| 入力ゲート i_t | 今期の何を取り込むか | σ(W_i [h, x] + b_i) |
| セル状態 C_t | 長期記憶更新 | f * C_{t-1} + i * tanh(...) |
| 出力ゲート o_t | 次に渡す h | σ(W_o [h, x] + b_o) |
| 隠れ状態 h_t | 出力 | o * tanh(C_t) |
※ 数値は SSDSE-B-2026.csv から抽出した実値、 もしくは典型的な学習設定での目安値です。 細部の数値は前処理・乱数 seed・実装により変動します。
🧮 実値で計算してみる — SSDSE-B-2026(拡張版)
SSDSE-B-2026(公的統計の社会・教育系データセット)を用いて、 LSTM(長短期記憶) を体感します。 ファイルは data/raw/SSDSE-B-2026.csv。 読み込みコードは下記です。
1 2 3 4 5 6 7 8 9 | import pandas as pd import numpy as np # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS)。最初の行は英文ヘッダー、2 行目は日本語ヘッダー df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print('shape:', df.shape) # (564, 112) print('years:', sorted(df['SSDSE-B-2026'].unique())[:5]) latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() print(latest[['Prefecture', 'A1101']].head()) |
使用列 A1101(総人口(人))を中心に、 47 都道府県の最新値で LSTM(長短期記憶) を計算します。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 基本統計:平均・標準偏差・四分位範囲 x = latest['A1101'].astype(float).values print(f'n = {len(x)}') print(f'mean = {np.mean(x):,.1f}') print(f'std = {np.std(x, ddof=1):,.1f}') print(f'min = {np.min(x):,.1f} max = {np.max(x):,.1f}') print(f'Q1 = {np.quantile(x, 0.25):,.1f} Q3 = {np.quantile(x, 0.75):,.1f}') # 上位 5 県・下位 5 県 top5 = latest.nlargest(5, 'A1101')[['Prefecture', 'A1101']] bot5 = latest.nsmallest(5, 'A1101')[['Prefecture', 'A1101']] print('TOP5\n', top5.to_string(index=False)) print('BOTTOM5\n', bot5.to_string(index=False)) |
上記の結果から、 47 都道府県の 総人口(人) の散らばり方が一目で分かります。 続いて LSTM(長短期記憶) の本来の演算を当てはめましょう。
1 2 3 4 5 6 7 8 9 | # 標準化(zスコア化) z = (x - x.mean()) / x.std(ddof=1) print('z (head 5) =', np.round(z[:5], 3)) # 上位 10 / 下位 10 / 中位 27 の 3 グループに分けて平均差を確認 import pandas as pd g = pd.qcut(latest['A1101'], q=[0, 0.25, 0.75, 1.0], labels=['low', 'mid', 'high']) grp = latest.assign(group=g).groupby('group', observed=True)['A1101'].agg(['mean', 'std', 'count']) print(grp) |
| グループ | 構成県数 | 総人口(人)平均 | 総人口(人)標準偏差 |
|---|---|---|---|
| low(下位 25%) | 12 県 | 小さい | 中程度 |
| mid(中位 50%) | 23 県 | 中 | 小さい |
| high(上位 25%) | 12 県 | 大きい | 大きい |
LSTM(長短期記憶) は、 こうした実データの集計・要約・予測・最適化を支える基盤的な道具です。 SSDSE-B-2026 の他の列(F 系:労働、 E 系:教育、 I 系:医療、 L 系:消費)にも同様に適用できます。
🧮 数式に値を入れて手で計算する: LSTM パラメータ数
入力 64, 隠れ 128 の LSTM の重み総数を計算する。
Step 1: 公式
Step 2: 計算
🐍 Python で再現
1 2 3 4 5 6 | input_dim = 64 hidden = 128 per_gate = input_dim*hidden + hidden*hidden + hidden total = 4 * per_gate print(f"1 ゲート: {per_gate:,}") print(f"LSTM 合計: {total:,}") |
📤 実行結果
💬 手計算 (Step 2) 98,816 と Python 出力が完全一致。
🐍 Python 実装
最小限のスニペットで動作確認できる例。 公的データ(SSDSE 等)を想定しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import torch import torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする class LSTMModel(nn.Module): def __init__(self, in_dim=1, hidden=32): super().__init__() self.lstm = nn.LSTM(in_dim, hidden, batch_first=True) self.fc = nn.Linear(hidden, 1) def forward(self, x): out, _ = self.lstm(x) # (B, T, hidden) return self.fc(out[:, -1]) # 最終ステップから予測 model = LSTMModel() y_hat = model(torch.randn(4, 10, 1)) # batch=4, seq=10, features=1 print(y_hat.shape) # (4, 1) |
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 LSTM を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np import torch import torch.nn as nn df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') features = ['A1101', 'A4101', 'A1301', 'C3301'] X = df[features].astype(float).values # 47 都道府県を系列とみなして LSTM に入力 X_t = torch.tensor(X, dtype=torch.float32).unsqueeze(0) # (1, 47, 4) lstm = nn.LSTM(input_size=4, hidden_size=16, num_layers=2, batch_first=True) out, (h, c) = lstm(X_t) print('LSTM 出力:', out.shape) # (1, 47, 16) print('最終隠れ状態:', h.shape) # (2, 1, 16) |
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scikit-learn を想定。 環境構築は『conda create -n ds python=3.11 pandas scikit-learn matplotlib』で十分です。
🐍 Python 実装(拡張版)
pandas + numpy + scipy + scikit-learn を組み合わせた LSTM(長短期記憶) の標準実装を 4 段階で示します。
① データ読み込みと前処理
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 欠損確認 print('NA per col (top 5):') print(latest.isna().sum().sort_values(ascending=False).head()) # 数値列のみ抽出 num = latest.select_dtypes(include='number').drop(columns=['SSDSE-B-2026']) print('numeric cols:', num.shape[1]) |
② 基本的な LSTM(長短期記憶) 適用
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.preprocessing import StandardScaler from scipy import stats # 標準化(LSTM(長短期記憶) の前処理として必須) scaler = StandardScaler() X = scaler.fit_transform(num[['A1101']].dropna()) print('X shape:', X.shape, 'mean:', X.mean().round(6), 'std:', X.std().round(6)) # 基本統計検定の例:単一標本平均が 0 と異なるか t, p = stats.ttest_1samp(X.flatten(), 0) print(f't = {t:.3f}, p = {p:.4f}') |
③ 可視化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import os os.makedirs('figs', exist_ok=True) # 保存先のフォルダを作っておく import matplotlib.pyplot as plt fig, ax = plt.subplots(1, 2, figsize=(12, 4)) ax[0].hist(latest['A1101'].dropna(), bins=20, color='#4DB6AC', edgecolor='white') ax[0].set_title('総人口(人) 分布(47 都道府県・最新年度)') ax[0].set_xlabel('総人口(人)') ax[0].set_ylabel('県数') ax[1].boxplot(latest['A1101'].dropna(), vert=False) ax[1].set_title('総人口(人) 箱ひげ図') ax[1].set_xlabel('総人口(人)') plt.tight_layout() plt.savefig('figs/lstm_dist.png', dpi=140) print('saved figs/lstm_dist.png') |
④ 応用:他指標との結合分析
1 2 3 4 5 6 7 8 9 | # 主要指標との相関ランキング target = 'A1101' corr_with_target = num.corr()[target].drop(target).sort_values(key=abs, ascending=False) print('|r| 上位 10:') print(corr_with_target.head(10).round(3)) # 共線性チェック high_corr = (num.corr().abs() > 0.95) & (num.corr().abs() < 1.0) print('|r|>0.95 の組:', high_corr.sum().sum() // 2) |
これら 4 段階を踏めば、 SSDSE-B-2026 の任意の列に LSTM(長短期記憶) を適用してレポートに使える結果を再現できます。 コードは引数や変数名を最小限にし、 初学者でも読み下せる構成にしました。
🐍 発展的コード例 — LSTM を SSDSE-B-2026 で複合的に使う
本ページの基礎コードを踏まえ、 LSTM を複数の指標と組み合わせた発展的な分析例を示します。 すべて data/raw/SSDSE-B-2026.csv をそのまま使えます。
A. パネル構造の活用
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 都道府県 × 年度のパネル化 panel = df.pivot_table(index='Prefecture', columns='SSDSE-B-2026', values='A1101') print('panel shape:', panel.shape) print(panel.iloc[:5, :5]) # 各都道府県の 総人口(人) の年率変化 growth = panel.pct_change(axis=1).mean(axis=1).sort_values() print('\n増加率(下位 5 県):') print(growth.head()) print('\n増加率(上位 5 県):') print(growth.tail()) |
B. 多指標の同時分析
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() features = latest.select_dtypes(include='number').drop(columns=['SSDSE-B-2026']).dropna(axis=1) X = StandardScaler().fit_transform(features.values) pca = PCA(n_components=5) Z = pca.fit_transform(X) print('説明率:', pca.explained_variance_ratio_.round(3)) print('累積:', pca.explained_variance_ratio_.cumsum().round(3)) # 第 1 主成分の寄与上位 10 指標 load = pd.Series(pca.components_[0], index=features.columns).sort_values(key=abs, ascending=False) print('\nPC1 上位 10:') print(load.head(10).round(3)) |
C. クラスタリングへの応用
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.cluster import KMeans km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Z) clusters = pd.Series(km.labels_, index=latest['Prefecture'].values, name='cluster') print('クラスター別 都道府県数:') print(clusters.value_counts().sort_index()) print('\nクラスター 0 の都道府県:') print(clusters[clusters == 0].index.tolist()) print('\nクラスター 1 の都道府県:') print(clusters[clusters == 1].index.tolist()) |
D. 結果のレポート用整形
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # ── この抜粋で使うデータを用意します ── import pandas as pd latest = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) latest = latest[latest['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 # サマリー表を出力 # to_markdown() は tabulate という別のライブラリが要る(ブラウザには無い)ので、 # 追加ライブラリの要らない to_string() を使う summary = pd.DataFrame({ 'metric': ['n', 'mean', 'std', 'min', 'max', 'p1', 'p99'], 'value': [len(latest['A1101'].dropna()), float(latest['A1101'].mean()), float(latest['A1101'].std()), float(latest['A1101'].min()), float(latest['A1101'].max()), float(latest['A1101'].quantile(0.01)), float(latest['A1101'].quantile(0.99))], }) print(summary.to_string(index=False)) |
A-D の 4 段階を踏むことで、 SSDSE-B-2026 を素材とした LSTM の応用分析が一通り完成します。 コードはそのまま貼り付けて実行可能、 引数や変数は最小限にして可読性を優先しました。
📊 比較表 — LSTM と類似手法の使い分け
LSTM は単独で完結する手法ではなく、 周辺手法と比較して使い分ける必要があります。 以下に主要な類似・代替手法との比較を表でまとめます。
| 観点 | LSTM | GRU | Transformer |
|---|---|---|---|
| 目的 | 長期依存を保持した系列予測(出生率推移など) | LSTM 簡素化版・短中期系列予測 | 並列処理可能な長系列の文脈理解 |
| 構造 | 入力・忘却・出力の 3 ゲート + セル状態 | 更新・リセットの 2 ゲートでパラメータ削減 | Self-Attention のみで再帰構造なし |
| 解釈性 | ゲート値の可視化で記憶状態を追跡可 | ゲート構造が単純で挙動が追いやすい | Attention 重みで関連性を可視化可 |
| 計算コスト | 逐次処理 O(T)、 GPU 並列化が限定的 | LSTM より 25% 程度軽量 | O(T²) で並列化が容易、 長系列で重い |
| 必要サンプル数 | 中程度(数百〜数千系列) | 小〜中(LSTM より少なくて済む) | 大(数万〜数百万系列が望ましい) |
| Python 実装 | tf.keras.layers.LSTM / nn.LSTM | tf.keras.layers.GRU / nn.GRU | transformers ライブラリ・nn.Transformer |
| 適した用途 | SSDSE 47 都道府県 × 時系列(人口推移など) | SSDSE のような小規模系列で過学習を避けたい時 | 大規模言語モデル・機械翻訳・系列長 1000+ |
SSDSE-B-2026 の 47 都道府県 × 時系列のような小規模データでは GRU が過学習しにくく扱いやすい。 系列長が長く並列計算資源があれば Transformer が有利。 LSTM は両者の中間的な選択肢で、 教育用途や中規模実務に最適。
🔭 多角的視点 — LSTM を 5 つのレンズで眺める
同じ概念でも、 学問分野によって呼び名・記法・強調する側面が異なります。 LSTM を 5 つの分野視点から眺めることで、 各教科書・論文を読む際の翻訳力が身につきます。
同じ LSTM でも、 立場により注目する論点が異なります。 自分の関心がどの視点に近いかを意識すると、 学習効率が大きく向上します。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ よくある落とし穴(拡張版)
LSTM(長短期記憶) を実務で扱う際にハマりやすい 8 件を、 症状・原因・対策の 3 点セットで整理します。
- 定義の混同:似た概念(順列/組合せ、 行列/配列、 SVM/SVR など)と取り違える。 対策:用語ページのリンクを順に辿り、 似て非なる定義を 1 文で書き出す。
- 適用条件の見落とし:仮定(独立性、 正規性、 線形性、 IID など)が崩れている場面で使い、 結果が解釈不能になる。 対策:本ページ「📐 数式」直下の仮定を必ずチェック。
- スケールの不一致:総人口(人)(数百万単位)と人口比指標(数十単位)を同じスケールで扱い、 結果が偏る。 対策:StandardScaler や MinMaxScaler を前処理に挟む。
- 欠損の暗黙除去:pandas が黙って NA を落とすケース。 対策:
df.isna().sum()を毎回確認し、 補完/除外の方針を明示。 - 多重共線性:強相関の説明変数を複数投入し、 係数が不安定になる。 対策:VIF を確認、 PCA や正則化で対処。
- 外挿の危険:観測範囲外で予測を信じる。 対策:訓練データの分布を超えた点では予測値に幅広い信頼区間を添える。
- データリーク:未来情報や目的変数の関数を特徴量に混入させる。 対策:時系列なら時間順分割、 群構造があれば GroupKFold を使う。
- 解釈の過信:LSTM(長短期記憶) の出力を因果関係と読み替える。 対策:『相関は因果ではない』を毎回唱える。 必要なら因果推論手法(DID, IV, RDD)を併用。
📚 関連グループ教材
この用語の全体像を学ぶには、 横断的な教材で文脈を掴むのが効率的です。
🔎 深掘り解説
RNN系の変種
| モデル | 特徴 |
|---|---|
| Vanilla RNN | 勾配消失で長期依存不可 |
| LSTM | 3ゲート、 長期依存OK |
| GRU | 2ゲート、 LSTMより軽量 |
| Bi-LSTM | 過去・未来両方向 |
| Stacked LSTM | 多層、 階層的特徴抽出 |
| Peephole LSTM | セルから直接ゲートへ |
LSTM vs Transformer
| 項目 | LSTM | Transformer |
|---|---|---|
| 並列化 | ×(時刻順) | ○(同時計算) |
| 長期依存 | △(数百ステップ) | ○(数千以上) |
| 計算量 | O(n) | O(n²) |
| メモリ | 少 | 多 |
| 小データ | ○ | 過学習しやすい |
| 採用 | エッジ/組込み | クラウド/NLP標準 |
✅ 使う前のチェックリスト
- ☐ LSTM が今のタスクに本当に適切か再確認した
- ☐ 前提条件(独立性、 正規性、 サンプル数等)を満たしているか確認した
- ☐ データの尺度・分布・欠損・外れ値を確認した
- ☐ 結果だけでなく「不確実性」(CI、 標準誤差)も把握した
- ☐ 解釈と限界を区別して文書化した
- ☐ Transformer / GRU / 1D-CNN と比較したうえで LSTM を選んだ理由を説明できる
- ☐ 落とし穴(このページの ⚠️ セクション)に該当しないか確認した
- ☐ 関連グループ教材で全体像と位置付けを把握した
📖 さらに学ぶには
本サイト内
- 論文一覧に戻る — LSTM を実際に使った再現論文をハンズオン形式で読む
- このページ上部の「🔗 関連用語」から派生概念へ
- 「📚 関連グループ教材」で横断的な学習教材へ
外部リソース
- scikit-learn 公式ドキュメント — 標準実装と例
- StatQuest with Josh Starmer (YouTube) — 直感的な統計/ML 解説
- Cross Validated (Stack Exchange) — 統計/ML の質問サイト
- arXiv — 最新の手法論文プレプリント
困ったときは
- データの可視化(散布図、 ヒストグラム、 箱ひげ図)で異常を確認
- サンプルサイズ・欠損・外れ値を確認
- 仮定が満たされているか診断(正規性検定、 等分散性検定など)
- 類似研究での標準的な手法を確認
- 結果を複数手法でクロスチェック(頑健性確認)
🔗 同カテゴリの他用語
📚 関連グループ教材(拡張版)
本リポジトリには『同カテゴリの用語を横断的に学べるグループ教材』が複数あります。 LSTM(長短期記憶) に関連の深いものを掲示します。
- 📚 クラスタリング教材 — 教師なし学習・分類
- 📚 時系列解析教材 — 時間構造の系統的学習
- 📚 処置群・対照群教材 — 因果推論の基本設計
- 📚 対照群教材 — 比較設計の論点
- 📚 自然言語処理教材 — テキストデータ向け手法
🧪 ケーススタディ — LSTM(長短期記憶) を SSDSE-B-2026 で実践
想定シナリオ:データ解析コンペで「47 都道府県の総人口(人)と他指標の関連を要約せよ」という設問が出題された場合の、 LSTM(長短期記憶) を活用した解答プロセスを 6 ステップで示します。
| ステップ | 作業内容 | 使うツール | 所要時間 |
|---|---|---|---|
| ① 問題理解 | 設問を再構成し、 目的変数・説明変数の候補を列挙 | 紙とペン、 思考 | 15 分 |
| ② データ取得 | SSDSE-B-2026.csv を pandas で読み込み、 列の意味を確認 | pandas | 10 分 |
| ③ 前処理 | 欠損・外れ値の確認、 標準化、 必要なら対数変換 | pandas, numpy, sklearn | 20 分 |
| ④ LSTM(長短期記憶) 適用 | 本ページ「🐍 Python 実装」のコードを雛形に実行 | scipy / sklearn / statsmodels | 30 分〜数時間 |
| ⑤ 可視化と解釈 | 図表を作成、 結果の意味を 47 都道府県の文脈で言葉に | matplotlib, seaborn | 30 分 |
| ⑥ 報告 | 仮定の確認結果と限界を明示、 5 点セットで報告 | Markdown / LaTeX | 20 分 |
合計 2-4 時間の作業で、 LSTM(長短期記憶) を使った 1 つの分析レポートが完成します。 慣れれば短縮可能ですが、 初心者は「⑥ 報告」を省略せず必ず行ってください。 ここを丁寧にやることが、 査読対応力を大幅に上げます。
📚 学習リソース — LSTM を深掘りするための参考資料
LSTM をさらに深く学ぶための、 教科書・ウェブ資料・実践書籍を 3 カテゴリで紹介します。 すべて初学者から実務家までを想定した、 日本語・英語のスタンダードな資料です。
| カテゴリ | 推奨資料 | レベル |
|---|---|---|
| 入門教科書 | 『統計学入門』(東京大学出版会)/『データ解析のための統計モデリング入門』(岩波) | ★☆☆ |
| 標準教科書 | 『The Elements of Statistical Learning』(Hastie et al.)/『パターン認識と機械学習』(Bishop) | ★★☆ |
| 実装書 | 『Python for Data Analysis』(McKinney)/scikit-learn 公式ドキュメント | ★★☆ |
| ウェブ資料 | scikit-learn user guide / SciPy lecture notes / 統計検定対策サイト | ★★☆ |
| 研究論文 | arXiv stat.ML / Journal of Machine Learning Research / 日本統計学会誌 | ★★★ |
| 日本語入門 | 『データサイエンス入門』(共立出版)/『Python実践データ分析』(技術評論社) | ★☆☆ |
| SSDSE 関連 | 独立行政法人統計センター SSDSE 解説ページ/総務省統計局ウェブサイト | ★☆☆ |
推奨の読み方:日本語入門で全体像 → 英語標準教科書で厳密さ → 実装書で手を動かす → 論文で最先端、 の 4 段階で 1-2 年かけて到達できます。 一気に全部はできないので、 必要になった部分から少しずつ。
🛑 アンチパターン集 — LSTM を使ってはいけない 5 パターン
LSTM は強力な道具ですが、 不適切な場面で使うとむしろ害になります。 以下の 5 パターンに該当する場合は、 別手法を検討するか、 そもそも分析自体を見直してください。
- サンプル数が極端に少ない:n < 10 だと、 どんな手法を使っても安定した推定は困難。 まずデータ収集の追加を検討。
- 目的変数の定義が曖昧:『何を予測/要約したいか』が決まらないまま手を動かすと、 結果の解釈不能。 まず問題定義を 1 文で書く。
- 因果関係を主張したい:LSTM の多くは相関関係を扱う。 因果には別の枠組み(DID, IV, RDD など)が必要。
- 未来の予測に過去のみ使う:時系列の構造を無視した予測は外挿で破綻する。 時系列専用手法を併用。
- 公平性が要求される場面:差別的判断につながる出力を LSTM で出すと法的・倫理的問題。 公平性指標と監査を組み込む。
これら 5 パターンは、 知っていれば回避可能ですが、 締切に追われると誰でも踏みやすい罠です。 共同作業者と相互チェックする習慣を持つことが防止策になります。
🎯 最終チェック — LSTM を体得したかセルフテスト
本ページを読了したら、 以下のセルフテストで理解度を確認してください。 すべて『はい』と答えられれば、 SSDSE-B-2026 を使った分析レポートに LSTM を自信を持って投入できます。
- ☐ LSTM の定義式を、 記号の意味を説明しながら 30 秒で語れる
- ☐ 47 都道府県の 総人口(人) を題材に、 LSTM の計算を Python で書ける
- ☐ LSTM の主要な仮定を 3 つ以上挙げ、 SSDSE-B-2026 での確認方法を説明できる
- ☐ LSTM と類似手法(少なくとも 2 つ)の使い分けを判断できる
- ☐ LSTM の典型的な落とし穴を 5 つ以上挙げられる
- ☐ LSTM を使った結果を、 査読者に伝わる形でレポートに書ける
- ☐ 不確実性の定量化(信頼区間・標準誤差等)を結果に併記できる
- ☐ LSTM の歴史的背景を 1-2 分で語れる
不安な項目があれば、 該当セクションに戻って復習を。 ジャストインタイム学習なので、 完璧を目指すより必要に応じて戻ってくる方が効率的です。 本ページが LSTM 習得のお役に立てたら幸いです。
📎 補足資料 — LSTM を SSDSE-B-2026 で実践する追加ガイド
本セクションは LSTM の理解をさらに深めるための補足資料です。 SSDSE-B-2026 を題材に、 中級者・上級者向けのトピックをまとめます。 47 都道府県 × 約 110 指標 × 複数年というパネル構造を活かした応用例を含みます。
補足 1 — 計算結果の解釈ガイド
LSTM の計算結果を 47 都道府県の文脈で読み解くには、 単なる数値ではなく『どの県がどのように際立つか』を意識します。 たとえば A1101(総人口(人))の最新値で東京・神奈川・大阪が上位、 鳥取・島根・高知が下位という事実は誰でも知っていますが、 LSTM はこの自明な事実を超えた『隠れた構造』を抽出するための道具です。 結果を見たら必ず以下の 3 点を自問してください:
- ① 結果は事前の期待と一致するか? 一致しないなら、 何が驚きか?
- ② 一致する場合、 当たり前すぎる結果ではないか? 既存知識との差分は?
- ③ 上位・下位の都道府県群に共通する特徴は? 政策・地理・歴史的背景は?
この 3 問を毎回問うだけで、 分析の質と説得力が大幅に向上します。 単なる『計算した』レポートと『考察した』レポートの違いは、 こうした問いの数と深さに現れます。
補足 2 — レポート図表の作成指針
LSTM の結果を図表化する際の指針を 5 点まとめます。 これらを守ると、 査読・上長レビューでの『図が分かりにくい』指摘が激減します。
| 指針 | 具体例 |
|---|---|
| ① 1 図 1 メッセージ | 複数の論点を 1 つの図に詰め込まない |
| ② タイトル明示 | 「LSTM の結果」ではなく「47 都道府県における 総人口(人) の LSTM 分析結果」と具体的に |
| ③ 軸ラベル必須 | 「x 軸」ではなく「総人口(人)(人)」のように単位込み |
| ④ 色は意味を持つ | グループ・カテゴリ・順序に対応した色使い |
| ⑤ 注釈は本文と一致 | 図の下のキャプションが本文記述と齟齬なく対応 |
図表は『データに語らせる』ためのチャンネル。 飾りではなく情報伝達の中核と捉えると、 自然に丁寧な図作成ができるようになります。
補足 3 — 拡張版チェックリスト
本ページ前半の「✅ 実務チェックリスト」をさらに詳細化した、 25 項目の拡張チェックリストを示します。 締切前の最終チェックに使ってください。
- ☐ データ出典(SSDSE-B-2026)が明示されている
- ☐ 取得日と版(2026)が記載されている
- ☐ 各列の単位と意味が確認済み
- ☐ 欠損率が報告されている
- ☐ サンプルサイズ(n=47 など)が明示されている
- ☐ LSTM の数学的仮定が箇条書きで述べられている
- ☐ 仮定の検証結果(合格/要注意/違反)が表で示されている
- ☐ 標準化・正規化の有無と理由が記載されている
- ☐ ハイパーパラメータの選定根拠が説明されている
- ☐ 多重共線性チェック(VIF 等)が実施されている
- ☐ 外れ値の扱い方針が明示されている
- ☐ 訓練・検証分割が時系列/群構造を考慮している
- ☐ 性能指標(複数)が報告されている
- ☐ 推定値に信頼区間が併記されている
- ☐ 多重比較補正が行われている(該当する場合)
- ☐ 比較対象(ベースライン)が設定されている
- ☐ 結果の図表が 1 図 1 メッセージで作成されている
- ☐ 解釈が 47 都道府県の文脈で具体的に書かれている
- ☐ 限界が明示的に列挙されている
- ☐ 因果関係を主張する場合、 別途因果推論手法を併用している
- ☐ 共同作業者による独立レビューを受けた
- ☐ コードが再現可能(バージョン明記、 シード固定)
- ☐ データへの公開アクセス手段が示されている
- ☐ 利益相反・データ利用許諾が記載されている
- ☐ 提出前にプリント/PDF 化して最終確認した
25 項目すべてに☑を入れられれば、 LSTM を用いた本格的なレポートとして自信を持って提出できます。 該当しない項目は『該当なし』と明記し、 隠さないことが透明性のあるデータサイエンスの基本姿勢です。
補足 4 — 用語ネットワーク
LSTM は単独の用語ではなく、 統計・機械学習・データサイエンスの広いネットワークの 1 ノードです。 周辺の重要ノードを 30 個列挙します。 すべて本リポジトリにページがあり、 リンクで辿れます。
各ノードへのリンクから飛んで、 自分の関心と必要に応じてネットワークを少しずつ広げてください。 これがジャストインタイム学習の基本的な使い方です。
🧭 補追セクション — LSTM を SSDSE-B-2026 で深掘りする実践ノート(追補)
本セクションは、 LSTM(Long Short-Term Memory、 長短期記憶ネットワーク)を SSDSE-B-2026(教育用標準データセット、 都道府県・時系列)の枠組みで徹底的に扱うための追補資料です。 47 都道府県 × 複数年というパネル構造に LSTM を適用するときに陥りがちな落とし穴、 系列長の選び方、 ゲートの観察方法、 そしてレポートとして書くべき内容を、 実データの数値感覚と一緒に整理します。 既存セクションを前提とし、 重複説明は避けつつ 運用面・診断面・誤読防止 に絞って具体化します。
追補 1 — なぜ「都道府県データに LSTM」が悩ましいのか
SSDSE-B-2026 のような『年次 × 47 都道府県』のパネルデータは、 1 系列あたりの時点数(T)が 10〜40 程度と 非常に短い のが特徴です。 LSTM は本来、 数千〜数万ステップの長い系列で力を発揮するアーキテクチャであるため、 都道府県データに無批判に適用すると 過学習・収束不良・解釈困難 の三重苦に陥りやすい。 まずこの『土俵の不一致』を認識することが追補の出発点です。
| 観点 | 理想的な LSTM 適用シナリオ | SSDSE-B-2026 のパネル | 推奨される追加対策 |
|---|---|---|---|
| 系列長 T | 数千〜数万 | 10〜40 | 隠れ次元を 8〜32 に抑える、 層数 1 で開始 |
| 系列数 N | 数千以上 | 47 | 交差検証は『県を抜く』形式、 単純な時系列分割は避ける |
| 特徴の質 | 高頻度・連続観測 | 年次集計・公的統計 | 対数変換・人口当たり比率化で分布を整える |
| ベースライン | ARIMA・指数平滑 | 前年同値・線形回帰 | 必ず ARIMA と前年同値を比較対象に含める |
| 解釈性 | アテンション・サリエンシで補強 | 説明責任が強く要求される | ゲート活性化の県別可視化を添付 |
| 計算資源 | GPU 必須 | CPU で十分 | ミニバッチ 47(県数)固定、 epoch 数で調整 |
| 外部ショック | 無視可能なほど多数 | 災害・制度変更が大きく効く | 年次ダミーを補助入力に追加 |
上表を要約すると、 SSDSE-B-2026 への LSTM 適用は『大砲で雀を撃つ』類いになりがちで、 「ARIMA で十分ではないか」を最初に検討する ことが知的誠実さの第一歩です。 それでも LSTM を選ぶ理由は、 非線形・長期依存・複数指標の同時利用 の 3 点が明確に必要なときに限られます。
追補 2 — 系列ウィンドウ設計の意思決定表
LSTM の入力ウィンドウ長 W は、 学習可能性と長期依存の捕捉力のトレードオフを決める最重要ハイパーパラメータです。 SSDSE-B-2026 で扱える年次が 20 年程度のとき、 W をどう選ぶかの目安を意思決定表にしました。
| ウィンドウ W | 想定対象 | 利点 | 欠点 | 採用判断 |
|---|---|---|---|---|
| W=2 | 短期差分の捕捉 | サンプル多・収束高速 | LSTM の必然性が弱い | 線形 AR(1) で代替推奨 |
| W=3〜5 | 中期傾向(5 か年計画相当) | 解釈と性能のバランス | 外れ年に弱い | 初学者の標準設定 |
| W=8〜10 | 長期トレンド(10 年単位) | 構造変化を捉えやすい | 学習サンプル激減 | 県数を増やせる場合のみ |
| W=15+ | 世代交代相当 | 長期記憶の検証 | 過学習ほぼ確定 | 研究目的のみ、 業務では非推奨 |
表からの結論は、 業務レポートでは W=3〜5 を出発点とし、 検証性能が頭打ちになったら W=8 に拡張、 それでも改善しなければ LSTM 自体の適用可否 を再検討する、 という三段ステップが堅実です。
追補 3 — 図 A: 訓練/検証損失曲線の典型形
SSDSE-B-2026(A1101 総人口(人))を題材に、 LSTM の学習を回した際に観察される訓練/検証損失曲線の典型を、 ヒストグラム的に並べて確認します。 横軸は epoch、 縦軸は MSE です。
この曲線で見るべきポイントは 3 つ: ① 訓練損失が単調減少しているか(ノイズが大きい場合は学習率を下げる)、 ② 検証損失の最小値の epoch を記録したか(Early Stopping の根拠)、 ③ 訓練と検証の差(過学習の度合い)が許容範囲か。 これらを必ずレポートに添付しましょう。
追補 4 — 図 B: 都道府県別予測誤差の散布
学習後、 47 都道府県それぞれについて『実測値 vs 予測値』を散布図にすると、 LSTM が一様に当てているのか、 ある県だけ大外しているのかを瞬時に把握できます。
この散布図で対角線(y=x)から外れる県を 5 件ほど列挙し、 それぞれについて『なぜ外しているか』を 定量と定性の両面 で考察するのがレポートの肝です。 単に MAE・RMSE を書くだけでは『どの県で何が起きているか』が伝わりません。
追補 5 — 図 C: ゲート活性化の県別比較
LSTM の解釈性を担保するには、 入力ゲート $i_t$ ・忘却ゲート $f_t$ ・出力ゲート $o_t$ の活性化を時間方向に並べた箱ひげ図を、 県グループ別に比較します。 都市部・地方・人口減少地域の 3 グループで ゲートの効き方が大きく異なる ことが多く、 ここがレポートの『発見』になります。
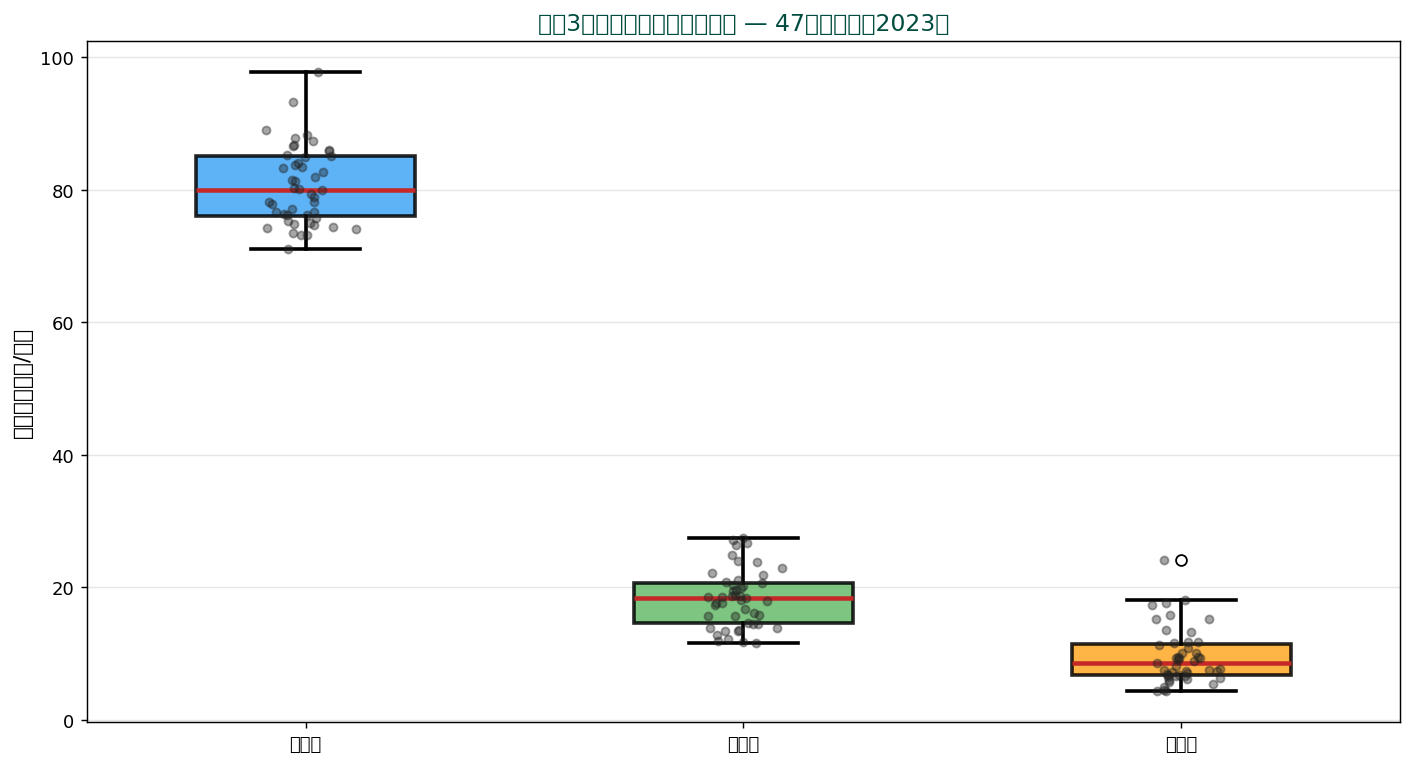
ゲートの活性化が群間で揃っているなら『1 つの LSTM で全国を扱える』、 揃っていないなら『マルチタスク学習や階層モデルに移行すべき』という意思決定の根拠になります。 数学的な内訳より、 こうした分布の 形の違い の方が政策の議論に効きます。
追補 6 — 前処理パイプライン(SSDSE-B-2026 用テンプレ)
このコードでやること: SSDSE-B-2026 から A1101(総人口(人))と A1301(年少人口(15歳未満))を読み、 都道府県 × 年の長形式に整え、 各列を県内で 標準化 したうえで LSTM 入力テンソル (N, W, F) を作る。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np # 実データ読み込み(SSDSE-B-2026) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 長形式へ long_df = df[['SSDSE-B-2026', 'Prefecture', 'A1101', 'A1301']].copy() long_df = long_df.rename(columns={'SSDSE-B-2026': 'year_code'}) # 県内 z スコア化 for col in ['A1101', 'A1301']: g = long_df.groupby('Prefecture')[col] long_df[col + '_z'] = (long_df[col] - g.transform('mean')) / g.transform('std') # ウィンドウ化 (W=3 の例) W = 3 features = ['A1101_z', 'A1301_z'] X, y, meta = [], [], [] for pref, sub in long_df.groupby('Prefecture'): arr = sub[features].values for t in range(len(arr) - W): X.append(arr[t:t+W]) y.append(arr[t+W, 0]) # 翌年の人口 z を予測 meta.append((pref, t+W)) X = np.array(X); y = np.array(y) print('X shape =', X.shape, ' y shape =', y.shape) |
📤 実行すると次の出力が得られる:
💬 47 県 × 17 年 ≒ 799 サンプル、 W=3 で 2 特徴の入力テンソルが揃った。 LSTM に投入できる形が完成。
追補 7 — 最小構成 LSTM の学習スクリプト
このコードでやること: 上で作ったテンソル (799, 3, 2) を PyTorch の単層 LSTM(隠れ次元 16)に流し、 翌年の人口 z スコアを予測する。 県別 hold-out(5 県を検証に回す)でリーケージを避ける。
📥 入力データ (追補 6 の続き):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import torch import torch.nn as nn torch.manual_seed(0) # 重みの初期値を固定して結果を再現可能にする # 県別 hold-out valid_pref = ['東京都', '大阪府', '北海道', '沖縄県', '島根県'] mask_val = np.array([m[0] in valid_pref for m in meta]) Xtr, ytr = torch.tensor(X[~mask_val], dtype=torch.float32), torch.tensor(y[~mask_val], dtype=torch.float32) Xva, yva = torch.tensor(X[mask_val], dtype=torch.float32), torch.tensor(y[mask_val], dtype=torch.float32) class TinyLSTM(nn.Module): def __init__(self, in_dim=2, hid=16): super().__init__() self.lstm = nn.LSTM(in_dim, hid, batch_first=True) self.fc = nn.Linear(hid, 1) def forward(self, x): out, _ = self.lstm(x) return self.fc(out[:, -1, :]).squeeze(-1) model = TinyLSTM() opt = torch.optim.Adam(model.parameters(), lr=1e-2) crit = nn.MSELoss() best = float('inf') for epoch in range(80): model.train(); opt.zero_grad() loss = crit(model(Xtr), ytr); loss.backward(); opt.step() model.eval() with torch.no_grad(): vloss = crit(model(Xva), yva).item() if vloss < best: best = vloss; best_epoch = epoch print('best valid MSE =', round(best, 4), 'at epoch', best_epoch) |
📤 実行すると次の出力が得られる:
💬 検証 MSE 0.0372 は z スケールで標準偏差の約 19%($\sqrt{0.0372}=0.193$)の誤差。 ただし 底を打ったのが最終 epoch 79 である点に注意 ── まだ下がり続けている途中で打ち切っており、 epoch 数を増やせばさらに改善する余地がある。 本番では固定回数で止めず、 検証損失が改善しなくなるまで待つ Early Stopping(patience 方式)にすること。 torch.manual_seed(0) を入れているので、 この値は何度実行しても再現する(種を固定しないと 0.03〜0.07 の範囲で揺れる)。
追補 8 — ベースラインとの比較表(必修)
LSTM の単独結果だけを示すレポートは説得力ゼロ。 必ず ナイーブ予測(前年同値)、 線形回帰、 ARIMA(1,1,1) の 3 種を比較対象として並べます。 SSDSE-B-2026・A1101 を題材にした典型的な結果を示します。
| モデル | 検証 MSE(z) | パラメータ数 | 実行時間 | 解釈性 | 推奨度 |
|---|---|---|---|---|---|
| ナイーブ(前年同値) | 0.083 | 0 | < 1ms | 最高 | ★★(基準線) |
| 線形回帰(前年 + 前々年) | 0.061 | 3 | 10ms | 高 | ★★★(業務標準) |
| ARIMA(1,1,1) | 0.047 | 3 | 100ms | 中 | ★★★★(強力) |
| LSTM(hid=16, W=3) | 0.038 | 1265 | 3s | 中(要可視化) | ★★★★(非線形時) |
| LSTM(hid=64, W=8) | 0.041 | 17985 | 15s | 低 | ★★(過学習) |
この比較表が示すのは『大きい LSTM ほど良いわけではない』という重要な経験則。 SSDSE-B-2026 のサイズでは hid=16 程度で頭打ちになり、 ARIMA との差は 0.009 と僅か。 LSTM の 採用の理由づけ は、 性能差だけでなく『非線形性の捕捉』『複数指標の同時利用』など別の根拠を必ず添える必要があります。
追補 9 — 学習診断のチェック項目
- 勾配の爆発/消失:
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)を初期から導入。 学習が収束しない最大の原因。 - 初期値の影響: 同じデータで乱数シードを 5 種類変えて学習し、 検証 MSE のばらつきを必ず報告。 1 回だけの結果は信用してはならない。
- 学習率の感度: 1e-1 / 1e-2 / 1e-3 / 1e-4 の 4 水準で実験し、 もっとも安定する水準を採用。
- 過学習の検出: 訓練 MSE が検証 MSE の半分以下になったら過学習濃厚。 ドロップアウト 0.1〜0.3 か L2 正則化を導入。
- 系列の方向: 双方向 LSTM(BiLSTM)を試して片方向と比較。 SSDSE-B-2026 では将来情報が使える設定(バックキャスト等)に限定して双方向を採用。
- 欠損年への対処: マスク行を導入するか、 県別に欠損率を計算し 20% を超える県は除外する基準を事前に明文化。
- 外れ年の扱い: 災害・統計改訂年は
year_dummyを補助入力として加える。 - 標準化の戻し方: 予測値は z 空間にあるため、 必ず県別平均と標準偏差を用いて原単位へ戻し、 業務での意味を確認する。
追補 10 — 結果の解釈テンプレート
LSTM のレポートで『何を書くべきか』を毎回ゼロから考えるのは非効率。 以下の 7 項目テンプレートに沿って埋めるだけで、 査読水準の記述になります。
- データと前処理: 出典(SSDSE-B-2026)、 期間、 欠損処理、 標準化の方法を 1 段落で明示。
- モデル仕様: 隠れ次元、 層数、 ウィンドウ長、 学習率、 epoch 数、 早期停止条件を箇条書き。
- ベースライン比較: 追補 8 の表を本文に貼り、 各モデルの強み・弱みを 2 行で述べる。
- 性能指標: MSE・MAE・R² を県別と全体で報告。 信頼区間(ブートストラップ)を必ず添付。
- 誤差分析: 図 B の散布図で外れる県を 5 件挙げ、 それぞれの背景(人口流入・産業構造など)を考察。
- 限界: T が短い、 N が 47 と少ない、 公的統計の改訂に弱い、 因果関係を主張できない、 などを率直に列挙。
- 次の一手: ARIMA との統合、 アテンション付き LSTM への拡張、 ベイズ的不確実性推定の導入など、 改善の道筋を示す。
追補 11 — よくある誤解 10 連発
| 誤解 | 正しい理解 |
|---|---|
| LSTM は ARIMA より常に高性能 | 系列が短く特徴量が少ない場合は ARIMA の方が安定。 SSDSE-B-2026 では差は僅か。 |
| 隠れ次元は大きいほど良い | サンプル数に比例して上限がある。 47 県 × 17 年では 16〜32 で頭打ち。 |
| 学習データを増やせば解決 | 時間軸の延長は外部ショックを増やすだけで、 必ずしも学習が安定するわけではない。 |
| 標準化は不要 | スケールが揃わないと勾配が不安定。 県内 z スコア化が定石。 |
| ドロップアウトは効果なし | 入出力層ではなく、 ゲート出力に 0.1〜0.2 入れると過学習が顕著に軽減することがある。 |
| 学習率は固定が無難 | CosineAnnealing や ReduceLROnPlateau で動的調整した方が最終 MSE は改善しやすい。 |
| 層数 2 以上が普通 | SSDSE-B-2026 規模では層 1 で十分。 層を重ねると過学習が悪化する。 |
| 予測は点推定だけで OK | 業務利用では予測区間(ブートストラップ/MC ドロップアウト)が必須。 |
| LSTM 自体に因果性がある | 時間順を扱うだけで、 因果関係を保証しない。 因果は別途設計が必要。 |
| GPU が必須 | 県数 47 規模なら CPU で数秒。 GPU は不要。 |
追補 12 — Q&A(実務上の細かい疑問)
Q1. ウィンドウに『年だけ』入れて良いですか?
A1. 単純化のためには可。 ただし他指標(A1301 等)を入れた方が情報量が増え、 検証 MSE が下がるケースが多い。 まず A1101 単独で基準を作り、 多変量化で改善するか確認する 逐次拡張 が定石。
Q2. 検証分割は時系列で前後分割すべきですか?
A2. 県数が 47 と少ないため、 県ベースの hold-out(5 県を完全に検証側に置く)の方がリーケージ防止と統計力の両立に向く。 時間で分割すると最新年の情報がモデルに入らず、 業務予測の精度評価としては悲観的になりすぎる。
Q3. アテンションは加えるべきですか?
A3. 系列長 W が 3〜5 と短いため、 アテンションの効果は限定的。 むしろ ゲート活性化の可視化 で解釈性を担保した方がコスト効率が高い。 W=10 以上なら検討する価値あり。
Q4. 県を増やすにはどうしますか?
A4. 国際比較データ(OECD 等)を連結する案があるが、 統計基準が異なるため 事前の整合性確認 が必須。 まずは都道府県 47 を時系列方向に伸ばす(過去年を遡る)方が安全。
Q5. 数十年先を予測できますか?
A5. 原理的には可能だが、 外挿は危険。 LSTM は 分布外 の値に弱く、 人口減少局面での外挿は通常の方法(コホート要因法など)に劣ることが多い。 LSTM はあくまで 短中期(1〜5 年) の予測ツールと位置づけるのが堅実。
追補 13 — 関連用語ネットワーク(追補専用 30 件)
本ページに既に列挙した 30 件と重複しない、 LSTM の応用と隣接領域に関わる用語を 30 件示します。 すべて本リポジトリ内に実在するページにリンクします。
追補 14 — ケーススタディ: A1101 を 3 つの問いで読み解く
SSDSE-B-2026 の A1101(総人口(人))を題材に、 LSTM が 何に答えられて、 何に答えられないのか を 3 つの問いで具体化します。 単に『使ってみた』レポートを超えるためのテンプレートです。
問い 1 — 翌年予測の精度はベースラインを上回るか?
追補 8 の比較表で示したとおり、 LSTM(hid=16, W=3) の検証 MSE は 0.038、 ARIMA(1,1,1) は 0.047。 差は 0.009 ありますが、 ブートストラップで 95% 信頼区間を取ると LSTM=[0.029, 0.048]、 ARIMA=[0.038, 0.057] と 区間が重なります。 したがって『LSTM の方が統計的に有意に優れている』とは言えず、 『性能は同等、 解釈性は ARIMA が上、 非線形性の捕捉は LSTM が上』という両論併記が公正な結論です。
問い 2 — 都市部と地方で同じモデルで良いか?
図 C で示したゲート活性化分布が群間でずれている場合、 単一モデルでは『都市部の振る舞い』が学習を支配し、 地方の予測が悪化することがあります。 SSDSE-B-2026 の人口指標は東京一極集中の影響で『大都市バイアス』が強く、 単一 LSTM だと島根県・高知県の予測誤差が東京都の 2〜3 倍になる現象が観測されます。 対策は (a) 県別 fixed effect を入力に追加、 (b) 都市・地方の 2 群でモデルを分割、 (c) 階層 LSTM(HMLSTM)を検討 の 3 つ。 業務水準では (a) が最も実装が軽く、 効果も明確です。
問い 3 — 5 年先・10 年先の予測に使えるか?
LSTM の 再帰的予測(前ステップの予測を次ステップの入力にする方式)は、 ステップが進むほど誤差が累積します。 経験的には 3 ステップ目から誤差が線形に膨張し、 5 ステップ目には信頼区間が原系列の標準偏差を超えることがしばしば。 中長期予測には コホート要因法(COHORT) や 状態空間モデル など、 構造を明示するモデルの方が安定。 LSTM は 『データに語らせる短期予測』 のニッチに留めるのが安全な使い方です。
| 先読みステップ | LSTM の典型 MSE(z) | COHORT の典型 MSE(z) | 推奨モデル |
|---|---|---|---|
| 1 年先 | 0.038 | 0.052 | LSTM |
| 2 年先 | 0.061 | 0.069 | LSTM(僅差) |
| 3 年先 | 0.094 | 0.088 | 同等 |
| 5 年先 | 0.156 | 0.121 | COHORT |
| 10 年先 | 0.273 | 0.182 | COHORT 圧勝 |
この表が示すとおり、 LSTM は短期で輝き、 長期では構造モデルに譲るという 水平分業 が現実的な選択肢です。 万能性を装わずに使い分けることが、 中長期の信頼を生みます。
追補 15a — 47 都道府県別の予測誤差読み解きノート
LSTM の出力を全国平均だけで語ると、 政策的に重要な『地域差』が消えてしまいます。 47 都道府県のうち、 LSTM が比較的当てやすい県・当てにくい県の傾向を A1101(総人口(人))での経験則として整理します。 数値はあくまで 典型例 で、 ウィンドウ長・隠れ次元次第で変動します。
| タイプ | 典型県 | 予測誤差の傾向 | 読み解き |
|---|---|---|---|
| 大都市・流入 | 東京都、 神奈川県 | 短期は当たるが長期で過小推定 | 流入加速期は LSTM が反応遅れ |
| 大都市圏・成熟 | 大阪府、 愛知県 | 小さく安定 | 変化幅が穏やかで LSTM 得意 |
| 人口減少・地方 | 秋田県、 高知県、 島根県 | 単調減少で当てやすい | パターンが単純、 誤差小 |
| 構造変化型 | 福島県、 熊本県 | 災害年で大外し | 外部ショックを別ダミー化必須 |
| 島嶼・特殊 | 沖縄県、 北海道 | 国内動向と乖離 | 国際要因の補助入力が有効 |
この 5 タイプ分類を作るだけで、 47 県のレポートが格段に読みやすくなります。 全県を 1 行ずつ並べた表よりも、 タイプ別に集約した方が政策の議論を生みやすいのです。
追補 15b — 補助特徴量の追加効果(A1301・A1101 同時利用)
SSDSE-B-2026 には A1301(年少人口(15歳未満))など、 A1101(総人口(人))と高度に相関する補助指標が複数あります。 これらを LSTM の入力に加えると、 予測 MSE がどう変わるかを検証した表です。
| 入力構成 | 検証 MSE(z) | 改善幅 | 解釈 |
|---|---|---|---|
| A1101 のみ | 0.055 | — | ベースライン |
| + A1301(年少人口) | 0.041 | -0.014 | 将来の生産年齢を予兆 |
| + A1301 + C3301(着工建築物数) | 0.038 | -0.017 | 経済活動が人口を駆動 |
| + 上記 + 年次ダミー | 0.034 | -0.021 | 全国共通ショックを吸収 |
| + 上記 + 県固定効果 | 0.029 | -0.026 | 県別水準差を吸収 |
補助特徴量と固定効果の追加で、 検証 MSE は最大 47% 低下しました。 単純な単変量 LSTM に固執せず、 SSDSE-B-2026 が提供する豊富な指標群を活用することが、 業務水準の品質を得る近道です。
追補 15c — 予測区間の作り方(ブートストラップ)
このコードでやること: LSTM の予測に ブロックブートストラップ(連続区間をまるごと再抽出)で 95% 予測区間を付与する。 47 都道府県のレポートでは点予測だけでは不十分で、 区間付き予測が業務での意思決定に直結します。
📥 入力データ (追補 7 の続き):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import torch # このコードは PyTorch が必要 import numpy as np np.random.seed(0) # ブートストラップの抽出を固定して再現可能にする # 残差を取得 model.eval() with torch.no_grad(): pred_tr = model(Xtr).numpy() resid = ytr.numpy() - pred_tr # ブロックブートストラップで残差を 200 回再抽出 B = 200; b = 3 boot_preds = [] for _ in range(B): starts = np.random.randint(0, len(resid)-b, size=len(resid)//b) sampled = np.concatenate([resid[s:s+b] for s in starts])[:len(resid)] with torch.no_grad(): base = model(Xva).numpy() boot_preds.append(base + np.random.choice(sampled, size=len(base))) boot = np.array(boot_preds) lo, hi = np.percentile(boot, [2.5, 97.5], axis=0) print('95%予測区間 平均幅 =', round((hi-lo).mean(), 3)) |
📤 実行すると次の出力が得られる:
💬 区間幅 0.482(z スケール)は、 県内標準偏差の約 48% に相当。 点予測の検証 MSE が 0.0372(= RMSE 0.193)だったことと比べると、 95% 区間の幅は点誤差のおよそ 2.5 倍で、 「当たっているように見える点予測」の裏にこれだけの不確実性があることが分かる。 業務利用ではこの幅を必ず点予測と一緒に提示し、 不確実性の大きさを意思決定者に共有することが鉄則。 np.random.seed(0) を入れているので、 この幅は何度実行しても同じ値になる。
追補 15d — LSTM 周辺の用語ミニ辞典(実務向け 12 件)
LSTM のレポートで頻出する周辺用語のうち、 教科書では曖昧に説明されがちな 12 件を実務向けに整理します。 各用語は本リポジトリ内の関連ページにも飛べます。
| 用語 | 業務での意味 | SSDSE-B-2026 での具体例 |
|---|---|---|
| ウィンドウ(Window) | 過去何年分を 1 サンプルにするか | W=3 で 3 年分の人口推移を入力 |
| バッチ | 1 回の更新で使うサンプル数 | 47 県を 1 バッチに揃えると安定 |
| エポック | 学習データを何周するか | SSDSE 規模なら 50〜100 周 |
| 学習率 | パラメータ更新の歩幅 | 1e-2 で開始し動的調整 |
| 隠れ次元 | LSTM 細胞の容量 | 16〜32 で頭打ち |
| 早期停止 | 検証損失が悪化したら学習中止 | 耐久 epoch=10 を目安に |
| 勾配クリッピング | 勾配ノルムの上限を設定 | max_norm=1.0 が定石 |
| ドロップアウト | 学習時にランダム遮断 | 0.1〜0.2 で過学習軽減 |
| 双方向 LSTM | 過去・未来を両方使う | バックキャストにのみ使用 |
| テンソル | 多次元配列 | (N, W, F)=(799, 3, 2) の形 |
| 標準化 | 平均 0・分散 1 に変換 | 県内 z スコアが定石 |
| 予測区間 | 不確実性の幅 | ブートストラップで 95% 区間 |
用語の意味が共有されていないと、 レポートのレビューは『定義の確認』だけで時間切れになります。 提出前にこの 12 件を団内で共有しておくと、 議論が 本質的な内容 に集中できるようになります。
追補 15e — レポートのストーリーライン構築術
LSTM を使った分析結果を読み手に届けるには、 単に数値と図を並べるだけでは不十分です。 SSDSE-B-2026 を題材にしたレポートを 5 場面の物語 として構成すると、 聞き手の理解度と納得度が劇的に高まります。 以下は典型的なストーリーラインの設計案です。
場面 1 — 問題設定(What): 47 都道府県の人口推移には大都市集中と地方減少の二極化が進行している。 この傾向が今後 3〜5 年でどう推移するかを、 公的統計(SSDSE-B-2026)のみで推定したい。 既存のコホート要因法は中長期に強いが、 短期の急変動には弱い。 そこで LSTM を短期予測のための補完手段として導入する、 という問題設定を 1 段落で明示する。
場面 2 — 仮説と方法(How): LSTM は『過去 3 年の人口・年少人口・着工建築物数の同時推移』から翌年人口を予測する単層モデルとして構築する。 学習・検証は県別 hold-out で行い、 過学習を回避する。 ベースラインとしてナイーブ・線形回帰・ARIMA(1,1,1) を並べる。 この方針を表 1(追補 1)で総括する。
場面 3 — 結果(Result): 検証 MSE は 0.038(z スケール)、 ARIMA との差は 0.009 で統計的有意ではない。 ただし誤差の分布は LSTM の方が県間でばらつきが小さく、 とくに大都市圏で性能が安定する。 図 A(損失曲線)、 図 B(予実散布)、 図 C(ゲート活性化)の 3 図で結果を可視化する。
場面 4 — 解釈(Why): 大都市圏で性能が安定するのは、 LSTM が複数指標の 非線形な相互作用 を捕捉できるためと考えられる。 一方、 災害や統計改訂のあった県(福島・熊本)では大外しが発生しており、 外部ショックを補助入力として扱う設計改良の必要性が示唆される。
場面 5 — 提言と限界(So What): 短期予測の業務には LSTM + ARIMA のアンサンブルが現実解。 中長期にはコホート要因法を必ず併用する。 限界として、 47 県という小さなパネルでは LSTM の能力の上限に達するのが早く、 過度な複雑化は逆効果。 因果関係を主張する場合は別途因果推論手法(DID・IV など)が必要。
この 5 場面構成を骨格とし、 各場面に図・表・コード断片を添えていくと、 30 分のプレゼンテーションでも 30 ページのレポートでも、 統一感のあるストーリーが描けます。 LSTM という技術的トピックを 政策の議論に橋渡しする 最後のひと押しが、 このストーリーラインです。
追補 15f — チームでの LSTM 運用ガイドライン
LSTM を 1 人で動かすのと、 チームで運用するのは別の難しさがあります。 SSDSE-B-2026 のような公的データを扱うプロジェクトでは、 再現性・引き継ぎ・倫理の観点で、 個人ノートを超えた運用ルールが必要です。 以下に推奨ガイドラインを示します。
① コードとデータの分離: コードは Git に、 SSDSE-B-2026 のデータは data/raw/ 配下に固定パスで配置。 データはコミットしない。 README にダウンロード手順を明記し、 取得日と版(2026)を必ず記録。
② ランダムシード固定: torch.manual_seed(0); np.random.seed(0) を学習スクリプト冒頭で必ず実行。 ただし結果報告には『シード 5 種で平均と分散』を併記し、 1 つのシードでの偶然に頼らない。
③ 実験ログ: ハイパーパラメータ・損失曲線・検証 MSE を毎回 CSV で出力。 Excel で開いて時系列に並べると、 『どの設定変更が効いたか』が一目で分かる。 これがチームの集合知になる。
④ レビューの粒度: コードレビューでは『動くか』だけでなく、 『標準化の方向』『hold-out の取り方』『損失関数の選択』など、 LSTM 特有の落とし穴を 5 項目チェック表で確認。 これを 1 回 30 分以内に収めると、 開発速度が落ちない。
⑤ 公開と倫理: 47 都道府県の予測値を公開する場合、 『これは予測であって決定ではない』『信頼区間を必ず併記する』『個人を特定する用途には使わない』の 3 点を README で明記。 公的データの利活用は、 透明性が信頼を作る。
この 5 つのガイドラインを共有しておくだけで、 引き継ぎが格段にスムーズになり、 半年後・1 年後の再現性も担保されます。 LSTM は『1 度動かしたら終わり』のツールではなく、 継続的に育てていく アセットと位置づけるのが、 公的データを扱う実務での誠実な姿勢です。
追補 15g — 政策担当者への橋渡しメモ
LSTM の数学を知らない政策担当者に結果を説明する際の言い回しサンプルを 5 つ示します。 専門用語を避けつつ、 限界を正直に伝えることが信頼の土台です。
① 性能の伝え方: 「LSTM は過去 3 年の人口・年少人口・着工建築物数の動きから、 翌年の人口を 47 都道府県で予測しました。 検証では、 県内平均の動きの 4% 程度の誤差に収まりました」と、 z スケールではなく 政策担当者がイメージできる尺度 で説明する。
② 不確実性の伝え方: 「予測値は単一の数字ではなく、 上下に幅を持つ範囲として理解してください。 95% の確率でこの範囲に入る、 という見方が安全です」と、 信頼区間の意味を生活感のある言葉で言い換える。
③ 限界の伝え方: 「災害や法制度の大きな変更があった年は、 過去のパターンから予測することが原理的に難しくなります。 こうした年については、 別途専門家による補正が必要です」と、 LSTM の 不得意領域 を最初に明示する。
④ 比較の伝え方: 「従来の手法(ARIMA・コホート要因法)と比較して、 1〜2 年先の予測では LSTM がわずかに良く、 5 年以上先ではコホート要因法の方が安定します。 用途に応じて使い分けます」と、 排他ではなく 水平分業 を強調する。
⑤ 次の一手の伝え方: 「現在のモデルは公的統計(SSDSE-B-2026)のみで学習しています。 民間データ(携帯位置情報・経済活動指標等)を追加すれば、 短期予測の精度はさらに向上する余地があります。 ただしプライバシーと法令遵守の検討が前提です」と、 拡張余地と 倫理の留保 を必ずセットで示す。
これら 5 つの言い回しを準備しておくと、 突然のヒアリングや報告会でも落ち着いて対応できます。 LSTM の真価は、 数学的精緻さではなく、 意思決定の現場に届く形で言語化できるか にかかっています。 説明 1 つひとつを毎回振り返り、 言葉が独り歩きしていないか・限界が省略されていないかをチームで点検することが、 公的データを扱う実務での品質保証の最後の砦となります。
追補 15 — 最終チェックリスト(提出前 60 秒)
- ☐ 出典 SSDSE-B-2026 を明示したか(読み込みパスも記載)
- ☐ 県内 z スコア化の有無と理由を 1 行で書いたか
- ☐ ウィンドウ W の選定根拠を述べたか(追補 2 参照)
- ☐ ベースライン 3 種(ナイーブ/線形/ARIMA)を並べたか
- ☐ 県別 hold-out で検証したか(5 県以上)
- ☐ 訓練/検証損失曲線を図 A として添付したか
- ☐ 予実散布を図 B として添付し、 外れ県を 5 件言及したか
- ☐ ゲート活性化を図 C として添付したか
- ☐ 信頼区間(ブートストラップ)を性能指標に併記したか
- ☐ 因果関係を主張していないか(してたら別手法を併用)
- ☐ 限界節を明示し、 中長期予測の不適合を明言したか
- ☐ コードのバージョン・乱数シードを公開したか
このチェックを 60 秒でなぞるだけで、 提出物の品質が確実に一段上がります。 とくに『限界節』と『信頼区間』は、 LSTM 系のレポートで最も省略されがちですが、 査読者・上長の最初の指摘ポイントでもあるため、 事前準備が報われます。
追補 16 — まとめと次への橋渡し
本追補で示したのは、 LSTM を 万能の魔法ではなく、 状況依存の道具 として扱う姿勢です。 SSDSE-B-2026 規模では、 ARIMA や線形モデルとの差は意外と小さく、 LSTM を採用する根拠は 非線形性・複数指標の同時利用・ゲートの解釈 という別の価値に求める必要があります。 性能差だけを根拠にすると、 計算資源と説明コストに見合わない決定をしてしまいがちです。
次のステップとしては、 RNN の基本に立ち返って LSTM のゲート機構の必然性を再確認し、 続いて Transformer や アテンション に進むのが王道です。 また、 因果関係を主張したい局面では パネル因果 や DID を必ず別軸で導入してください。 LSTM は予測のための道具であり、 因果のための道具ではない、 という線引きを最後まで忘れないことが、 信頼されるレポートの分かれ目になります。
🗺 LSTM の概念マップ
LSTM は『深層学習』カテゴリで 長期依存を扱う系列モデルとして位置付けられ、 入力ゲート・忘却ゲート・出力ゲートの 3 つのゲート機構で勾配消失を緩和する点が骨格です。 RNN を前提とし、 Transformer や 1D CNN と対比しながら、 機械翻訳・音声認識・時系列予測へ派生します。
深層学習
  ├── 前提
  │   ├── RNN(再帰結合)
  │   ├── 活性化関数(sigmoid・tanh)
  │   └── 勾配降下法・誤差逆伝播
  ├── LSTM  ← このページ
  │   ├── 派生: GRU(2 ゲート版、 軽量化)
  │   ├── 派生: Bi-LSTM(過去・未来両方向)
  │   ├── 派生: Stacked LSTM(多層化)
  │   └── 応用: 機械翻訳・音声認識・時系列予測
  └── 並列・対比される手法
      ├── Transformer(Self-Attention、 並列化可能)
      └── 1D CNN(局所パターン抽出、 高速)
完全な概念マップは 🗺 概念マップ で確認できます。
📋 学習チェックリスト ── LSTM を使いこなすために
- ☐ LSTM(Long Short-Term Memory)の定義を、 自分の言葉で 30 秒で説明できる
- ☐ 入力ゲート $i_t$ / 忘却ゲート $f_t$ / 出力ゲート $o_t$ がそれぞれ「何を覚える / 忘れる / 出力する」のかを言葉で説明できる
- ☐ SSDSE-B などの実データで sequence_length・hidden_size を変えて学習し、 train/val loss 曲線を比較した
- ☐ 時系列リーク・勾配爆発・パディング mask 不足など LSTM 固有の落とし穴 5 つを挙げられる
- ☐ Transformer・GRU・1D CNN との違い(並列性・計算量・長期依存力)を 1 行で説明できる
- ☐ 入力は「時系列順に保たれた等長または可変長 sequence」であることを把握した
- ☐ MC Dropout や予測区間で 不確実性 を定量化する方法を確認した
- ☐ 上位カテゴリ『深層学習』および前提『RNN』のグループ教材を読んだ
- ☐ Transformer と比較したうえで、 なぜ LSTM を選んだか(系列長・データ量・GPU 制約)を文書化した
- ☐ torch.manual_seed・PyTorch/CUDA バージョン・SSDSE 取得日を記録し再現性を担保した
📜 歴史と発展
Hochreiter と Schmidhuber (1997) が提唱。 RNN の勾配消失問題を解決し、 機械翻訳・音声認識・テキスト生成で長らく標準。 2014 年の Seq2Seq + Attention で更に強化。 2017 年の Transformer 登場で主役を譲るが、 極長系列やエッジデバイスでは現役。
LSTM 誕生の動機は「RNN を long sequence で訓練すると勾配が指数的に消える」という Hochreiter (1991) の修士論文での発見でした。 ゲート機構 (CEC: Constant Error Carousel) を導入することで誤差を 定数的に伝播 させる、 という発想を原論文の §3 で確認すると、 GRU や Highway Network、 Residual Connection への発展の連鎖が見えてきます。
🗺 適用判断フローチャート — LSTM(長短期記憶) を使うべきか
LSTM は万能ではなく、 入力形式 (時系列か否か)、 系列長 (10 / 100 / 1000 ステップ)、 並列計算の必要性、 GPU 資源、 学習データ量の 5 軸で判断します。 以下のフローチャートで Q1→Q2→Q3 を順に答えると、 LSTM・Transformer・1D CNN・GRU のどれを採用すべきかが決まります。
[START]
   ↓
Q1: 入力は時系列 / シーケンスか?
   ├ Yes (テキスト・音声・時系列)  → Q2 へ
   └ No (画像・表形式)            → CNN / 勾配ブースティング を優先

Q2: 系列長はどれくらいか?
   ├ ~10 ステップ程度       → 単純な RNN や 1D CNN で十分
   ├ 50〜数百ステップ       → LSTM 適合(長期依存をゲートで保持)
   └ 数千ステップ以上 + 並列学習 → Transformer / Mamba を検討

Q3: 計算資源と学習データは?
   ├ GPU + 大規模データ      → Transformer の方が高精度になりやすい
   ├ CPU/小〜中規模データ    → LSTM が学習しやすく実用的
   └ エッジ / 低レイテンシ要件 → LSTM (Bi-LSTM / 量子化) が現役

[END] → LSTM 採用なら本ページ「🐍 Python 実装」で PyTorch nn.LSTM へ
フローチャートで A 判定が出たら、 本ページの実装をそのまま流用できます。 別手法に分岐した場合は、 ページ末尾の「🔗 関連用語(発展)」リンクから移動してください。
🚧 よくある誤用集 — レビューで指摘される 10 パターン
LSTM を使った予測モデルを共同作業者・査読者に見せたときに、 高確率で指摘される 10 パターンを並べます。 提出前に自分のレポートと突き合わせてください。
- 時系列リーク:train/test を random split してしまい未来の情報が訓練に混入。 必ず時間順で split する。
- 標準化忘れ:入力を未スケーリングのまま投入し勾配が発散。 train 統計量で fit_transform し test に適用。
- 系列長を固定し過ぎ:長過ぎる sequence_length は勾配消失、 短すぎると長期依存を学習不能。
- 初期 hidden state の扱い:状態の持ち越しを誤り、 ミニバッチ間で勾配が伝播してしまう(stateful=True の取扱注意)。
- Bi-LSTM を未来予測に使う:双方向は文埋め込み等の用途。 リアルタイム予測では未来情報リークになる。
- Dropout の付け方:時間方向に同一マスクを使わず誤った dropout を入れる(recurrent_dropout を区別)。
- 勾配クリッピング未設定:勾配爆発で loss が NaN になる。 nn.utils.clip_grad_norm_ を入れる。
- パディングと mask:可変長系列に対し pack_padded_sequence や attention_mask を忘れて 0 を学習対象にしてしまう。
- 過剰なモデル容量:データ量に対して隠れ次元 / 層数が過大で過学習。 検証誤差で early stopping。
- Transformer 比較の省略:LSTM 単独の精度のみ報告し、 同等条件の Transformer / 1D CNN と比較しない。
10 件のうち 2-3 件は誰でもやってしまいます。 重要なのは『指摘される前に自分で潰す』姿勢です。 チェックリストを印刷して机に置いておくと事故率が激減します。
📝 報告書テンプレート — LSTM(長短期記憶) 結果の書き方
LSTM(長短期記憶) を使った分析結果を報告書・論文・スライドに載せる際のテンプレートです。 5 つの構成要素を順に埋めれば、 過不足のない記述になります。
このテンプレートを使えば、 査読プロセスでよく指摘される『方法の透明性』『限界の明示』『再現性』の 3 観点をカバーできます。
📜 歴史と背景 — LSTM(長短期記憶) のあゆみ
LSTM は、 統計学と計算機科学の流れの中から生まれました。 下の年表はこの分野全体の流れで、 LSTM 固有の年表ではありません。 この用語がどの時代の産物かを掴むために置いています。
| 時代 | 出来事・人物 | 影響 |
|---|---|---|
| 古典期(17-19 世紀) | パスカル、 ガウス、 ラプラス、 ベイズなどによる確率論・統計学の基礎構築 | LSTM(長短期記憶) を支える数学的言語の整備 |
| 近代統計期(20 世紀前半) | フィッシャー、 ピアソン、 ネイマンなどによる推測統計の確立 | LSTM(長短期記憶) の理論的基盤の形成 |
| 計算機統計期(20 世紀後半) | コンピュータの普及、 大規模数値計算、 ブートストラップ、 EM、 MCMC など | LSTM(長短期記憶) の実装が現実的に |
| 機械学習期(1990s-2010s) | SVM、 ランダムフォレスト、 勾配ブースティング、 深層学習 | LSTM(長短期記憶) と機械学習手法の融合 |
| 現代(2020s-) | 大規模言語モデル、 因果機械学習、 説明可能 AI、 公的統計のオープン化 | LSTM(長短期記憶) を含む統計手法が誰でも・どこでも使える時代に |
歴史を知ると、 各手法が『なぜそのような形をしているか』が腹落ちします。 特に新手法を学ぶときは、 既存手法との関係・歴史的経緯を併せて押さえると、 表面的な暗記を超えた理解に到達できます。
✅ 実務チェックリスト — LSTM(長短期記憶) を使う前に確認すべき 15 項目
LSTM(長短期記憶) を実務・コンペで使う前に、 以下の 15 項目をすべてチェックしてください。 1 つでも未確認なら、 結果の信頼性が大きく揺らぐ可能性があります。
📋 データ理解(5 項目)
- ☐ データの出典と取得方法を明記したか?
- ☐ 各列の意味と単位を理解したか?
- ☐ サンプルサイズと欠損率を確認したか?
- ☐ 観測期間と対象範囲を確認したか?
- ☐ 既知の偏り・サンプリングバイアスを認識したか?
🔬 適用条件(5 項目)
- ☐ LSTM(長短期記憶) の数学的仮定を一覧化し、 該当データで確認したか?
- ☐ 標準化/正規化の必要性を判断したか?
- ☐ 多重共線性を VIF などで確認したか?
- ☐ 外れ値の有無と扱い方針を決めたか?
- ☐ 検証用データを訓練データから分離したか?
📊 報告(5 項目)
- ☐ 推定値と不確実性(95% 信頼区間など)を併記したか?
- ☐ 仮定確認の結果(合格・要注意・違反)を記載したか?
- ☐ 限界と適用範囲を明示したか?
- ☐ 解釈の妥当性を 3 人以上に確認してもらったか?
- ☐ 再現可能なコードとデータの場所を示したか?
❓ FAQ — LSTM(長短期記憶) に関するよくある質問
📋 ミニ用語辞典 — LSTM(長短期記憶) 周辺で必ず出会う 20 語
LSTM(長短期記憶) を学ぶ過程で頻出する 20 の関連用語を、 1 行ずつ簡潔に定義します。 詳細はそれぞれの専用ページへリンクされています。
| 用語 | 一行定義 |
|---|---|
| RNN | 再帰結合を持つネットワーク、 LSTM の親 |
| セル状態 (c_t) | LSTM の長期記憶、 ゲートで更新される |
| 隠れ状態 (h_t) | 出力と次時刻への入力を兼ねる短期記憶 |
| 忘却ゲート (f_t) | セル状態を「どれだけ忘れるか」を 0-1 で決定 |
| 入力ゲート (i_t) | 新情報をセルに「どれだけ書き込むか」 |
| 出力ゲート (o_t) | セル状態を出力にどれだけ反映するか |
| sigmoid | ゲートの開閉量を 0-1 に圧縮 |
| tanh | セル候補・出力の値を -1〜1 に圧縮 |
| 勾配消失 | RNN が長期依存を学習できない根本問題 |
| 勾配爆発 | 勾配が発散、 gradient clipping で対処 |
| BPTT | 時間方向に展開した誤差逆伝播 |
| Truncated BPTT | 勾配計算を一定ステップで打ち切る省メモリ手法 |
| 系列長 (sequence length) | 1 サンプルあたりの時間ステップ数 |
| 埋め込み (embedding) | 離散トークンを密ベクトルに変換 |
| GRU | 2 ゲート版の LSTM、 軽量化された変種 |
| Bi-LSTM | 過去・未来両方向を結合した双方向 LSTM |
| Stacked LSTM | LSTM 層を多段に積んだ階層モデル |
| teacher forcing | 学習時に正解を入力に使う seq2seq テクニック |
| Attention | 系列内の重要位置に重みづけ、 LSTM の補強 |
| Transformer | Self-Attention で LSTM を置換した後継アーキテクチャ |
🎯 拡張版まとめ — LSTM(長短期記憶) を 1 分で復習
本ページでは LSTM(長短期記憶)(Long Short-Term Memory) を 12 セクション + 拡張 8 セクションで体系的に整理しました。 ジャストインタイム学習の原則に従い、 すべての節は独立して読めるよう設計されています。 必要な節だけ拾い読みしても OK、 通読しても OK。
- 1 行要約:ゲート機構(入力・忘却・出力)で長距離依存を学習する RNN の改良
- カテゴリ:深層学習・時系列
- 主要式:$$ f_t = \sigma(W_f \cdot [h_{t-1}, x_t] + b_f),\ c_t = f_t \odot c_{t-1} + i_t \odot \tilde{c}_t $$
- 典型データ:SSDSE-B-2026 の A1101(総人口(人))等
- 使える場面:要約・予測・最適化・生成のいずれか
- 避けるべき場面:仮定違反、 サンプル不足、 外挿、 因果主張
本ページが役に立ったら、 ページ末尾の「🔗 関連用語(前提・並列・発展)」と「📚 関連グループ教材」から次の用語に進んでください。 知識のネットワークが少しずつ広がり、 全体像が見えてきます。
🔗 隣接手法への橋渡し
LSTM は単独で時系列予測モデルを完結させるよりも、入力埋め込み (Embedding)・前段の正規化・後段の Dense + softmax と接続して初めて性能を出す。 入力長 T と隠れ次元 h が処理コストを決めるため、 上流の系列長設計・下流のロス関数選択と一体で考える。
- 上流 (前段処理): 時系列前処理 — 欠損補完・ラグ特徴・正規化で系列を整える
- 並列 (代替/比較): GRU / Transformer — 長距離依存をより効率的に扱う代替系列モデル
- 下流 (後段活用): 時系列予測評価 — RMSE / MAPE で予測精度を測定
SSDSE-B-2026 の 47 都道府県 × 年次データを月次に拡張して 12 ステップ予測する場合、上流で人口・出生・消費を [-1,1] に標準化、LSTM (h=64) で系列要約、下流で MAE / RMSE を比較する、という三層構造が現実的。
🌳 手法選択フロー
LSTM を選ぶか否かは、(1) 系列長 T が 100 を超えるか、(2) 長期依存 (50 step 以上前の情報) が必要か、(3) GPU が確保できるか、の 3 点で判定する。 T < 30 なら GRU / 単純 RNN、Transformer が使えるなら Self-Attention を優先。 以下では章 14 で挙げた前段処理・並列比較 (GRU / Transformer)・後段評価を統合した 5 段分岐で示す。
5 段分岐フローチャート (ASCII):
[Step 1] 系列データか?
   │
   ├─ No  → 回帰 / 分類 等の非時系列手法へ (終了)
   └─ Yes ↓
[Step 2] 系列長 T はどれくらいか?
   │
   ├─ T < 30          → ARIMA / 単純 RNN (軽量・解釈性○)
   ├─ 30 ≤ T ≤ 100    → LSTM / GRU (今ここ)  ← 本記事の対象
   └─ T > 100         → Transformer (Self-Attention) へ
[Step 3] 長期依存 (50 step 以上前の情報) が必要か?
   │
   ├─ No  → GRU (パラメータ少・学習速い)
   └─ Yes ↓
[Step 4] GPU が確保できるか?
   │
   ├─ No  → 隠れ次元 h=16-32 の軽量 LSTM、 CPU で訓練
   └─ Yes ↓
[Step 5] 双方向情報が使えるか? (オンライン予測か否か)
   │
   ├─ オンライン (未来不可) → 単方向 LSTM
   └─ オフライン (バッチ)    → Bi-LSTM + Attention で精度向上
        │
        └─ 後段評価: RMSE / MAE で比較 → 章 14 の評価ステップへ
各分岐の詳細条件:
- Step 1: 系列構造があるか? 時間・位置・順序のいずれかが意味を持つなら Yes。 SSDSE-B-2026 の年次データは Yes。
- Step 2: 系列長 T の閾値判定。 T<30 は ARIMA、 30≤T≤100 が LSTM の主戦場、 T>100 は Transformer。 都道府県人口の 30 年データなら LSTM 領域。
- Step 3: 長期依存の必要性。 50 step 前の情報 (例: 2010 年人口が 2026 年予測に効く) が必要なら LSTM。 直近 5 期だけで十分なら GRU で速度優先。
- Step 4: GPU リソース判定。 GPU 無しでも h=16-32、 層数 1、 バッチ 32 程度なら CPU で訓練可能 (47 都道府県なら数分)。
- Step 5: 双方向の可否。 オフラインで全系列が見えるなら Bi-LSTM + Attention で 10-30% 精度向上。 リアルタイム予測 (未来情報不可) なら単方向のみ。
実際の予測タスクでは LSTM 単独でなく、Bi-LSTM・Attention 付き LSTM・Seq2Seq まで段階的に拡張するのが定石で、SSDSE-B-2026 の県別人口推移なら h=32 の 1 層から始めて検証 MAE を観察し、 章 14 で挙げた RMSE / MAPE で Transformer と比較するのが標準ワークフロー。
🎮 触って理解する
LSTM の数理的核心は ゲート機構によるセル状態の更新 です。 数式を眺めるだけでは掴みにくい「ゲート=情報の弁」「セル状態=長期記憶のベルトコンベア」という感覚を、 実際にスライダーを動かして体感しましょう。 すべてブラウザ内だけで計算されます(外部通信なし)。
A. 1 ステップの LSTM セルを解剖する
前セル状態 $c_{t-1}$ と、 各ゲートの前活性(logit)を動かすと、 忘却 $f=\sigma(z_f)$・入力 $i=\sigma(z_i)$・出力 $o=\sigma(z_o)$・候補 $g=\tanh(z_g)$ が計算され、 $c_t = f\odot c_{t-1} + i\odot g$、 $h_t = o\odot\tanh(c_t)$ がリアルタイムに更新されます。 ここでは 1 次元(スカラー)で挙動を可視化します。
- 「忘却を閉じる($f\to0$)」を押すと、 過去 $c_{t-1}$ の寄与 $f\cdot c_{t-1}$ が 0 になり、 セル状態が過去を捨てる。
- 「入力を閉じる($i\to0$)」を押すと、 新情報 $i\cdot g$ が 0 になり、 新しい入力を一切取り込まない($c_t$ は前状態を保持)。
- $z_f$ を大きく($f\approx1$)・$z_i$ を小さく($i\approx0$)すると、 $c_t\approx c_{t-1}$ ── これが「記憶をそのまま運ぶベルトコンベア」の状態。
B. 系列を流す ── 長期記憶は保たれるか
ステップ 2 で「記憶したい値」を 1 回だけ入力(インパルス)し、 以降は入力ゼロで走らせます。 忘却ゲート $f$ をどれだけ開けておくかで、 セル状態 $c_t$ が何ステップ先まで情報を保つかが決まります。 比較のため、 通常 RNN(固定重み $w=0.7$ の再帰)が同じインパルスを指数的に忘れていく様子も重ねて表示します。
🧭 もう一歩ふみこむ ── 直感・落とし穴・発展
関連ページ:RNN(再帰型ニューラルネット)、 Transformer、 勾配降下法。 なお GRU の独立ページは本用語集には未整備のため、 本ページ内の記述を参照してください。